Harness de IA é o programa que fica em volta de um modelo de linguagem e deixa ele agir: criar e editar arquivos, rodar comandos, testar o que fez e tentar de novo. É o que transforma um chat em agente. A pergunta que todo mundo que roda IA no próprio PC acaba fazendo é se vale a pena colocar o modelo local dentro de um harness, ou se é melhor só pedir no chat e pegar a resposta pronta.
A gente testou. No Laboratório de IA, 11 modelos locais fizeram os mesmos 4 jogos de duas formas: numa tentativa só, sem ferramentas, e dentro de um harness, com até 80 minutos para trabalhar. Foram 44 comparações com a mesma correção automática. No modo agente, os 11 também passaram pelo teste AGENTE, uma tarefa de programação com testes que só existe com ferramentas. Neste texto: o que é harness em palavras simples, o que os números mostraram, como saber se um modelo foi feito para usar ferramentas e quando cada modo compensa.
O que é harness de IA (significado)
Em uma frase: o harness é tudo o que não é o modelo. O modelo pensa e escreve; o harness dá a ele mãos, memória e um lugar para trabalhar. A fórmula mais citada é agente = modelo + harness. A palavra vem do inglês e quer dizer arreio, o equipamento que guia um cavalo: o modelo tem força, o harness decide para onde ela vai.
Na prática, um harness reúne algumas peças:
- Ferramentas: ler e salvar arquivos, editar trechos, rodar comandos no terminal, abrir um navegador.
- Loop de trabalho: o modelo pede uma ação, o harness executa e devolve o resultado, e o modelo decide o próximo passo.
- Memória e contexto: o que o modelo já fez e o que precisa lembrar para continuar.
- Regras e limites (guardrails): o que pode e o que não pode ser feito, e em que pasta.
- Registro: o histórico das ações, para alguém conferir depois.
Exemplos conhecidos são o Claude Code, o Codex CLI, o Aider, o Cline e o OpenCode. O termo ficou popular em 2026 com a ideia de “engenharia de harness”, que Mitchell Hashimoto, cofundador da HashiCorp, usou para descrever o próprio trabalho com IA: quando o agente erra, você muda o ambiente em volta dele para o erro não se repetir. Não confunda com test harness, o conjunto que roda testes de software, nem com evaluation harness, que mede a qualidade de um modelo.
Como testamos: o mesmo modelo no chat e no harness
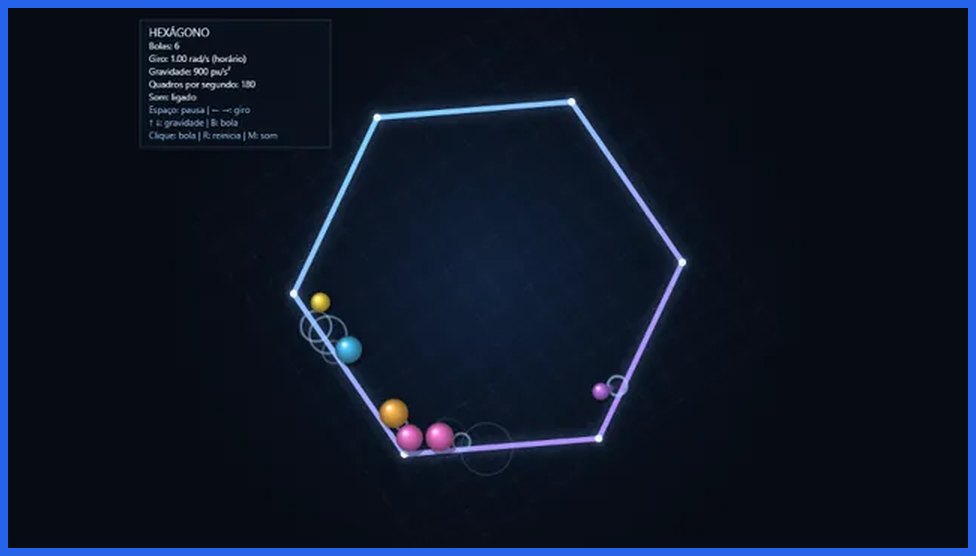
Cada um dos 11 modelos fez 4 jogos do Laboratório: VOO LIVRE (o do passarinho), HEXÁGONO (bolas quicando num hexágono que gira), BOMBA LAB (estilo Bomberman) e CORREDOR 3D. O pedido era o mesmo nos dois modos, e o jogo final passou pela mesma correção automática, que abre o jogo, aperta as teclas e confere se cada regra funciona. Um problema que impede jogar conta como grave.
| Sem ferramentas (chat) | No harness (agente) | |
|---|---|---|
| Como funciona | O modelo escreve o jogo inteiro numa resposta, sem testar | O modelo cria o arquivo, edita, roda testes e corrige, em várias rodadas |
| Tentativas | 1 | Quantas couberem em 80 minutos (40 nas primeiras execuções) |
| Programa | O próprio servidor do llama.cpp | Um harness de terminal (o OMP), ligado ao mesmo servidor |
| Modelo, quantização e contexto | Os mesmos | Os mesmos |
Além dos jogos, o modo agente tem um teste só dele, o AGENTE: o modelo recebe a tarefa de criar um leitor de planilhas CSV em JavaScript, escrever os testes para cinco casos difíceis (vírgula dentro de aspas, aspas escapadas, quebra de linha dentro do campo, finais de linha misturados e campos vazios), rodar os testes e corrigir o código até tudo passar, sem mexer nos testes. É o uso que mais se parece com um assistente de programação de verdade, e não tem versão de chat: sem ferramentas, o modelo não consegue rodar nada.
Resultado: o harness ajuda, mas menos do que parece e não para todos
Na soma dos 44 jogos, o harness entregou mais jogos sem problema grave (16 contra 11) e uma nota média um pouco maior (44,7 contra 38,3, numa escala de 0 a 100). Mas ele ganhou em 17 comparações, perdeu em 15 e empatou em 12. E levou quase quatro vezes mais tempo.
| Na soma dos 44 jogos | Sem ferramentas | No harness |
|---|---|---|
| Jogos sem problema grave | 11 (25%) | 16 (36%) |
| Nota média (0 a 100) | 38,3 | 44,7 |
| Tempo médio por jogo | 14,1 min | 52,6 min |
| Jogo não entregue (sem arquivo no fim) | 0 | 7 |
| Comparações vencidas | 15 | 17 (12 empates) |
Os sete jogos não entregues mostram um risco típico do agente: ele gasta o tempo explorando, testando e reescrevendo, e o relógio acaba antes de existir um arquivo final. No modo chat, isso não acontece, porque a resposta é o próprio jogo. Em 19 das 56 execuções no harness, o modelo bateu no teto de tempo ainda trabalhando.
No teste AGENTE, o quadro é outro: os 11 modelos terminaram a tarefa com nota máxima, entre 1 e 14 minutos. Só o Qwen3.5-9B tirou 8,3 numa das duas execuções (e 10 na outra). Ou seja, numa tarefa curta, clara e com teste pronto para conferir, todos os modelos locais que testamos já trabalham bem como agente. O que separa os modelos são as tarefas longas, como um jogo inteiro, em que o agente precisa planejar, testar e não estragar o que já funcionava.
| Teste AGENTE (no harness) | Resultado |
|---|---|
| Modelos que terminaram com nota 10 | 11 de 11 (o Qwen3.5-9B tirou 10 e 8,3 em duas execuções) |
| Tempo | de 0,9 min (Qwen3.6 35B) a 14,2 min (Gemma 4 12B) |
| Harness | OMP; o Ornith 35B e o Ornith 9B também rodaram no OpenCode, com nota 10 nos dois |
Agente de IA local: quais modelos aproveitam o harness
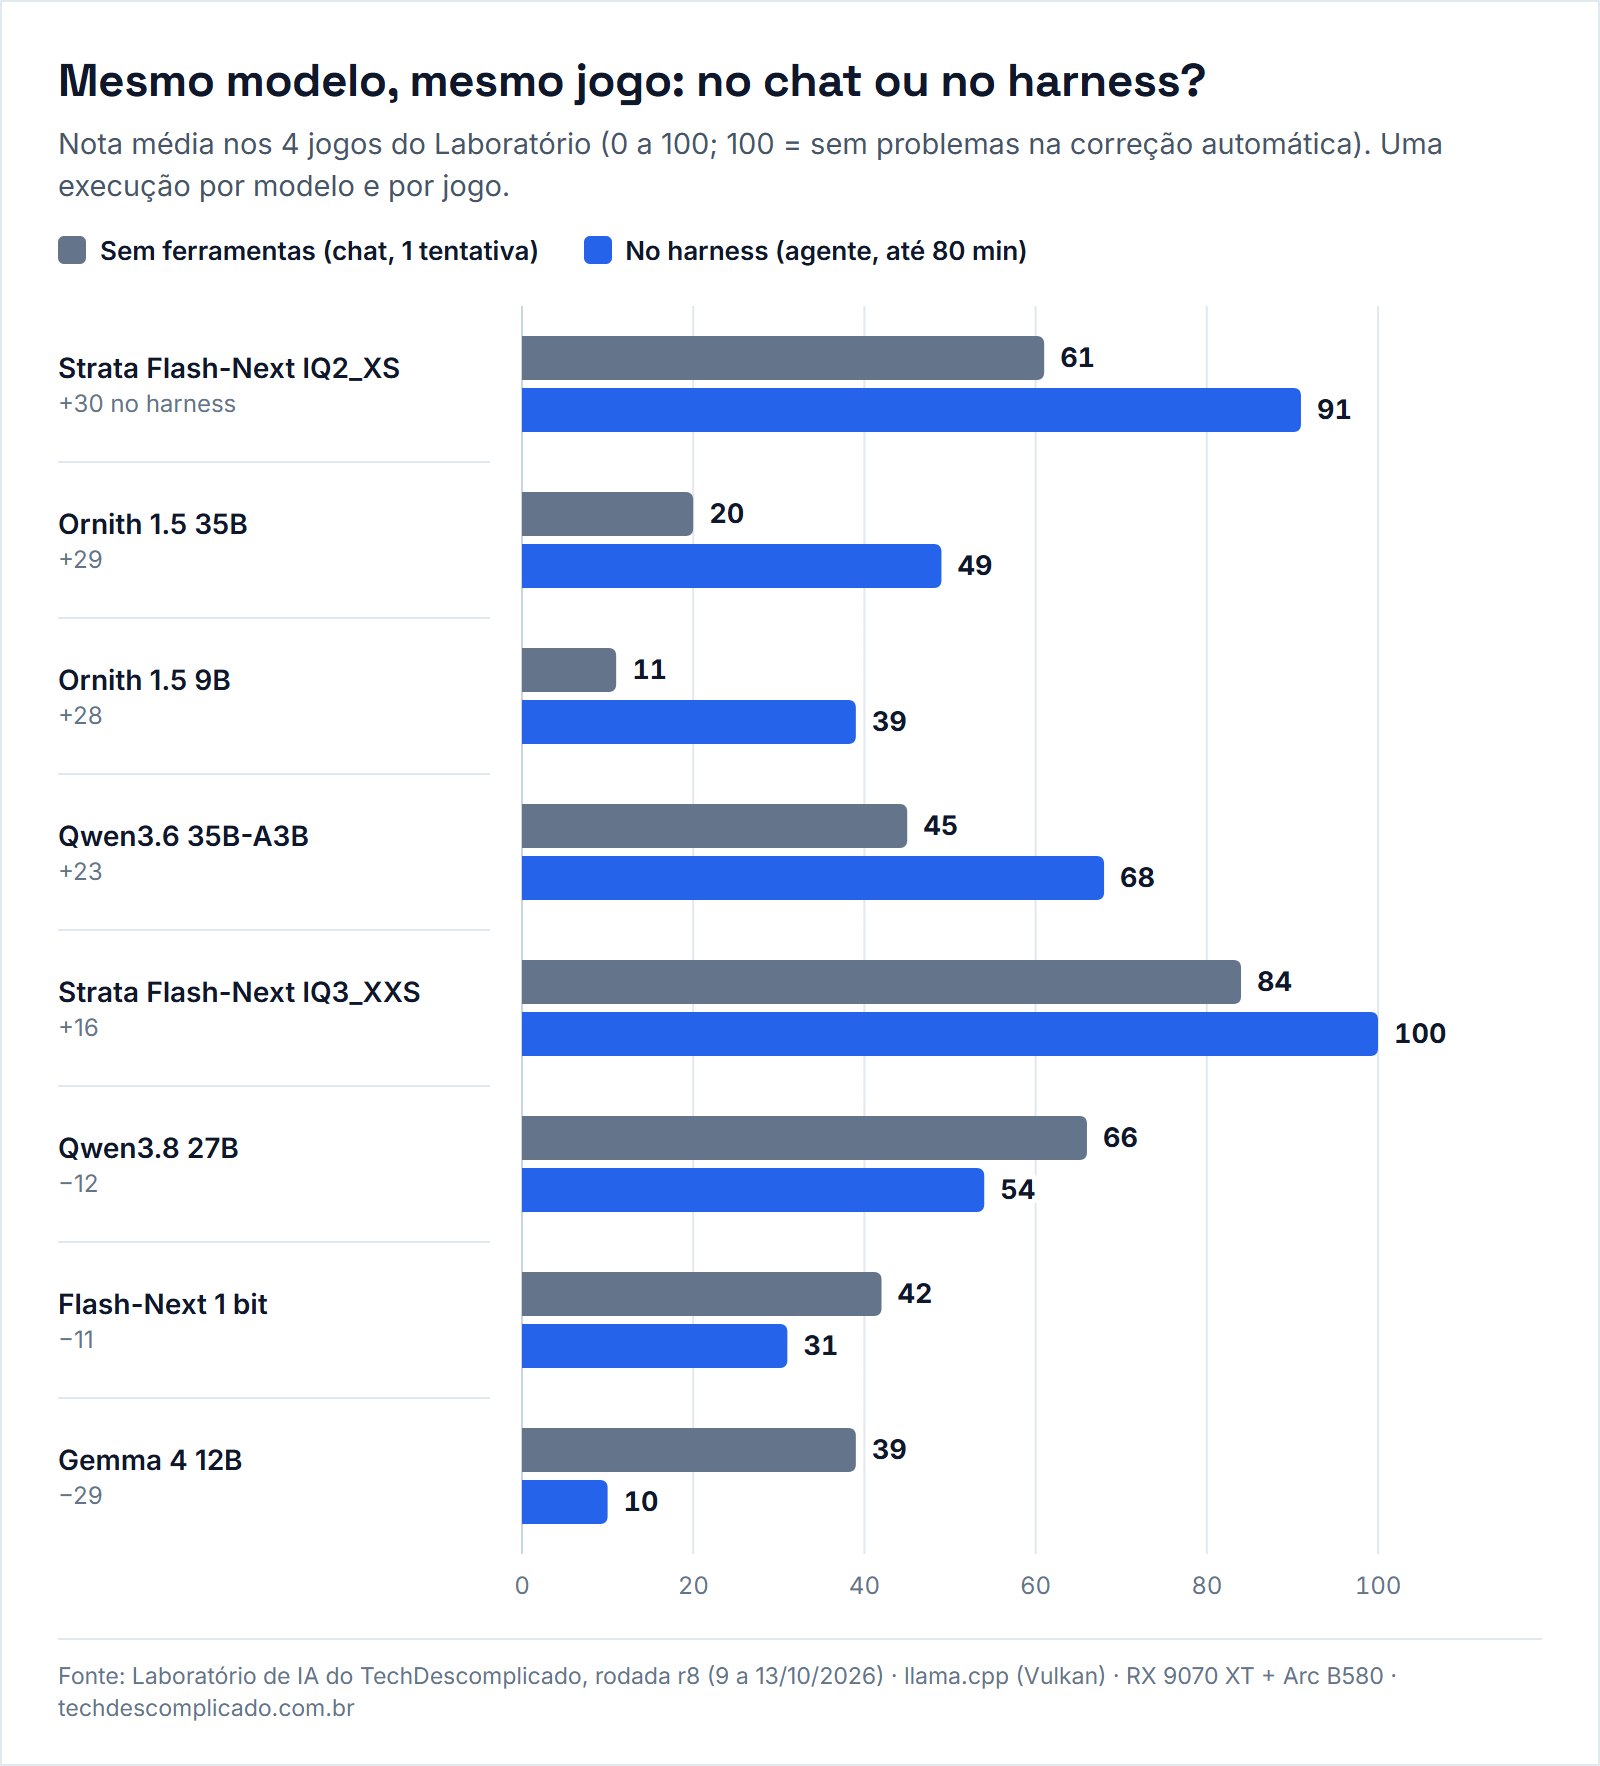
A média esconde a parte mais interessante: alguns modelos ficam muito melhores no harness, outros pioram. A nossa leitura, que ainda precisa de mais rodadas para virar conclusão, é que pesa quanto cada modelo foi treinado para trabalhar com ferramentas.
| Modelo (nota média nos 4 jogos) | Sem ferramentas | No harness | Diferença |
|---|---|---|---|
| Strata Qwen3.8-Flash-Next IQ2_XS | 61 | 91 | +30 |
| Ornith 1.5 35B | 20 | 49 | +29 |
| Ornith 1.5 9B | 11 | 39 | +28 |
| Qwen3.6 35B-A3B | 45 | 68 | +23 |
| Strata Qwen3.8-Flash-Next IQ3_XXS | 84 | 100 | +16 |
| Gemma 4 26B | 19 | 21 | +2 |
| Qwen3.5-9B | 2 | 1 | −1 |
| Qwen3-Coder-Next 80B | 31 | 28 | −3 |
| Qwen3.8-Flash-Next 1 bit | 42 | 31 | −11 |
| Qwen3.8 27B | 66 | 54 | −12 |
| Gemma 4 12B | 39 | 10 | −29 |
Entre os que mais ganham estão as duas versões do Ornith, especializadas em programação e agentes, e os Strata, que já chegam perto de acertar de primeira e usam o harness para lapidar. Os que perdem caem em dois tipos de erro que a gente viu nos registros: o “mexe e quebra”, quando o modelo tinha um jogo funcionando e estraga ao tentar melhorar, e o tempo gasto em ferramenta sem chegar a um arquivo final. Por causa do primeiro, o Laboratório passou a avaliar a melhor versão que o modelo gravou, e não só a última.
Como saber se o modelo foi treinado para usar ferramentas (tools)
Antes de colocar um modelo local num harness, vale conferir duas coisas que aparecem na própria página dele. A primeira é se ele foi treinado para chamar ferramentas, o que em inglês aparece como tool use, tool calling ou function calling. É essa habilidade que deixa o modelo pedir ao harness “salve este arquivo” ou “rode este comando” no formato certo. A segunda é para que o modelo foi feito: conversa, programação, agentes, visão. Juntas, as duas respostas já dizem se ele vai render mais no chat ou no modo agente.
- LM Studio: na página do modelo aparece o selo Trained for Tool Use (treinado para usar ferramentas), ao lado de outros, como visão e raciocínio.
- Ollama: na biblioteca de modelos, quem aceita ferramentas leva a etiqueta tools.
- Hugging Face: o cartão do modelo costuma dizer se ele faz tool calling ou function calling e para que tipo de tarefa foi treinado (código, agentes, conversa).
- Mensagem de erro: se o programa avisar algo como tool calling is not supported with this model, o modelo não declara suporte a ferramentas. Troque de modelo ou de versão antes de culpar o harness.
Na nossa bancada, os modelos que mais ganharam no harness foram justamente os descritos como feitos para programação e agentes, como os dois Ornith. Já o Gemma 4 12B, um modelo de uso geral, rendeu mais escrevendo direto no chat.
Cada harness usa as ferramentas de um jeito
O harness também muda o resultado, não só o modelo. Rodamos parte dos testes em dois harnesses diferentes, o OMP e o OpenCode, ligados ao mesmo servidor e ao mesmo modelo, e eles se comportam de formas bem distintas:
| OMP | OpenCode | |
|---|---|---|
| Jeito de editar arquivo | Formato próprio, com marcações de trecho | O formato mais comum (“troque este texto por aquele”), que os modelos conhecem do treino |
| Erros no formato da ferramenta | Frequentes em alguns modelos: o Qwen3-Coder-Next errou 49 e 16 vezes em dois jogos | Nenhum nas execuções que registramos |
| Efeito do erro | Retrabalho: num mesmo jogo, o Coder-Next fez 150 chamadas e levou 56 min | O mesmo jogo saiu em 38 chamadas e 31 min |
| Instruções que ocupam o contexto antes da 1ª pergunta | cerca de 4,5 mil tokens | cerca de 9 mil tokens |
Na prática, um harness que “fala a língua” do modelo evita retrabalho, mas pode gastar mais memória de conversa logo de saída, o que pesa em placas de vídeo menores. A escolha do harness também deve combinar com o modelo. Os números dos jogos deste artigo vêm todos do OMP, para que os 11 modelos fossem comparados na mesma ferramenta.
No chat ou no harness: quando usar cada um
Para um pedido que cabe numa resposta, como um script, uma função ou uma página simples, o chat costuma bastar: é quase quatro vezes mais rápido e, com vários modelos, a primeira tentativa já vem boa. O harness compensa quando o trabalho precisa de várias etapas, de testar e corrigir, ou de mexer em arquivos que já existem, e quando o modelo foi treinado para isso.
- Use o chat para tarefas curtas, com modelos menores ou quando o tempo importa.
- Use o harness para tarefas longas, com modelos de código ou treinados para agir, e com um teto de tempo definido.
- Sempre guarde as versões intermediárias: o melhor resultado nem sempre é o último.
- Contexto conta: o harness envia instruções e o histórico das ferramentas a cada passo, então ele pede uma janela de contexto maior e mais memória de vídeo.
Se você está começando com IA no PC, o primeiro passo está em como rodar IA localmente no PC. Para quem já tem um agente e quer saber se ele é confiável, o roteiro de como testar agente de IA ajuda a montar as próprias verificações. E modelos novos feitos para agir, como o JetBrains Mellum 2.1, são candidatos naturais ao modo harness.
O olhar de QA
“Dá a ferramenta que ele se vira” é o conselho que mais aparece quando o assunto é agente de IA, e os nossos 44 jogos mostram que não é bem assim. Ferramenta na mão de quem não sabe usar vira atraso: o Gemma 4 12B, por exemplo, entregava jogos melhores escrevendo direto do que tentando testar e corrigir. O que eu tiro disso para o dia a dia é parecido com o que vale para gente: antes de dar autonomia, confira se o modelo foi treinado para trabalhar daquele jeito, defina um prazo e guarde o que já estava funcionando. E desconfie do agente que passa o tempo todo rodando teste e não entrega nada; teste que não termina em entrega não é qualidade, é ocupação. Um cuidado com a leitura: cada número aqui é uma execução por modelo e por jogo, e uma nova rodada pode mudar a ordem de alguns modelos.
Perguntas frequentes sobre harness de IA
O que é harness de IA?
É o programa em volta do modelo de linguagem que permite que ele aja: usar ferramentas, ler e salvar arquivos, rodar comandos, guardar memória e seguir regras. A fórmula mais usada é agente = modelo + harness.
Qual o significado de harness?
Harness quer dizer arreio em inglês, o equipamento que guia um cavalo. Na IA, o modelo é a força e o harness é o que direciona essa força para uma tarefa.
Quais são exemplos de harness de IA?
Claude Code, Codex CLI, Aider, Cline, OpenHands e OpenCode são exemplos de harness para programação. Todos ligam um modelo a ferramentas como terminal e edição de arquivos.
Qual a diferença entre harness e framework?
Frameworks como LangChain, AutoGen e CrewAI são bibliotecas para montar agentes. O harness é o ambiente que executa o agente, com ferramentas, limites e registro, e pode usar um framework por dentro.
O que é tool calling?
É a chamada de ferramentas: a capacidade de o modelo pedir, num formato combinado, que o programa execute uma ação, como ler um arquivo, rodar um comando ou buscar na internet. No LM Studio, os modelos com essa habilidade levam o selo Trained for Tool Use; no Ollama, a etiqueta tools.
Dá para usar harness com modelo local?
Dá. Harnesses como o OpenCode e o Aider aceitam servidores compatíveis com a API da OpenAI, como o llama.cpp, o Ollama e o LM Studio. No nosso teste, 11 modelos locais rodaram num harness de terminal ligado ao llama.cpp.
Vale a pena usar modelo local no harness?
Depende do modelo e da tarefa. No nosso teste, o harness entregou mais jogos sem problema grave (16 de 44 contra 11 de 44), mas levou quase quatro vezes mais tempo, e alguns modelos pioraram. Modelos de código e treinados para agir são os que mais ganham.
Você usa o seu modelo local no chat ou dentro de um agente? Conta aqui nos comentários.
Resumo
- Harness de IA é o programa em volta do modelo que dá ferramentas, memória e regras: agente = modelo + harness.
- Testamos 11 modelos locais nos mesmos 4 jogos, no chat (uma tentativa) e num harness (até 80 minutos), com a mesma correção automática.
- No harness: 16 de 44 jogos sem problema grave e nota média 44,7; no chat: 11 de 44 e 38,3. O harness ganhou 17 comparações, perdeu 15 e empatou 12.
- O harness levou 52,6 min por jogo, contra 14,1 min no chat, e 7 jogos não foram entregues.
- Strata, Ornith e Qwen3.6 ganham de 16 a 30 pontos no harness; Gemma 4 12B, Qwen3.8 27B e o Flash-Next de 1 bit pioram.