Os mini PCs com processador AMD Ryzen AI Max+ 395 (apelidado de “Strix Halo”) viraram febre entre quem roda IA em casa. A promessa é tentadora: uma caixinha do tamanho de um livro, com 128 GB de memória que o processador e o vídeo usam juntos, capaz de carregar modelos que não caberiam em nenhuma placa de vídeo comum. Mas um mini PC para IA local vale a pena mesmo, ou duas placas de vídeo entregam mais pelo mesmo dinheiro?
Não temos um desses na bancada. Então fiz o que dá para fazer com honestidade: juntei medições de fontes que testaram de verdade e comparei com os números da nossa bancada (uma Radeon RX 9070 XT de 16 GB junto com uma Intel Arc B580 de 12 GB). O resultado é mais interessante do que um simples “sim” ou “não”.
O segredo está na velocidade da memória, não no tamanho
Para gerar cada palavra, o modelo precisa ler da memória todos os números que usa naquele passo. Por isso, o que define a velocidade é a largura de banda: quantos gigabytes por segundo a memória consegue entregar. Tamanho diz o que cabe. Largura de banda diz quão rápido roda.
| Equipamento | Memória para IA | Largura de banda |
|---|---|---|
| Mini PC Ryzen AI Max+ 395 | até 128 GB (cerca de 96 GB para o vídeo) | 256 GB/s no papel, cerca de 215 GB/s medidos |
| NVIDIA DGX Spark | 128 GB | 273 GB/s |
| Mac Studio M4 Max | até 128 GB | até 546 GB/s |
| Radeon RX 9070 XT (uma das placas da nossa bancada) | 16 GB | cerca de 640 GB/s |
Uma placa de vídeo dedicada tem memória bem mais rápida, só que pequena. O mini PC tem memória enorme, só que mais lenta. Qual vence depende do tipo de modelo.
Modelo denso ou MoE: é aqui que a comparação vira
Um modelo denso usa todos os parâmetros a cada palavra. Um modelo MoE (“mistura de especialistas”) usa só uma fatia pequena de cada vez. Na prática, o MoE lê muito menos memória por palavra, e é aí que o mini PC brilha.
| Modelo | Mini PC Strix Halo | Nossa bancada (28 GB em 2 placas) |
|---|---|---|
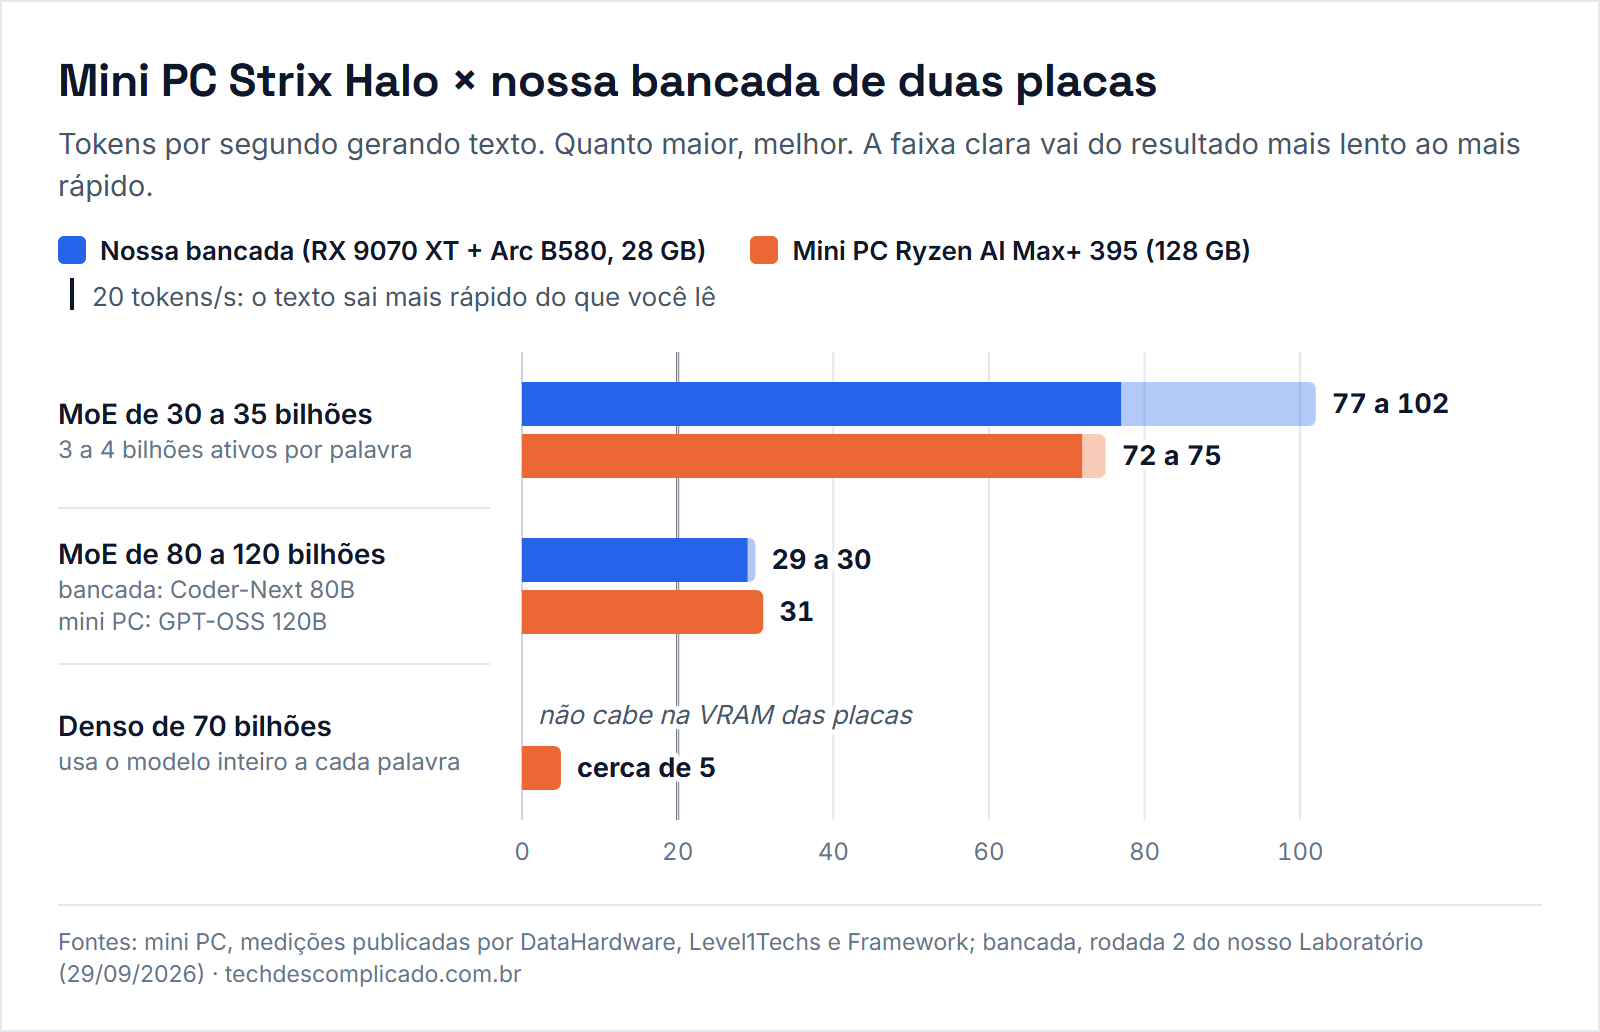
| MoE de 30 a 35 bilhões (3 a 4 bilhões ativos) | 72 a 75 tokens/s (Qwen3-30B-A3B) | 77 a 102 tokens/s (Qwen3.6-35B-A3B, Gemma 4 26B-A4B, Ornith 35B) |
| Denso de 27 bilhões | não encontramos medição confiável | 27 a 33 tokens/s (Qwen3.8-27B, com MTP) |
| Denso de 70 bilhões | cerca de 5 tokens/s | não cabe na VRAM |
| MoE de 80 a 125 bilhões | 31 tokens/s (GPT-OSS 120B, inteiro na memória) | 29 a 30 tokens/s (Qwen3-Coder-Next 80B) e 19 a 20 tokens/s (Qwen3.8 Flash-Next 125B em 1 bit), dividindo com a RAM |
Para ter uma referência: acima de uns 20 tokens por segundo, o texto aparece mais rápido do que você lê. Abaixo de 10, dá para usar, mas cansa. E 5 tokens por segundo, num trabalho do dia a dia, é esperar a resposta como quem espera uma impressora antiga.
Atualização de 7 de outubro: depois desta comparação, testamos o mesmo Qwen3.8-Flash-Next de 125 bilhões com o Strata, um programa que roda o modelo com uma placa só e deixa o resto na RAM. Com uma RX 9070 XT de 16 GB e 64 GB de RAM, ele chegou a uma média de 48 a 63 tokens por segundo, conforme a versão, bem acima dos 19 a 20 da tabela e dos 31 do mini PC no modelo de 120 bilhões. Os detalhes estão no teste do Qwen3.8-Flash-Next no PC de casa.
O que isso quer dizer, sem rodeio
- Para modelos densos grandes, o mini PC decepciona. Carregar um modelo de 70 bilhões é possível, mas a 5 tokens por segundo não serve para trabalhar. É a crítica mais comum, e ela procede: muita memória, pouca velocidade.
- Nos modelos MoE médios, a bancada de placas de vídeo passou à frente. Depois de ajustarmos a configuração de cada modelo, as duas placas chegaram a 77 a 102 tokens/s, contra 72 a 75 do mini PC. Nos MoE bem grandes, que numa placa comum precisam dividir espaço com a RAM, a disputa fica praticamente empatada: 29 a 30 tokens/s no nosso Coder-Next de 80 bilhões contra 31 do mini PC num modelo de 120 bilhões.
- Ele é mais lento para “ler” textos longos. Antes de começar a responder, o modelo processa tudo o que você enviou. Em equipamentos de memória unificada, essa etapa costuma ser mais lenta que numa placa dedicada. Isso pesa em quem usa IA para programar, mandando arquivos inteiros de código.
- Vantagens reais: silencioso, pequeno, consome muito menos energia que um PC com duas placas e já vem pronto.
E o preço no Brasil?
Aqui está o maior problema. Nos Estados Unidos, os modelos com 128 GB (como o GMKtec EVO-X2) saíram entre US$ 1.800 e US$ 2.600. No Brasil, não encontramos venda oficial: o caminho é importar, pagando imposto de importação e ICMS, ou comprar de revendedores de importados, com preços muito acima. Encontramos anúncio passando de R$ 50 mil, o que não faz sentido nenhum.
Para comparar: as duas placas da nossa bancada custam hoje cerca de R$ 7.500 somadas (uma RX 9070 XT a partir de R$ 5.159 e uma Arc B580 a partir de R$ 2.350). Mas a nossa combinação é só uma das possíveis.
A alternativa: somar placas de vídeo
Os programas de IA local, como o llama.cpp, conseguem repartir um modelo entre duas ou mais placas: cada uma guarda um bloco de camadas e a VRAM das duas é somada. Dá para fazer isso com placas iguais ou de marcas diferentes, como a nossa Radeon com uma Intel. A escolha depende do orçamento, do que você já tem em casa e do tamanho dos modelos que quer rodar.
| Combinação | VRAM somada | Custo aproximado (29/09) | Observação |
|---|---|---|---|
| 2× Intel Arc B580 (12 GB) | 24 GB | R$ 4.700 | o caminho mais barato até 24 GB |
| 2× Radeon RX 9060 XT 16 GB | 32 GB | R$ 6.660 | melhor preço por GB para chegar a 32 GB |
| RX 9070 XT + Arc B580 (a nossa bancada) | 28 GB | R$ 7.500 | marcas diferentes juntas, pelo Vulkan |
| 2× GeForce RTX 5060 Ti 16 GB | 32 GB | R$ 8.250 | mais cara, mas com o CUDA, o ecossistema mais suportado |
| 2× GeForce RTX 5060 (8 GB) | 16 GB | R$ 5.070 | não compensa: uma única RX 9060 XT de 16 GB custa R$ 3.330 |
Algumas regras práticas para escolher:
- Placas iguais são o caminho mais simples: o modelo se divide por igual e você usa o motor nativo da marca (CUDA na NVIDIA, ROCm ou Vulkan na AMD, SYCL ou Vulkan na Intel).
- Marcas diferentes funcionam pelo Vulkan, que conversa com AMD, Intel e NVIDIA ao mesmo tempo. É uma boa forma de aproveitar a placa que você já tem e comprar só a segunda.
- Duas placas pequenas nem sempre valem mais que uma grande. Faça a conta do preço por GB antes: duas de 8 GB costumam sair mais caras que uma de 16 GB.
- Confira a fonte. Duas placas somam o consumo. Uma dupla de placas intermediárias pede uma fonte de 750 a 850 W de boa qualidade.
Antes de comprar a segunda placa: olhe a placa-mãe
A placa-mãe precisa de dois slots PCI Express x16 físicos, com espaço entre eles para as duas placas respirarem. O ideal é o slot principal trabalhando em x16 e o secundário em x8 ou x4. Muitas placas-mãe têm o segundo slot com tamanho de x16, mas ligado em x4 ou até x1 pelo chipset: o manual informa isso na tabela de “PCIe lanes”.
Por que isso importa? Quando o modelo já está carregado, as placas trocam pouca informação entre si, e um slot x4 dá conta com folga. O problema de um slot estreito, como x1 ou x2 (comum em adaptadores e slots do chipset), aparece em outros momentos: o modelo demora bem mais para carregar, a leitura de textos longos fica mais lenta e os modos que dividem cada camada entre as placas deixam de compensar. Para quem usa IA para programar, mandando arquivos inteiros, essa diferença pesa.
Só tem notebook? Uma placa externa resolve
Se o seu notebook (ou PC) tem uma porta Thunderbolt 3, Thunderbolt 4 ou USB4, dá para ligar uma placa de vídeo de mesa numa caixa externa, a chamada eGPU. A conexão equivale a um slot PCI Express x4. Pelo mesmo motivo de antes, a velocidade de geração fica perto da que a placa teria dentro do gabinete; o carregamento do modelo e a leitura de textos longos é que ficam mais lentos. Se o notebook já tiver uma placa de vídeo própria, os programas conseguem usar as duas juntas, somando a VRAM. É uma saída interessante para quem só tem notebook e quer rodar modelos maiores sem montar um PC novo. A caixa externa é comprada à parte.
Para quem vale a pena
| Seu perfil | Melhor caminho |
|---|---|
| Quer rodar modelos MoE grandes (80 a 120 bilhões) sem barulho, e consegue importar | Mini PC Strix Halo |
| Programa com IA, mandando muito código de uma vez | Placa de vídeo dedicada (mais rápida para processar textos longos) |
| Quer modelos densos de 27 a 70 bilhões com boa velocidade | Placas de vídeo com bastante VRAM; o mini PC fica lento demais |
| Só tem notebook com Thunderbolt ou USB4 | Placa de vídeo externa (eGPU) numa caixa Thunderbolt |
| Já tem um PC e quer gastar pouco | Uma placa de 12 a 16 GB: veja o nosso guia de quanta VRAM você precisa |
Perguntas frequentes sobre mini PC para IA local
Mini PC roda IA local?
Roda, e os modelos com Ryzen AI Max+ 395 e 128 GB de memória carregam modelos enormes. O ponto fraco é a velocidade em modelos densos grandes: cerca de 5 tokens por segundo num modelo de 70 bilhões. Nos modelos MoE, ele vai bem, na faixa de 72 a 75 tokens por segundo nos de 30 bilhões.
Qual o melhor mini PC para IA local?
Hoje, os com AMD Ryzen AI Max+ 395 (“Strix Halo”) e 128 GB, como o GMKtec EVO-X2, são os mais procurados para isso. Não temos um na bancada; os números deste artigo vêm de quem testou. O que decide é a largura de banda da memória, não só o tamanho.
Quanto custa montar um PC para IA local?
Depende de quanta VRAM você quer. Uma Intel Arc B580 de 12 GB sai a partir de R$ 2.289. Duas placas somando 24 a 32 GB ficam entre R$ 4.700 e R$ 8.250 (preços de 29/09). O mini PC com 128 GB não tem venda oficial no Brasil e, importado, fica bem mais caro.
Mini PC ou placa de vídeo para IA local?
Para programar com IA e para modelos densos, placa de vídeo. Para rodar modelos MoE gigantes em silêncio e gastando pouca energia, o mini PC, se você conseguir importar por um preço razoável. Para escolher a placa, veja quanta VRAM você precisa para IA local.
Resumo rápido
- Tamanho da memória diz o que cabe; largura de banda diz a velocidade.
- O mini PC Strix Halo é ótimo para modelos MoE e fraco para modelos densos grandes (cerca de 5 tokens/s num 70B).
- Nos modelos MoE de 30 a 35 bilhões, a nossa bancada de duas placas ficou cerca de 20% mais rápida, em média, depois do ajuste fino; nos MoE gigantes, os dois empatam.
- No Brasil, o preço de importação ainda pesa contra ele.
Os números da nossa bancada, modelo a modelo, estão no Laboratório de IA. Se um dia um mini PC desses chegar aqui, ele entra na mesma bateria de testes.
Fontes
- Medições próprias: rodada 2 da bateria do Laboratório de IA, 29/09/2026, com a configuração padronizada de cada modelo.
- DataHardware: Strix Halo, tokens por segundo, denso × MoE (2026)
- Level1Techs: resultados de benchmark do Strix Halo
- Comunidade Framework: testes de LLM no Framework Desktop
- Starry Hope: mini PCs Strix Halo para inferência local (2026)
- GMKtec: página oficial do EVO-X2
- Hardware Barato: preços de placas de vídeo (29/09/2026)
- llama.cpp: documentação oficial de uso com várias placas
- eGPU.io: impacto da conexão da placa externa em IA local