Se você quer rodar inteligência artificial no próprio computador, a pergunta que decide a compra não é “qual placa é mais rápida em jogos”. É outra: quanta memória de vídeo (VRAM) ela tem. É a VRAM que define quais modelos cabem, com quanto espaço para conversa e em que velocidade. Então, quanta VRAM você precisa para IA local? A resposta curta: 12 GB para começar a sério, 16 GB para o melhor custo-benefício e 24 GB ou mais para os modelos grandes. A resposta completa, com o porquê, vem abaixo.
Este guia responde com dados de verdade: os modelos que testamos na nossa bancada (uma Radeon RX 9070 XT de 16 GB junto com uma Intel Arc B580 de 12 GB), a regra que quase todo mundo esquece na hora de calcular e os preços em reais de hoje.
Por que a VRAM manda
Um modelo de IA é, na prática, um arquivo gigante de números. Para responder rápido, ele precisa estar inteiro na memória da placa de vídeo, que é muito mais veloz que a memória RAM comum. Quando não cabe, parte vai para a RAM e a velocidade despenca.
Pense na VRAM como a bancada de um marceneiro: o que está na bancada, ele usa na hora. O que ficou no depósito (a RAM), ele tem que ir buscar a cada passo.
A regra que quase todo mundo esquece: o peso não é tudo
O tamanho do arquivo do modelo é só a primeira parte da conta. A VRAM também precisa guardar o contexto: a conversa, o documento ou o código que você pede para ele analisar. Quanto maior o contexto, mais memória.
Conta de bolso: VRAM necessária ≈ tamanho do arquivo do modelo + contexto + 1 a 2 GB de sobra. Em conversas longas, o contexto pode chegar perto do tamanho do próprio modelo.
Vimos isso na prática: com um modelo grande dividido entre placa e RAM, aumentar o contexto de 16 mil para 32 mil tokens encheu a RX 9070 XT até 15,3 dos 16 GB. Existem truques para economizar, como comprimir o cache do contexto, mas a regra continua: não compre a placa no limite do tamanho do arquivo.
O que roda em cada faixa de VRAM
A tabela usa arquivos comprimidos em 3 a 6 bits (o formato GGUF, o mais usado para rodar em casa). Os tamanhos são dos arquivos que temos em disco. Os marcados com ✔ passaram pela bateria de testes do Laboratório de IA.
| VRAM | O que cabe com folga | Tamanho do arquivo | Na prática |
|---|---|---|---|
| 8 GB | modelos de 2 a 4 bilhões de parâmetros (LFM2.5-2.6B, Qwen3.5-4B, Gemma 4 E4B) | 2 a 5 GB | bom para resumir, traduzir e tirar dúvidas simples. Fraco para programar. |
| 12 GB | modelos de 9 a 12 bilhões (Qwen3.5-9B, Ornith 1.5 9B, Gemma 4 12B) | 6,5 a 7 GB | o ponto de entrada sério: já ajuda a programar e escrever com qualidade. |
| 16 GB | modelos de 24 a 27 bilhões em compressão mais forte (Qwen3.8-27B em 3 bits, Devstral Small 24B) | 10 a 13,5 GB | qualidade bem melhor, mas com pouco contexto sobrando. |
| 24 GB | ✔ Qwen3.8-27B em 4 bits, ✔ Qwen3.6-35B-A3B, ✔ Ornith 1.5 35B, ✔ Gemma 4 26B-A4B | 13 a 20 GB | o nível dos modelos que disputam com IA paga em várias tarefas. |
| 28 GB (nossa bancada, 2 placas) | tudo acima com contexto longo, e modelos maiores dividindo com a RAM (✔ Qwen3-Coder-Next 80B, ✔ Qwen3.8 Flash-Next 125B em 1 bit) | 46 a 70 GB | roda, mas mais devagar: parte do trabalho vai para o processador. |
E a velocidade?
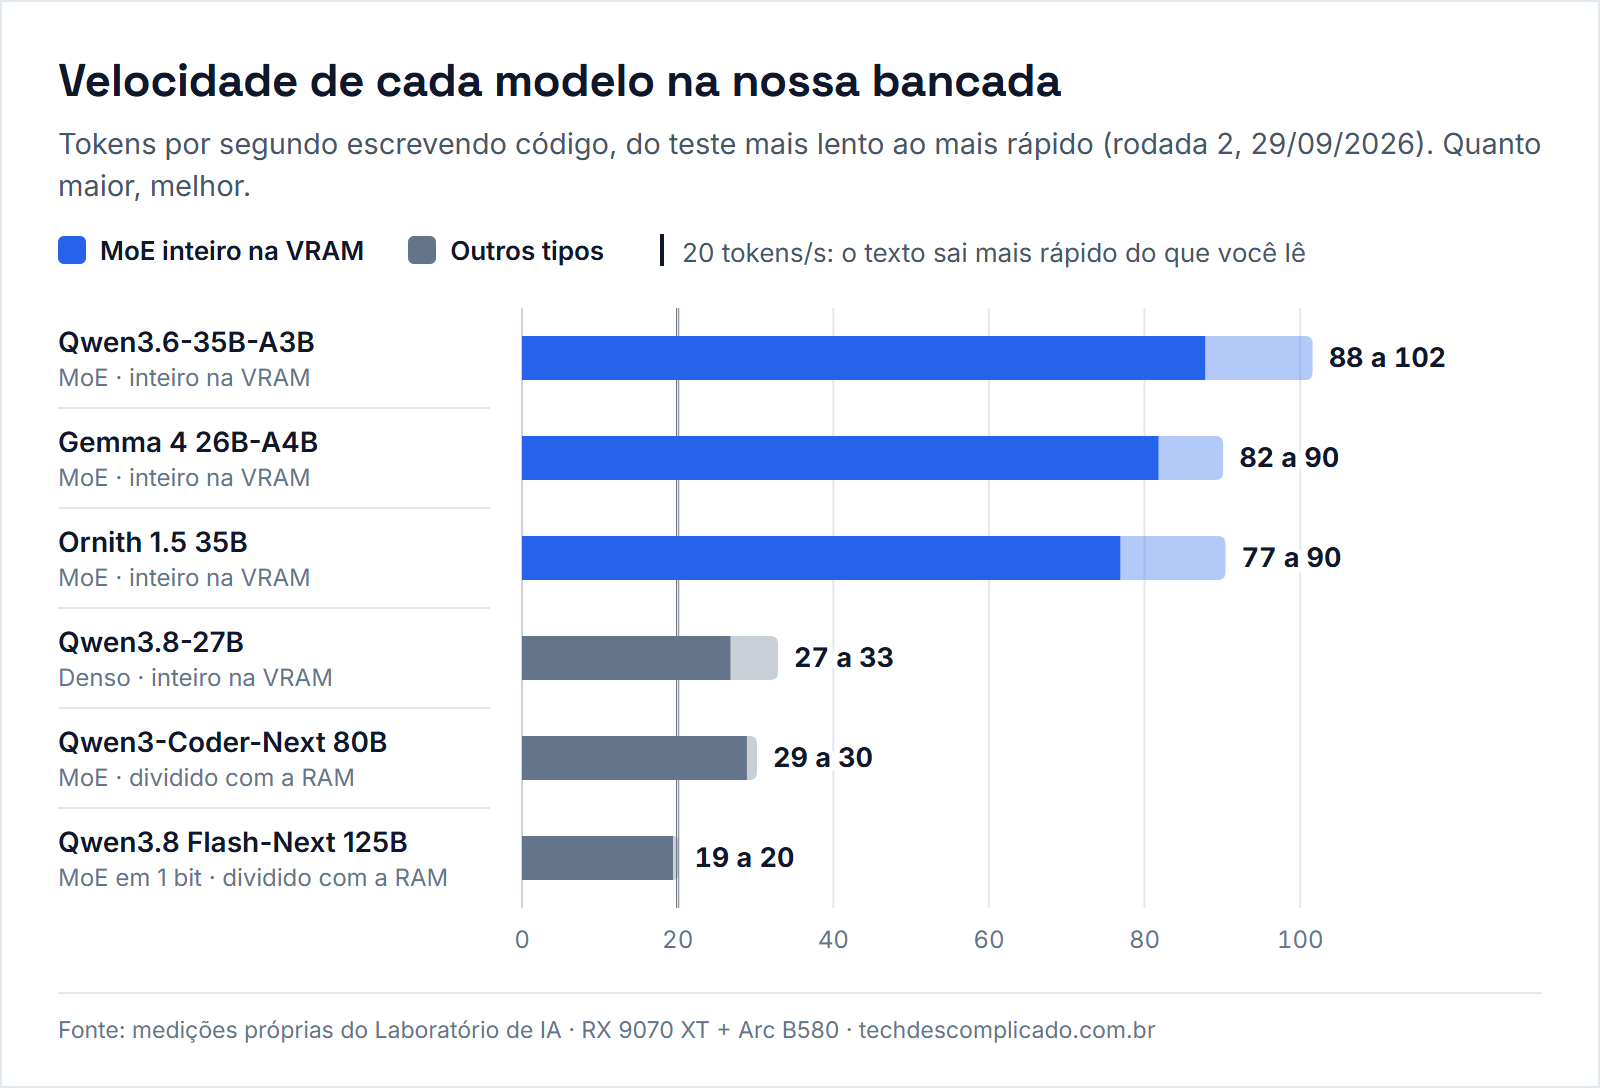
Caber é metade da história. A outra metade é quantas palavras por segundo o modelo entrega. Os números abaixo são da nossa rodada 2 de testes, de 29 de setembro, depois de padronizarmos a configuração de cada modelo (a amostragem recomendada pelo fabricante, a distribuição ideal entre as placas e um limite de raciocínio igual para todos). A velocidade é medida em tokens por segundo (um token é mais ou menos 3/4 de uma palavra), durante tarefas reais de programação, e o padrão ficou bem claro:
| Tipo de modelo | Exemplos testados | Velocidade na bancada |
|---|---|---|
| MoE (ativa só uma parte por palavra), inteiro na VRAM | Qwen3.6-35B-A3B, Gemma 4 26B-A4B, Ornith 1.5 35B | 77 a 102 tokens/s |
| Denso (usa tudo a cada palavra), inteiro na VRAM | Qwen3.8-27B (com MTP, que adianta vários tokens por vez) | 27 a 33 tokens/s |
| MoE grande, dividido com a RAM | Qwen3-Coder-Next 80B | 29 a 30 tokens/s |
| MoE gigante em 1 bit, dividido com a RAM | Qwen3.8 Flash-Next 125B | 19 a 20 tokens/s |
Para ter uma referência: acima de 20 tokens por segundo, a resposta aparece mais rápido do que você consegue ler. A lição é que um modelo MoE que cabe inteiro na VRAM é o melhor negócio para quem tem 16 a 24 GB: qualidade de modelo grande com velocidade de modelo pequeno.
Quanto custa cada faixa hoje
O mercado está difícil. A procura de data centers de IA por memória fez os preços de placas de vídeo subirem ao longo de 2026, e o topo de linha virou artigo de luxo. Menores preços à vista encontrados em 30 de setembro de 2026, do mais barato ao mais caro por GB de VRAM:
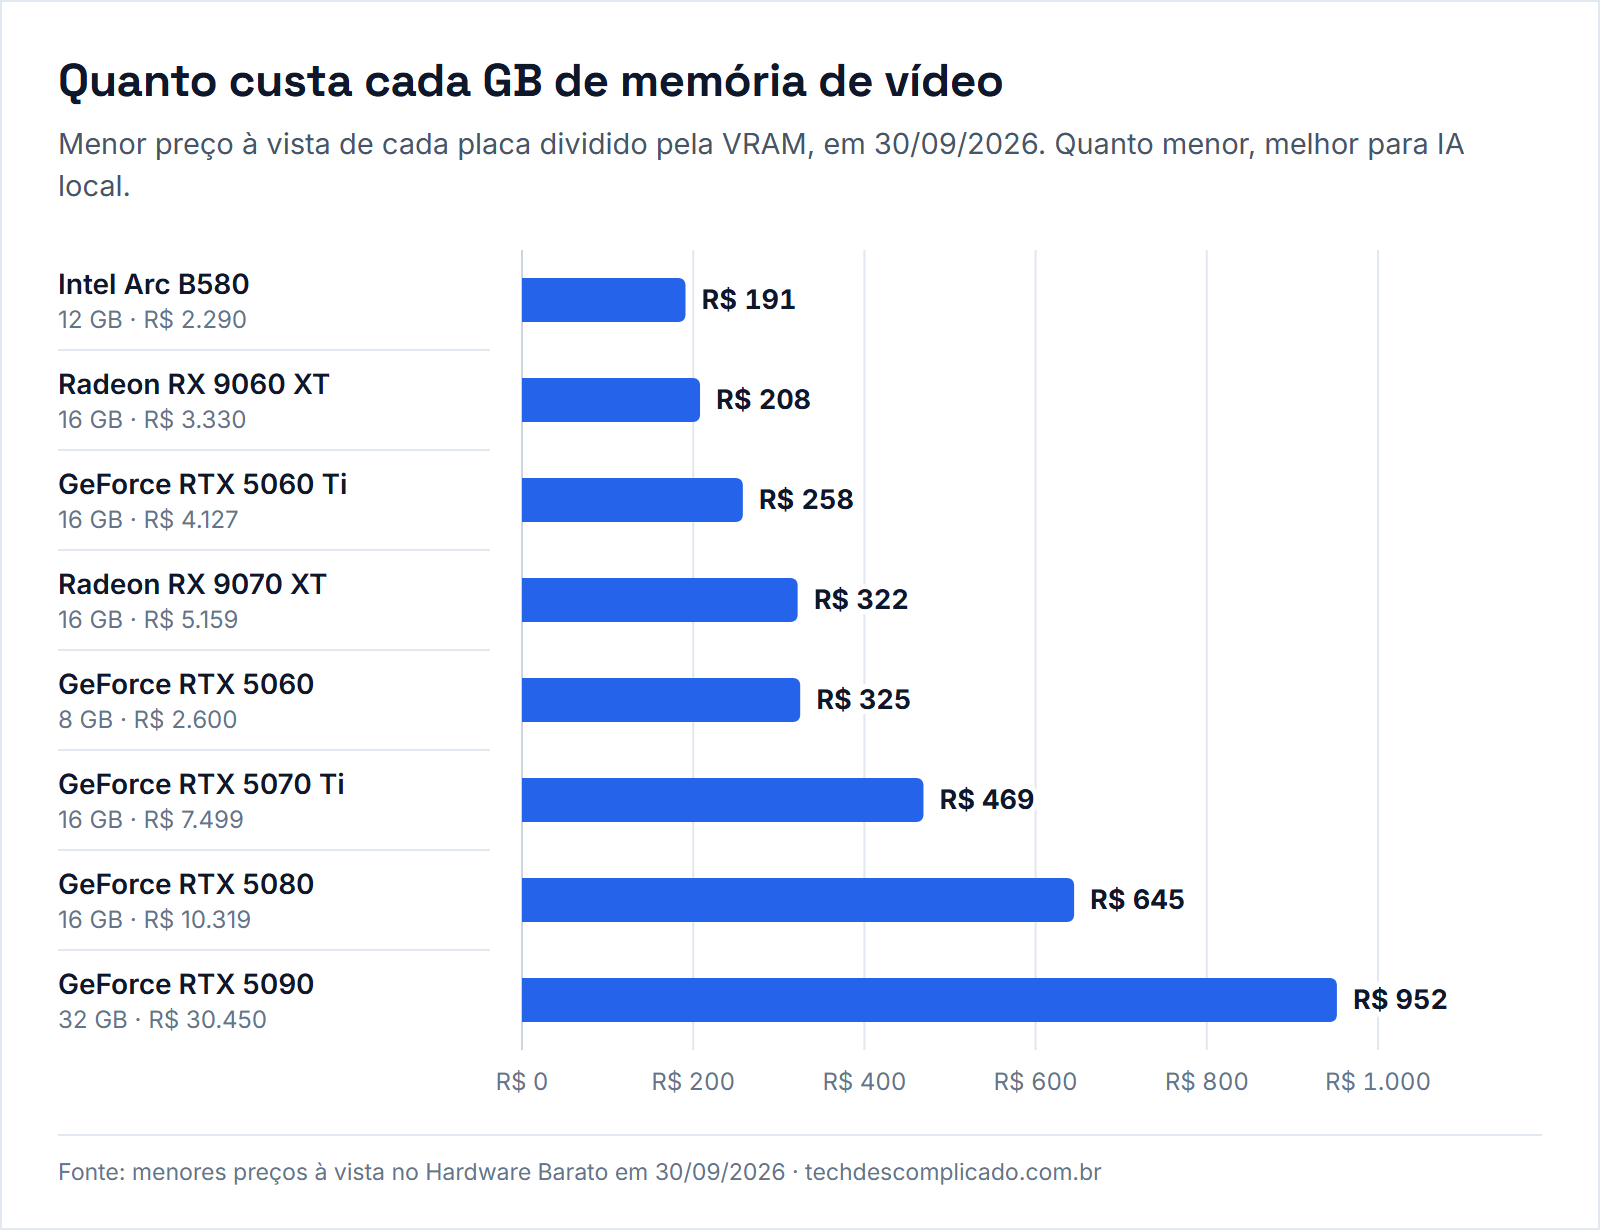
| Placa | VRAM | Menor preço | Preço por GB de VRAM |
|---|---|---|---|
| Intel Arc B580 | 12 GB | R$ 2.289,90 | R$ 191 |
| Radeon RX 9060 XT 16 GB | 16 GB | R$ 3.329,90 | R$ 208 |
| GeForce RTX 5060 Ti 16 GB | 16 GB | R$ 4.127,14 | R$ 258 |
| Radeon RX 9070 XT | 16 GB | R$ 5.159,14 | R$ 322 |
| GeForce RTX 5060 | 8 GB | R$ 2.599,99 | R$ 325 |
| GeForce RTX 5070 Ti | 16 GB | R$ 7.499,00 | R$ 469 |
| GeForce RTX 5080 | 16 GB | R$ 10.319,14 | R$ 645 |
| GeForce RTX 5090 | 32 GB | R$ 30.449,99 | R$ 952 |
Preços mudam todo dia. Use a tabela para comparar as placas entre si, e confira o valor na loja antes de comprar.
Minha recomendação por perfil
- Quero começar gastando pouco: Arc B580 de 12 GB. É o menor preço por GB da lista e roda bem os modelos de 9 bilhões. Na nossa bancada ela trabalha junto com a Radeon, pelo Vulkan.
- Quero o melhor custo-benefício: uma placa de 16 GB mais barata, como a RX 9060 XT 16 GB. Abre a porta dos modelos de 24 a 27 bilhões.
- Uso ferramentas que só funcionam bem com NVIDIA: RTX 5060 Ti 16 GB. Paga um pouco mais pelo ecossistema CUDA, que ainda é o mais suportado.
- Quero os modelos de 35 bilhões com folga: em vez de uma placa de R$ 30 mil, considere duas placas. Os programas de IA local conseguem dividir o modelo entre elas. É exatamente o que fazemos aqui: 16 + 12 GB = 28 GB. Não vira uma memória única (o modelo é repartido em camadas), mas funciona muito bem. As combinações possíveis, de placas iguais a marcas diferentes, estão no nosso comparativo entre mini PC e placas de vídeo.
O que eu evitaria: placa de 8 GB comprada pensando em IA. Ela serve para jogos, mas limita você aos modelos pequenos. E, se o dinheiro está curto, não precisa trocar de computador agora: dá para começar com a placa que você já tem, testando os modelos menores. O passo a passo está chegando no tutorial “Sua primeira IA local no Windows”, na seção Para Iniciantes.
Perguntas frequentes sobre VRAM para IA local
Quantos GB de VRAM é bom para rodar IA local?
12 GB é a entrada séria: rodam bem os modelos de 9 a 12 bilhões de parâmetros, que já ajudam a programar e escrever. 16 GB é o melhor custo-benefício hoje. Com 24 GB ou mais você roda os modelos de 27 a 35 bilhões com folga de contexto.
8 GB de VRAM rodam IA?
Rodam modelos pequenos, de 2 a 4 bilhões de parâmetros, que servem para resumir, traduzir e tirar dúvidas simples. Para programar, ficam fracos. Se for comprar placa pensando em IA, eu não iria de 8 GB.
16 GB de VRAM são suficientes para IA local?
Para a maioria das pessoas, sim. Cabem os modelos de 24 a 27 bilhões em compressão mais forte, com pouco contexto sobrando. E dá para ir além dividindo com a RAM: com 16 GB de VRAM e 64 GB de RAM, rodamos um modelo de 125 bilhões de parâmetros a uma média de 48 a 63 tokens por segundo, conforme a versão, como mostramos no teste do Qwen3.8-Flash-Next com o Strata.
O que consome mais VRAM numa IA local?
O arquivo do modelo e o contexto, que é a conversa ou o documento que ele está analisando. Em conversas longas, o contexto chega perto do tamanho do próprio modelo. Por isso a conta é arquivo + contexto + 1 a 2 GB de sobra.
Placa AMD, NVIDIA ou Intel para IA local?
As três funcionam com os programas mais usados, como o llama.cpp. A NVIDIA ainda tem o ecossistema mais suportado (CUDA), mas cobra mais por GB. Na nossa bancada, uma Radeon e uma Intel Arc trabalham juntas pelo Vulkan sem problema. Pelo preço por GB de VRAM, AMD e Intel saem na frente hoje.
Resumo rápido
- Para IA local, VRAM vale mais que velocidade em jogos.
- Conta de bolso: arquivo do modelo + contexto + 1 a 2 GB de sobra.
- 12 GB é a entrada séria, 16 GB é o melhor custo-benefício, 24 GB ou mais abre os modelos grandes.
- Modelos MoE que cabem inteiros na VRAM são os mais rápidos: 77 a 102 tokens/s na nossa bancada.
- Duas placas somando VRAM saem bem mais baratas que uma topo de linha.
Quer ver como cada modelo se saiu em jogos, sites e painéis gerados do zero? Os testes completos estão no Laboratório de IA, com conta grátis.
Fontes
- Medições próprias: rodada 2 da bateria do Laboratório de IA, 29/09/2026 (llama.cpp, Vulkan, RX 9070 XT + Arc B580, configuração padronizada por modelo).
- Hardware Barato: histórico de preços de placas de vídeo (30/09/2026)
- Hardware Barato: Arc B580
- Hardware Barato: RTX 5090 e placas comparáveis
- Hardware Barato: RX 9070 XT
- PCGamesN: preços da RTX 5090 em setembro de 2026
- DEV Community: as classes de peso dos modelos locais (setembro de 2026)