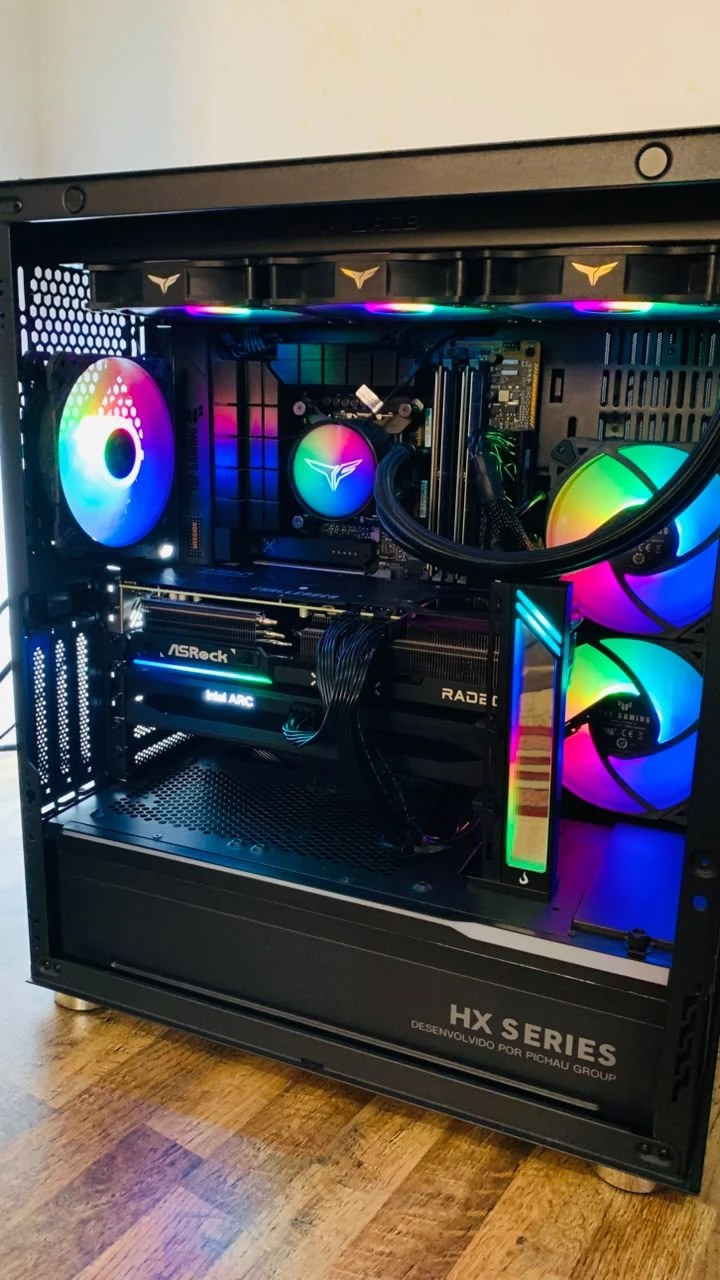
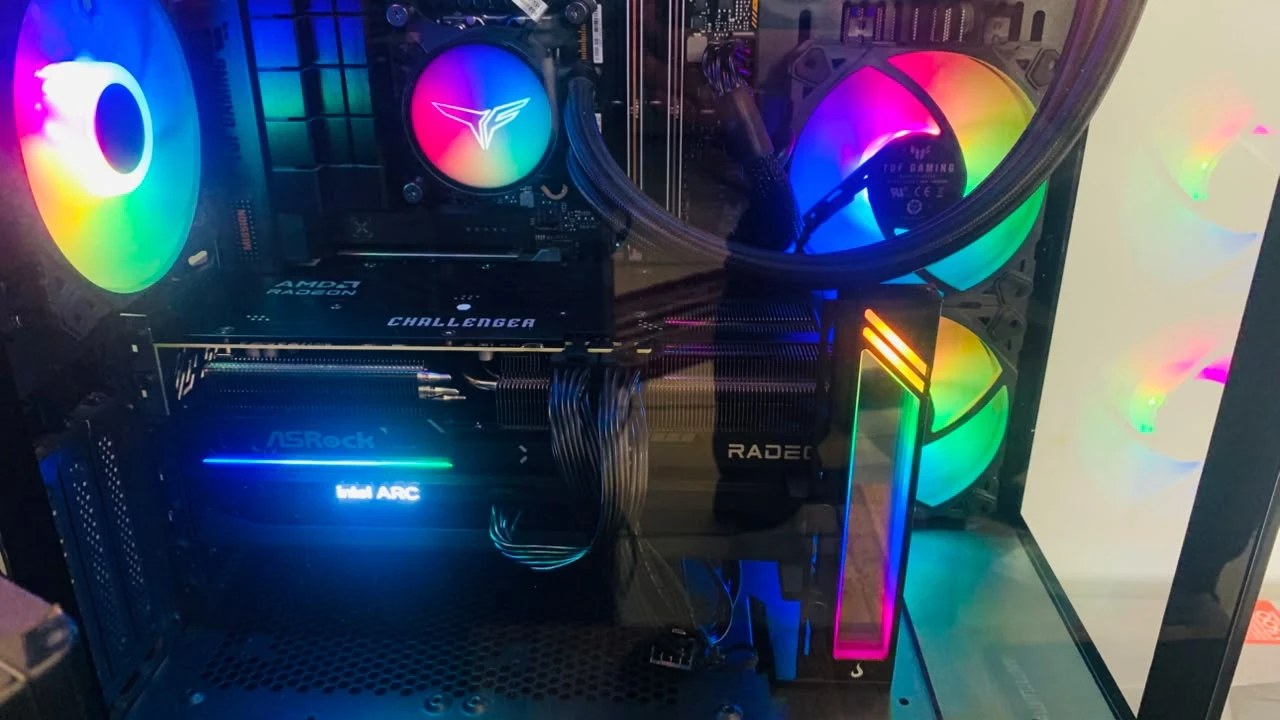
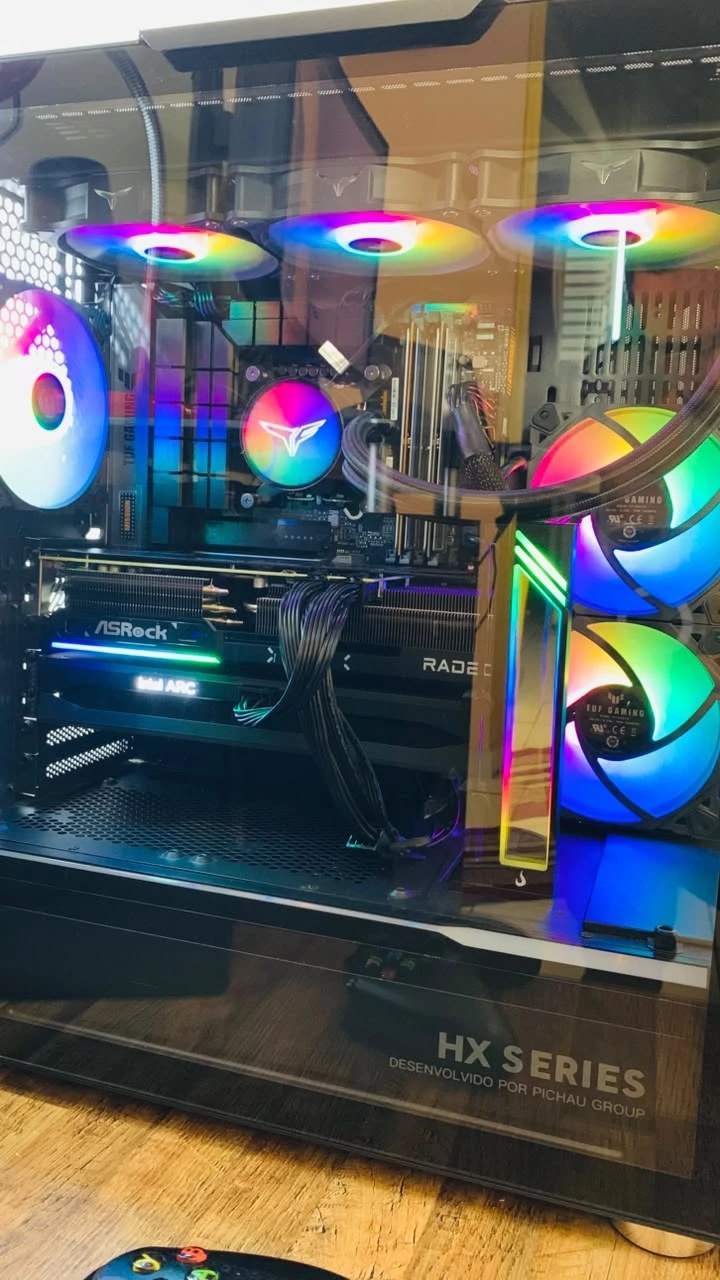
A RX 9070 XT para IA local é boa? Aqui no TechDescomplicado a gente não precisa chutar: ela é a placa principal da bancada onde rodamos todos os testes do Laboratório de IA. E ela não trabalha sozinha. Do lado dela tem uma Intel Arc B580, de outra marca, somando 28 GB de memória de vídeo. Neste artigo eu mostro a bancada por dentro, os números medidos (não estimados) e quanto custa montar algo parecido, com outras combinações de duas placas.
Resposta curta: a RX 9070 XT roda muito bem os modelos que cabem nos 16 GB dela, e com a Arc B580 de reforço e 64 GB de RAM a bancada chegou a 98 tokens por segundo e rodou até um modelo de 125 bilhões de parâmetros. Mas tem regras, e quebrar uma delas derruba a velocidade pela metade.
Não foi planejado: usei o que eu tinha em casa
Vou ser sincero: eu não comprei uma RX 9070 XT e uma Arc B580 pensando em juntar as duas para IA. Eu usei o que já tinha em casa. E confesso que estava com receio: placas de marcas diferentes, uma bem mais fraca que a outra, com menos memória, e ainda instalada num slot que trabalha em x4, com um quarto da largura de comunicação do slot principal, que roda em x16. Achei que não ia funcionar direito.
Para a minha surpresa (e que surpresa boa!), o llama.cpp distribui os pesos do modelo entre várias placas de um jeito muito otimizado. A comunicação entre as duas é rápida e eficiente, mesmo com a segunda placa sendo mais lenta e limitada pelo slot. Os números abaixo mostram que esse conjunto improvisado roda modelos em velocidades altas. E nos modelos menores, que cabem inteiros só na RX 9070 XT, a coisa fica ainda mais rápida: modelos MoE passam dos 100 tokens por segundo. Em breve vamos colocar na bancada uma bateria de testes só com esses modelos menores, para quem tem placa de 16 GB ou menos.
Se você tem uma ou duas placas de vídeo paradas em casa, isso vale como inspiração: juntar duas placas, somando a memória delas, pode ser uma alternativa barata para quem já tem as peças, ou mais acessível para quem quer montar algo parecido sem gastar uma fortuna.
A bancada: o que tem dentro
| Peça | Modelo | Detalhe que importa para IA |
|---|---|---|
| Placa de vídeo 1 | AMD Radeon RX 9070 XT | 16 GB de VRAM (15,9 GB utilizáveis), 640 GB/s, no slot PCIe 4.0 x16 |
| Placa de vídeo 2 | Intel Arc B580 | 12 GB de VRAM (11,8 GB utilizáveis), 456 GB/s, no slot PCIe 4.0 x4 |
| Processador | Intel Core i5-14600KF | Entra em ação quando parte do modelo fica na RAM |
| Memória RAM | 64 GB DDR5 | Guarda o que não cabe nas placas |
| Sistema | Windows 11 | Os testes rodam no llama.cpp com o backend Vulkan |
Dá para usar placa AMD e Intel juntas para IA?
Dá, e o segredo é o Vulkan. Cada fabricante tem o próprio jeito de fazer a placa calcular IA: a AMD usa o ROCm, a Intel usa o oneAPI/SYCL e a NVIDIA, o CUDA. Um não enxerga a placa do outro. O Vulkan é uma “língua comum” de placas de vídeo que as marcas entendem, e o llama.cpp, o programa que roda os modelos (e que está por trás do LM Studio e de várias outras ferramentas), usa as duas placas ao mesmo tempo por ele. O passo a passo da configuração está no guia llama.cpp com duas placas de vídeo.
Na prática, o modelo é fatiado: uma parte vai para a memória da RX 9070 XT, outra para a da Arc B580, e as duas trabalham em sequência. A gente define a proporção, e aprendemos que ela deve seguir o tamanho real da memória de cada placa (algo como 4 para 3), e não tentar compensar o slot mais lento.
RX 9070 XT para IA local: os números medidos
Todos os números abaixo foram medidos com o mesmo teste rápido, no mesmo PC, em 29 de setembro e 5 de outubro de 2026, e estão publicados no Laboratório. “Tokens por segundo” é a velocidade com que o modelo escreve a resposta. Acima de 20 já dá para ler confortavelmente, e acima de 50 a resposta parece instantânea.
| Modelo | Tipo | Como rodou | Velocidade |
|---|---|---|---|
| Qwen3.6-35B-A3B (4 bits) | MoE, 3B ativos | 2 placas | 98,4 tokens/s |
| Gemma 4 26B-A4B (4 bits) | MoE, 4B ativos | 2 placas | 95,4 tokens/s |
| Ornith 1.5 35B (4 bits) | MoE | 2 placas | 91,0 tokens/s |
| Qwen3.8-27B (4 bits) | Denso | 2 placas, com palpite (MTP) | 33,8 tokens/s (21,7 sem MTP) |
| Qwen3-Coder-Next 80B (4 bits, 46 GB) | MoE | 2 placas + parte na RAM | 31,5 tokens/s |
| Qwen3.8-Flash-Next 125B (1 bit, 69,5 GB) | MoE | 2 placas + parte na RAM, llama.cpp | 19,8 tokens/s |
| Qwen3.8-Flash-Next 125B (2 bits) | MoE | só a RX 9070 XT + RAM, motor Strata | 63 tokens/s (máximo de 68,2) |
A última linha merece destaque. O Strata é um motor feito para a AMD, então roda só na RX 9070 XT, sem a Arc. Mesmo assim, com uma placa só, ele levou o modelo de 125B de 19,8 para 63 tokens por segundo. Contamos essa história no artigo Qwen3.8-Flash-Next no PC de casa.
Quais modelos rodam em 16 GB (só a RX 9070 XT)
Sem a segunda placa, a regra é simples: o arquivo do modelo mais uns 2 a 4 GB de folga para a conversa precisam caber nos 16 GB. Isso inclui modelos de até uns 14 bilhões de parâmetros em boa qualidade, e modelos MoE de 26 a 35B em 4 bits se você aceitar mover uma parte para a RAM. A conta completa está no guia quanta VRAM você precisa para IA local.
Um cuidado: alguns guias na internet dizem que um modelo de 30B em 4 bits “cabe exato” em 16 GB. Na nossa experiência, “exato” não serve. Sem folga para o contexto, a placa transborda, e aí vem a regra mais importante desta bancada.
As três lições que mais mudaram a velocidade
1. Memória de vídeo cheia é modelo lento
Quando a VRAM enche, o driver começa a usar a memória do sistema como se fosse da placa, e tudo fica bem mais lento. Contraintuitivamente, mandar mais partes do modelo para a RAM de propósito (no llama.cpp, a opção --n-cpu-moe) deixou dois modelos grandes mais rápidos: +46% no Coder-Next e +37% no Flash-Next. O sinal de alerta é a leitura da pergunta (o “prompt”) muito lenta. Quando ela pulou de ~50 para 180–270 tokens por segundo, a VRAM tinha parado de transbordar.
2. O palpite (MTP) só compensa em modelo denso
O MTP faz o modelo “chutar” alguns tokens à frente e conferir depois. No Qwen3.8-27B, que é denso (usa o modelo inteiro a cada palavra), ele deu +56%. Nos modelos MoE, que já usam só 3 a 4 bilhões de parâmetros por palavra, o MTP empatou ou deixou mais lento: −24% na Gemma e −45% no Ornith, mesmo acertando mais de 90% dos chutes.
3. Proporção entre as placas pela memória, não pelo slot
A divisão do modelo entre as placas deve seguir a VRAM de cada uma. No Qwen3.6-35B, a divisão 4 para 3 deu 53–58 tokens por segundo estáveis. A divisão 3 para 2 começou em 42 e foi caindo até 27; a 4 para 1, que tentava aliviar a Arc, ficou em 35 e ainda estourou a memória da RX 9070 XT.
Quanto custa montar algo parecido (e outras combinações)
Você não precisa repetir a minha combinação. A ideia vale para qualquer par de placas: somar a memória das duas para caber modelos maiores. Montei algumas opções com os menores preços à vista de hoje, comparando com a RTX 5090, que é a única placa gamer com 32 GB numa peça só:
| Combinação | VRAM somada | Preço das placas | Largura de banda de cada placa | Programas que usam as duas |
|---|---|---|---|---|
| 2× Intel Arc B580 | 24 GB | R$ 4.700 | 456 GB/s | Vulkan (llama.cpp, LM Studio) ou SYCL |
| 2× AMD RX 9060 XT 16 GB | 32 GB | R$ 6.798 | 320 GB/s | Vulkan ou ROCm |
| RX 9070 XT + Arc B580 (a nossa) | 28 GB | R$ 7.509 | 640 + 456 GB/s | Só Vulkan |
| 2× NVIDIA RTX 5060 Ti 16 GB | 32 GB | R$ 8.398 | 448 GB/s | CUDA ou Vulkan (quase tudo) |
| 1× NVIDIA RTX 5090 | 32 GB | R$ 30.450 | 1.792 GB/s | CUDA (quase tudo) |
Com duas placas de 16 GB, você roda os mesmos modelos que cabem numa RTX 5090 de 32 GB, por cerca de um quarto do preço. O que você não ganha é a mesma velocidade. Quando o modelo é dividido entre duas placas, elas trabalham uma depois da outra, então a velocidade fica perto da de uma placa só. A RTX 5090 tem uma “esteira” de memória três a quatro vezes mais larga, e isso aparece em tokens por segundo. É a troca: caber gastando pouco ou voar gastando muito. Para entender por que a largura de banda manda na velocidade, explicamos a conta no artigo do Surface Laptop Ultra.
Antes de comprar a segunda placa, confira três coisas: se a placa-mãe tem um segundo slot PCIe com espaço físico (e em que velocidade ele trabalha, x4 é comum), se a fonte aguenta as duas e se o gabinete tem ventilação. Duas placas da mesma marca têm uma vantagem: podem usar o programa nativo da fabricante (CUDA, ROCm ou SYCL), não só o Vulkan.
O olhar de QA
O que esta bancada me ensinou é que quase toda configuração de IA local na internet é estimativa. “Cabe em 16 GB”, “roda a 40 tokens por segundo”, “MTP dobra a velocidade”. Quando a gente mede, metade dessas frases não se confirma no nosso hardware. O MTP piorou dois modelos. Pôr mais coisa na RAM acelerou. Por isso eu insisto em medir com o mesmo teste, no mesmo PC, e publicar a linha de comando junto com o número. Se você tem uma RX 9070 XT, não copie a minha configuração às cegas: rode o seu teste e compare. O número que vale é o do seu PC. E antes de gastar, faça a pergunta mais importante: rodar IA no seu próprio computador faz sentido para a sua vida ou para o seu trabalho? Se você usa IA todo dia para escrever, programar, resumir documentos ou estudar, uma ou duas placas dentro do seu orçamento podem resolver boa parte dessas tarefas sem assinatura mensal. Só como referência, o ChatGPT Plus custa R$ 99,90 por mês, quase R$ 1.200 por ano. Os modelos abertos ainda não são iguais aos melhores modelos pagos, mas para muita tarefa do dia a dia já dão conta, e o investimento pode se pagar com o tempo. E tem um ganho que não aparece na conta: os seus arquivos, as suas conversas e os dados do seu trabalho ficam no seu computador, sem passar pelo servidor de ninguém.
Perguntas frequentes
A RX 9070 XT é boa para IA local?
Sim. Na nossa bancada ela rodou modelos MoE de 26 a 35B a mais de 90 tokens por segundo (dividindo com uma segunda placa) e, sozinha com o motor Strata, um modelo de 125B a 63 tokens por segundo. O limite é a memória: 16 GB.
Dá para usar placa AMD e Intel juntas para IA?
Dá, pelo backend Vulkan do llama.cpp, o único que enxerga as duas marcas ao mesmo tempo. O ROCm só vê placas AMD, o oneAPI/SYCL só vê placas Intel e o CUDA só vê placas NVIDIA.
Duas placas de 16 GB substituem uma RTX 5090?
Em tamanho de modelo, sim: somam 32 GB, como a RTX 5090, por cerca de um quarto do preço. Em velocidade, não: com o modelo dividido, as placas trabalham uma depois da outra, e a largura de banda de cada uma é bem menor que a da 5090.
Quais modelos rodam em 16 GB de VRAM?
Modelos de até uns 14 bilhões de parâmetros em boa qualidade, com folga para a conversa. Modelos MoE de 26 a 35B em 4 bits rodam movendo uma parte para a RAM, com alguma perda de velocidade.
ROCm ou Vulkan para a RX 9070 XT?
Com uma placa AMD sozinha, os dois funcionam, e alguns motores, como o Strata, usam a base do ROCm. Para misturar AMD com Intel, só o Vulkan.
E você? Tem uma placa de vídeo parada em casa que poderia virar reforço para IA? Conta aqui nos comentários.
Resumo
- Bancada do Laboratório: RX 9070 XT 16 GB + Arc B580 12 GB + 64 GB de RAM, juntas pelo Vulkan do llama.cpp. Não foi planejado: são as placas que eu tinha em casa.
- Medido: 91 a 98 tokens/s em MoE de 26–35B; 33,8 no Qwen3.8-27B denso com MTP; 125B a 19,8 (llama.cpp) e 63 (Strata, só a AMD).
- Lições: VRAM cheia deixa tudo lento; MTP só ajuda modelo denso; divida o modelo pela memória de cada placa.
- Duas placas de 12 a 16 GB custam de R$ 4,7 mil a R$ 8,4 mil e rodam os mesmos modelos que uma RTX 5090 de R$ 30 mil, só que mais devagar.
Fontes
- Laboratório de IA do TechDescomplicado: AiTester (medições)
- llama.cpp (repositório oficial, backend Vulkan)
- AMD: Aceleração de IA com as placas de vídeo AMD Radeon
- Intel: placas de vídeo Arc série B
- Hardware Barato: histórico de preços de placas de vídeo (consultado em 08/10/2026)
- TechDescomplicado: placa de vídeo para IA local, quanta VRAM