A Alibaba anunciou o Qwen 4 no dia 22 de setembro, durante a conferência Apsara, na China. Para quem roda IA em casa, a parte que interessa é uma só: a família vai ter uma versão de 27 bilhões de parâmetros com pesos abertos, pensada para rodar localmente. Esta é uma nota curta com o que já se sabe, o que ainda é chute e o que vamos fazer quando ele sair.
O que foi confirmado
A família terá quatro versões:
| Versão | Para quê | Dá para baixar? |
|---|---|---|
| Qwen 4 Max | o modelo principal, o mais capaz | não anunciado |
| Qwen 4 Plus | equilíbrio entre custo e qualidade, multimodal | não anunciado |
| Qwen 4 Flash | respostas rápidas e grande volume | não anunciado |
| Qwen 4 27B | uso local, no seu computador | sim, pesos abertos |
O líder do projeto, Liu Dayiheng, disse que o Qwen 4 está em treinamento, com uma arquitetura de nova geração, e que sai “muito em breve”. Além disso, a Alibaba já falou em Qwen 4.5 e Qwen 5 na escala de 5 a 10 trilhões de parâmetros.
O que ainda não se sabe
- data de lançamento;
- licença: o Qwen3.8-27B saiu com Apache 2.0, que permite uso comercial. Já a prévia do Qwen 4 (veja abaixo) saiu com uma licença própria da Qwen, a qwen-community-1.0. Ainda não se sabe qual das duas o 27B novo vai seguir, então vale conferir antes de usar em produto comercial;
- arquitetura: se o 27B continua denso, como o Qwen3.8-27B, ou se passa a usar o formato de “especialistas” (MoE), que ativa só uma parte do modelo por palavra e costuma ser bem mais rápido. A prévia abaixo já mostra a nova atenção híbrida que a família deve usar;
- tamanho de contexto e se entende imagem e vídeo.
Uma prévia do Qwen 4 já passou pela nossa bancada
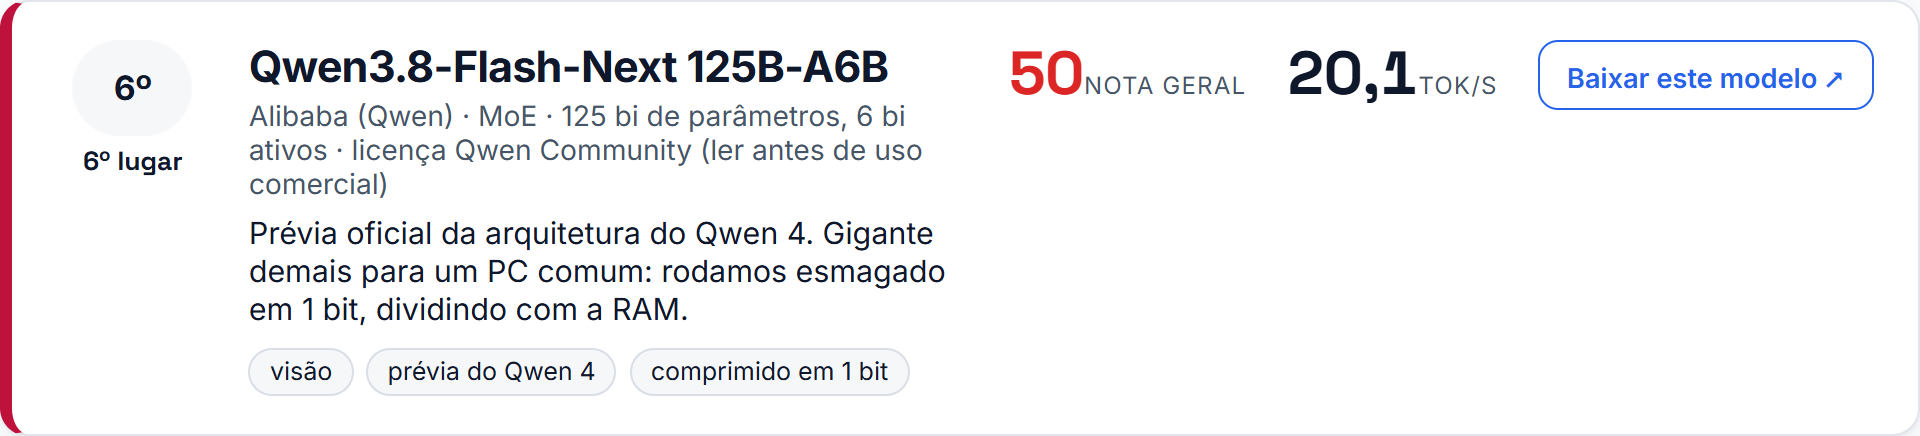
Tem um detalhe que pouca gente percebeu: dá para testar o Qwen 4 antes de ele sair. Em 26 de agosto, a Alibaba lançou o Qwen3.8-Flash-Next, e o próprio cartão do modelo no Hugging Face o apresenta como uma prévia experimental da arquitetura que vai sustentar o Qwen 4.
A mudança é grande. Três de cada quatro camadas usam uma atenção mais leve, que resume o histórico da conversa em vez de guardar tudo, e a quarta usa uma atenção esparsa para buscar detalhes lá atrás. São 125 bilhões de parâmetros, mas só 6 bilhões trabalham a cada palavra, e o contexto nativo chega a 262 mil tokens. Segundo a Qwen, o treino custou cerca de um nono do que custou o modelo anterior do mesmo nível.
Rodamos esse modelo na nossa bancada, comprimido em 1 bit, que é a única forma de um modelo de 125 bilhões caber em 28 GB de memória de vídeo somada à RAM. Na rodada de testes de 29 de setembro:
- velocidade de 19 a 20 tokens por segundo, 45% mais rápido do que na primeira rodada, só ajustando a divisão do modelo entre as placas e a RAM;
- concluiu três dos quatro desafios, incluindo o site de loja, que na rodada anterior ele nem tinha conseguido terminar;
- mas o código ainda chega com erros: o painel de métricas funcionou de primeira, enquanto o painel do carro e a loja travaram ao abrir por erros simples de código, e o Bomberman não coube na janela de 32 mil tokens que usamos.
Minha leitura: é impressionante ver um modelo desse tamanho, espremido em 1 bit, rodar a 20 tokens por segundo num PC doméstico e ainda escrever páginas inteiras. Não dá para saber quanto dos erros vem da compressão extrema; um teste com uma versão menos comprimida responderia isso. Mas a eficiência da arquitetura é real, e estou otimista: se o Qwen 4 27B herdar essas ideias num tamanho que cabe inteiro na placa de vídeo, o salto pode ser grande.
Atualização de 7 de outubro: depois desta nota, testamos o mesmo Qwen3.8-Flash-Next com o Strata, que roda o modelo numa placa só e com compressão menor. As versões de 2 e 3 bits chegaram a uma média de 48 a 63 tokens por segundo, e a de 3 bits entregou os quatro jogos da bateria sem problema. Os números estão no teste do Qwen3.8-Flash-Next no PC de casa.
Os resultados do Qwen3.8-Flash-Next, com as páginas que ele criou e a velocidade medida em cada desafio, estão no Laboratório de IA.
Vai rodar no meu PC?
Se ele tiver o mesmo tamanho do antecessor, dá para ter uma boa ideia pelo que já medimos. O Qwen3.8-27B comprimido em 4 bits ocupa cerca de 16 GB em disco e, somando o espaço da conversa (o contexto), pede algo entre 20 e 24 GB de memória de vídeo para trabalhar com folga. Na nossa bancada, com duas placas somando 28 GB, ele roda inteiro na GPU.
Com uma placa de 16 GB, dá para rodar numa compressão mais forte ou com parte do modelo na memória RAM, perdendo velocidade. Com 8 ou 12 GB, o caminho são os modelos menores, de 9B para baixo. A conta completa, faixa por faixa, está no guia quanta VRAM você precisa para IA local.
O que vamos fazer quando ele sair
No dia em que os pesos forem publicados, o Qwen 4 27B entra no Laboratório de IA e passa pela mesma bateria dos outros modelos: um painel de métricas (PULSE), o painel de instrumentos de um carro com simulação ao vivo (COCKPIT), um site de loja com carrinho (NEXUS) e o BOMBA LAB, um Bomberman completo em três fases, com texturas, efeitos e trilha sonora gerados por código.
O adversário direto é o Qwen3.8-27B. Na rodada de 29 de setembro, com o raciocínio limitado, ele terminou os quatro desafios (na primeira rodada, tinha pensado tanto que não concluiu os mais longos), entregou a loja mais bonita da bateria e rodou a 27 a 33 tokens por segundo. Mas o painel do carro e o Bomberman dele quebraram ao abrir, um deles por um único caractere errado no código. É essa a régua que o Qwen 4 precisa passar.
Quer ser avisado quando o teste sair? Crie sua conta grátis no Laboratório e acompanhe os comparativos completos.
Perguntas frequentes sobre o Qwen 4 27B
Quando o Qwen 4 vai ser lançado?
A Alibaba não divulgou data. O líder do projeto disse que o modelo está em treinamento e sai “muito em breve”. Quando os pesos do 27B forem publicados, ele entra na bateria do nosso Laboratório de IA.
O Qwen 4 27B vai ter pesos abertos?
Sim, a versão de 27 bilhões foi anunciada com pesos abertos, para rodar localmente. A licença ainda não foi confirmada: o Qwen3.8-27B saiu com Apache 2.0, mas a prévia do Qwen 4 saiu com uma licença própria da Qwen.
Quanta VRAM vou precisar para rodar o Qwen 4 27B?
Se ele tiver o tamanho do antecessor, algo entre 20 e 24 GB de VRAM para trabalhar com folga em 4 bits. Com 16 GB, dá para rodar numa compressão mais forte ou dividindo com a RAM, mais devagar.
Dá para testar o Qwen 4 antes do lançamento?
Dá para testar a arquitetura: o Qwen3.8-Flash-Next é apresentado pela própria Alibaba como uma prévia experimental do que vai sustentar o Qwen 4.
Fontes
- OrcaRouter: as quatro versões do Qwen 4 anunciadas na Apsara
- Hugging Face: cartão oficial do Qwen3.8-Flash-Next, prévia da arquitetura do Qwen 4
- MarkTechPost: Qwen3.8-Flash-Next, 125B com 6B ativos
- Medições próprias: rodada 2 da bateria do Laboratório de IA, 29/09/2026.
- Yotta Labs: Qwen 4 27B, o que foi confirmado
- CellCog: Qwen 4 em treinamento, sem data
- Pasquale Pillitteri: o roteiro de 10 trilhões de parâmetros