Para rodar IA localmente no PC, você precisa de três coisas: um programa que faça o papel do “ChatGPT” no seu computador, um modelo de IA baixado (um arquivo de alguns gigabytes) e memória suficiente para carregar esse modelo. O jeito mais fácil para quem está começando é o LM Studio, que é gratuito, tem opção de idioma em português e não exige uma linha de comando sequer. Em uns 15 minutos, contando o download, você já está conversando com uma IA que funciona sem internet e sem mandar nada para fora da sua máquina.
Os tutoriais que existem sobre o assunto explicam a instalação, mas quase nenhum diz quão rápido a IA vai responder num computador comum. Então, antes de escrever este guia, eu medi seis modelos pequenos aqui na bancada em dois cenários: só com o processador e com uma placa de vídeo de entrada. Os números estão mais abaixo, e servem para você escolher o modelo certo para o seu PC.
O que é rodar IA localmente (e por que vale a pena)
Rodar IA localmente é usar um modelo de linguagem, parecido com os que estão por trás do ChatGPT e do Gemini, direto no seu computador. Em vez de mandar a pergunta para um servidor de uma empresa, quem faz o trabalho é o seu processador ou a sua placa de vídeo.
- Privacidade: o que você escreve não sai do computador. Dá para colar um contrato ou uma planilha sem medo.
- Funciona sem internet: depois que o modelo está baixado, a conexão não é mais necessária.
- Sem mensalidade e sem limite de uso: o custo é só a energia do seu PC.
O preço dessa liberdade é que um modelo que cabe num PC comum é bem menor que os gigantes da nuvem. Ele resume, reescreve, explica, traduz e ajuda com e-mails muito bem, mas erra mais em perguntas difíceis de fatos e em raciocínio longo. É uma ferramenta diferente, não uma cópia grátis do ChatGPT.
O que você precisa para rodar IA local no PC
A documentação oficial do LM Studio pede, no Windows, um processador com suporte a AVX2 (a maioria dos processadores Intel e AMD dos últimos dez anos), recomenda pelo menos 16 GB de memória RAM e, se houver placa de vídeo, pelo menos 4 GB de memória de vídeo. Na prática, a regra que importa é esta: o modelo inteiro precisa caber na memória, com uma folga para a conversa.
| O seu computador | Até que tamanho de modelo | Exemplo do nosso teste |
|---|---|---|
| 8 GB de RAM, sem placa de vídeo | arquivos de até uns 3 GB | LFM2.5 2.6B (2,2 GB) |
| 16 GB de RAM, sem placa de vídeo | arquivos de até uns 8 GB | Gemma 4 E4B (5,3 GB) ou Qwen3.5 9B (7,5 GB) |
| Placa de vídeo com 8 GB | até uns 6 GB inteiros na placa | Gemma 4 E4B (5,3 GB) |
| Placa de vídeo com 12 GB | até uns 10 GB inteiros na placa | os seis modelos do teste |
A folga existe porque, além do arquivo do modelo, a conversa também ocupa memória: quanto mais longo o texto que você cola, mais memória ela pede. Por isso um modelo de 7 GB numa placa de 8 GB até carrega, mas fica sem espaço para conversas longas.
Não tem placa de vídeo dedicada? Tudo bem. A IA roda só no processador, mais devagar. É exatamente esse cenário que eu medi, e o resultado foi melhor do que muita gente imagina.
Passo 1: instalar o LM Studio
Entre no site oficial, lmstudio.ai, clique em Download e escolha a versão para Windows. É um instalador comum: avançar, avançar, concluir. O LM Studio é gratuito para uso pessoal e, desde julho de 2025, também para uso no trabalho, sem precisar de licença.
Na primeira vez que abre, o programa pode sugerir um modelo para baixar. Pode aceitar ou pular, porque o passo seguinte mostra como escolher. A interface tem opção em português nas configurações, mas parte dos textos continua em inglês, como você vai ver nas imagens abaixo. Um detalhe curioso: aqui na bancada, o LM Studio veio junto com o pacote opcional de IA do driver da placa AMD, então vale conferir se ele já não está instalado no seu PC.
Passo 2: escolher e baixar o primeiro modelo
Clique no ícone da lupa, na barra da esquerda (ou aperte Ctrl + 2), para abrir a busca de modelos. Digite o nome do modelo e clique no resultado com o selo de verificado. Para o primeiro teste, eu sugiro o Gemma 4 E4B, do Google: é leve, entende imagens e respondeu bem em português no nosso teste.
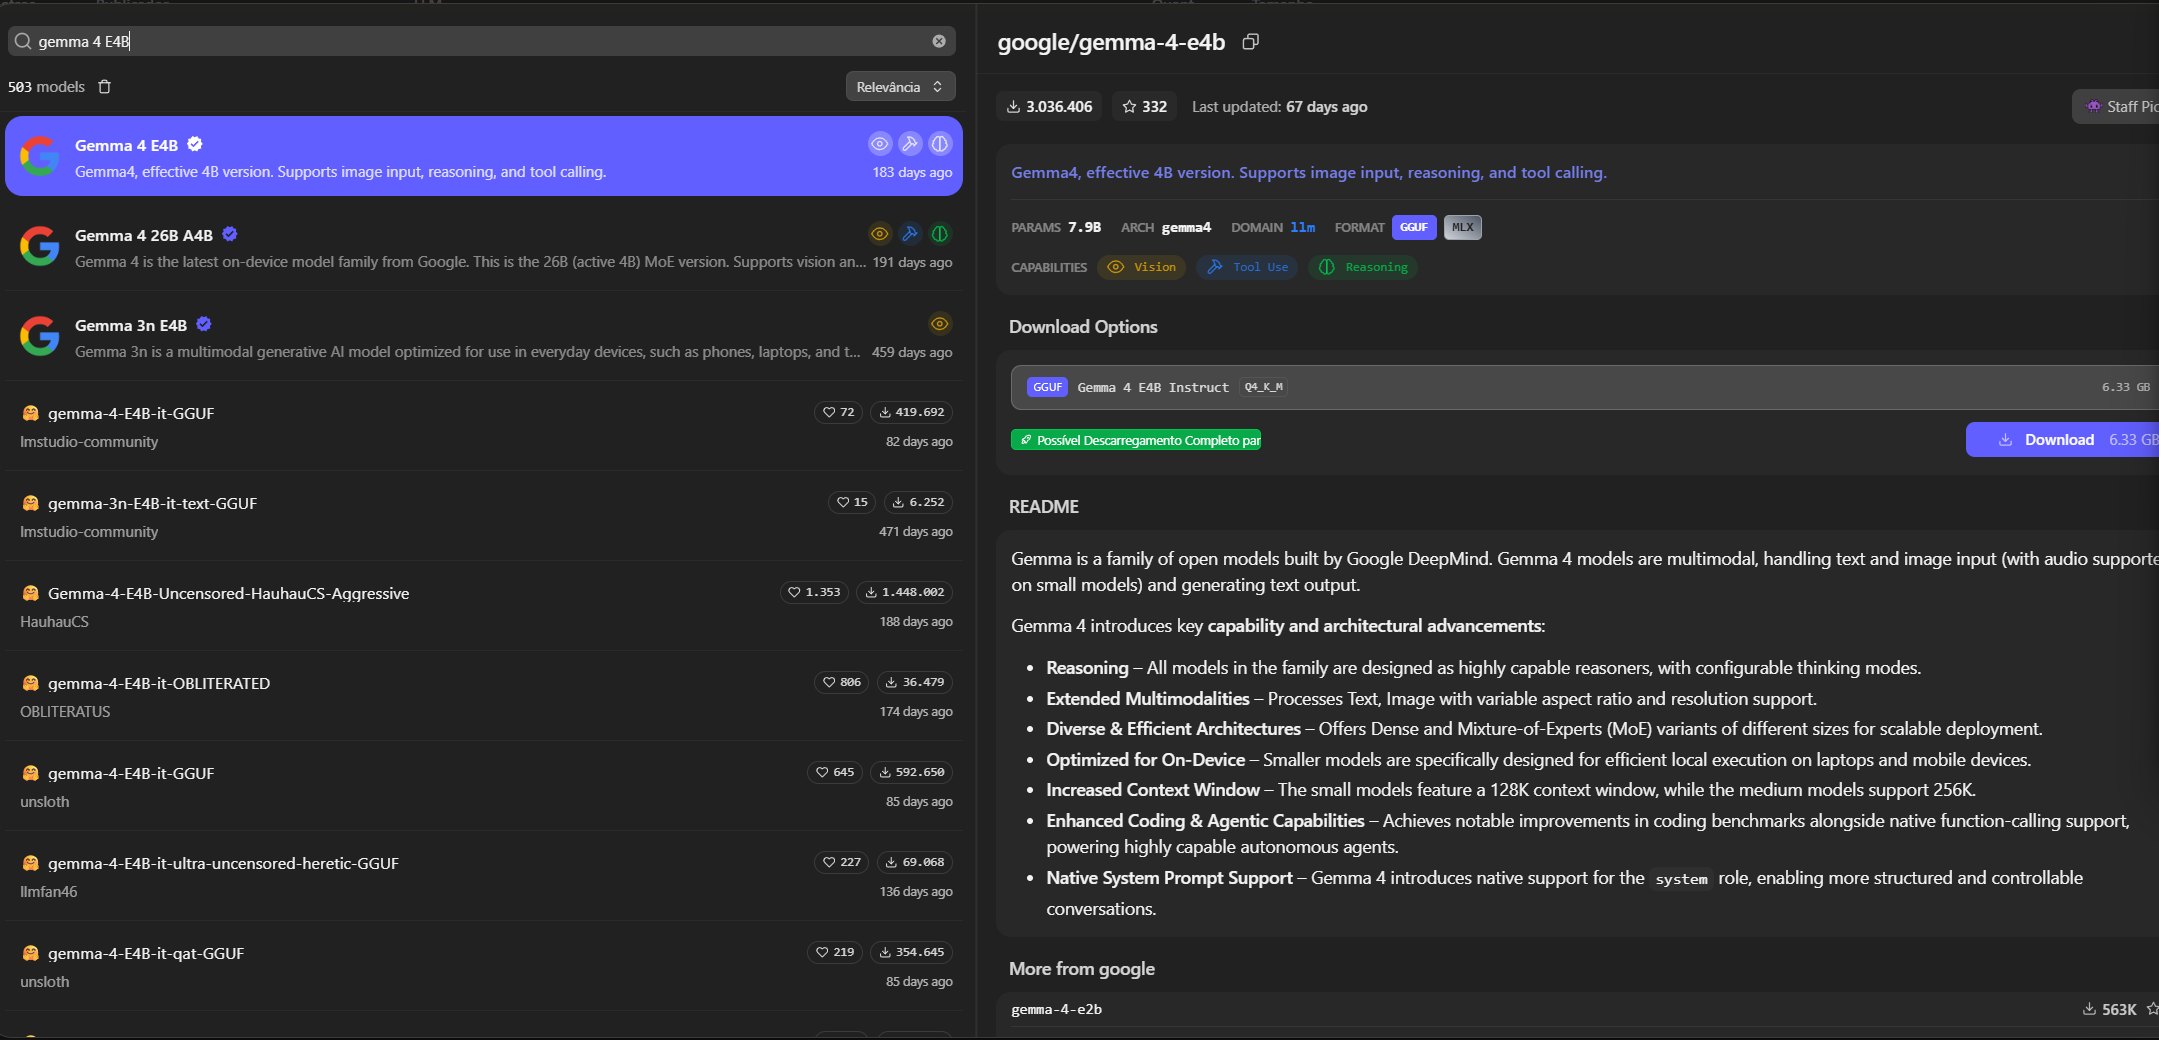
Do lado direito aparecem as opções de download. As letras como Q4_K_M indicam a quantização, que é uma compressão do modelo: números menores ocupam menos espaço e perdem um pouco de qualidade. A própria documentação do LM Studio recomenda ficar no 4 bits (Q4) ou acima. Se aparecer uma etiqueta verde dizendo que o modelo cabe inteiro na placa de vídeo, ótimo: ele vai rodar rápido. Clique em Download e espere. O Gemma 4 E4B tem 6,3 GB, então o tempo depende da sua internet.
Passo 3: carregar o modelo e conversar
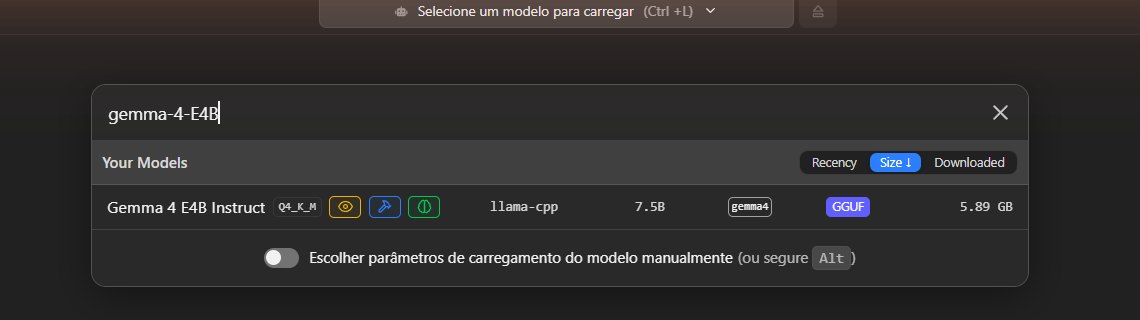
Volte para a aba de conversa (o primeiro ícone da barra da esquerda) e clique no botão do topo, Selecione um modelo para carregar, ou aperte Ctrl + L. Escolha o modelo baixado. Carregar significa copiar o modelo para a memória, e leva de alguns segundos a um minuto.
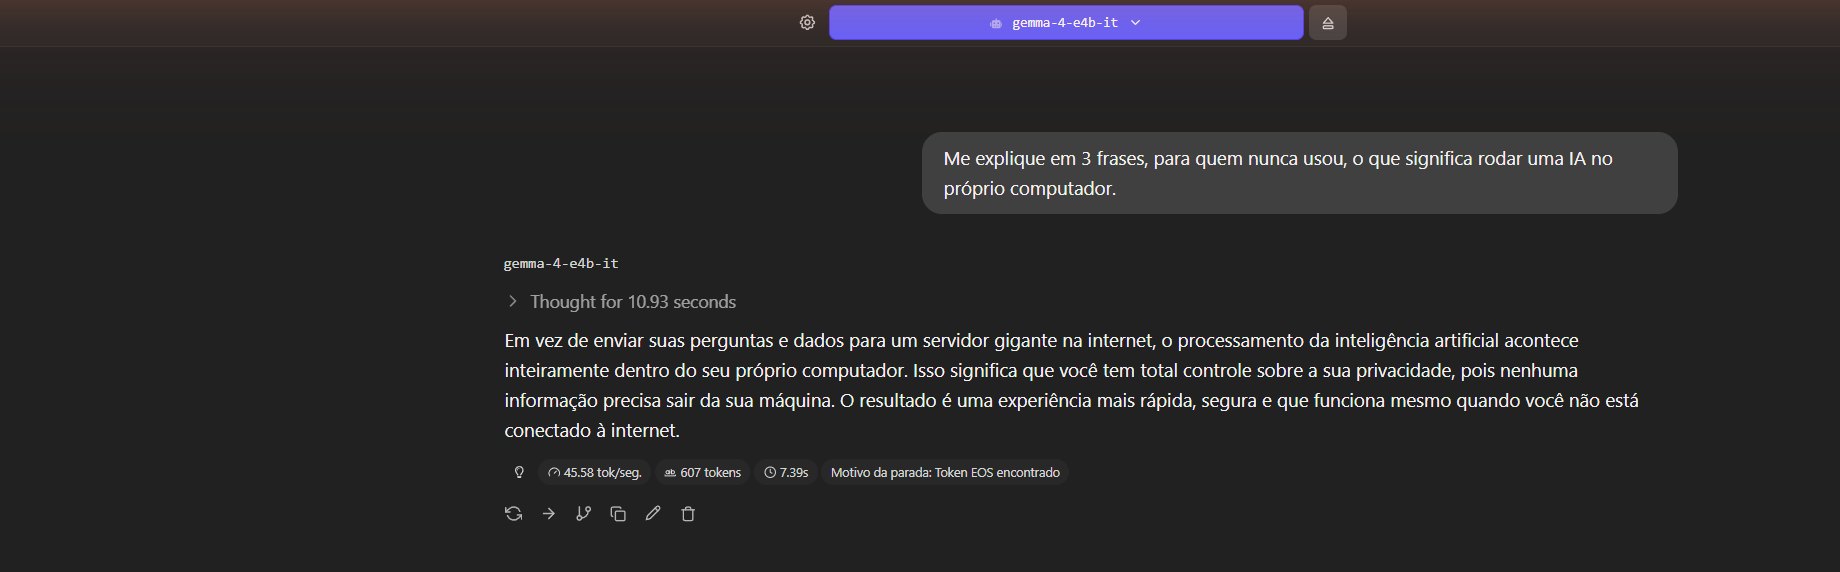
Pronto: é só escrever na caixa de mensagem e apertar Enter. Na resposta, o LM Studio mostra a velocidade em tokens por segundo (um token é um pedaço de palavra). O Gemma 4 E4B tem um modo de “pensar antes de responder”, que deixa a resposta melhor e mais lenta. Ele aparece como Thought for e pode ser desligado no botão Think, embaixo da caixa de mensagem.
Quanto a IA local roda num PC simples: os nossos testes
Medi seis modelos pequenos com a mesma ferramenta de teste do llama.cpp, que é o motor usado por baixo pelo LM Studio. São dois números por modelo: a leitura, que é a velocidade com que a IA processa o que você escreveu ou colou, e a escrita, que é a velocidade com que ela gera a resposta. Os cenários foram dois: só o processador, limitado a 6 núcleos para imitar um PC comum, e uma placa de vídeo de entrada, a Intel Arc B580 de 12 GB.
| Modelo | Tamanho do arquivo | Só processador: leitura / escrita | Placa de entrada: leitura / escrita |
|---|---|---|---|
| LFM2.5 2.6B | 2,2 GB | 91 / 24,2 | 6.629 / 127,4 |
| Qwen3.5 4B | 3,5 GB | 58 / 13,9 | 3.644 / 75,7 |
| Gemma 4 E4B | 5,3 GB | 97 / 15,8 | 3.344 / 80,2 |
| Gemma 4 12B (QAT) | 7,0 GB | 41 / 8,0 | 1.509 / 46,0 |
| Qwen3.5 9B | 7,5 GB | 32 / 8,0 | 2.241 / 46,7 |
| Ornith 1.5 9B | 7,6 GB | 31 / 8,2 | 2.203 / 46,9 |
Velocidades em tokens por segundo, média de 3 rodadas, medidas em 11/10/2026 com o llama.cpp (versão b10964, Vulkan) num Intel Core i5-14600KF com 64 GB de RAM. Leitura de um texto de 512 tokens e escrita de 128 tokens.
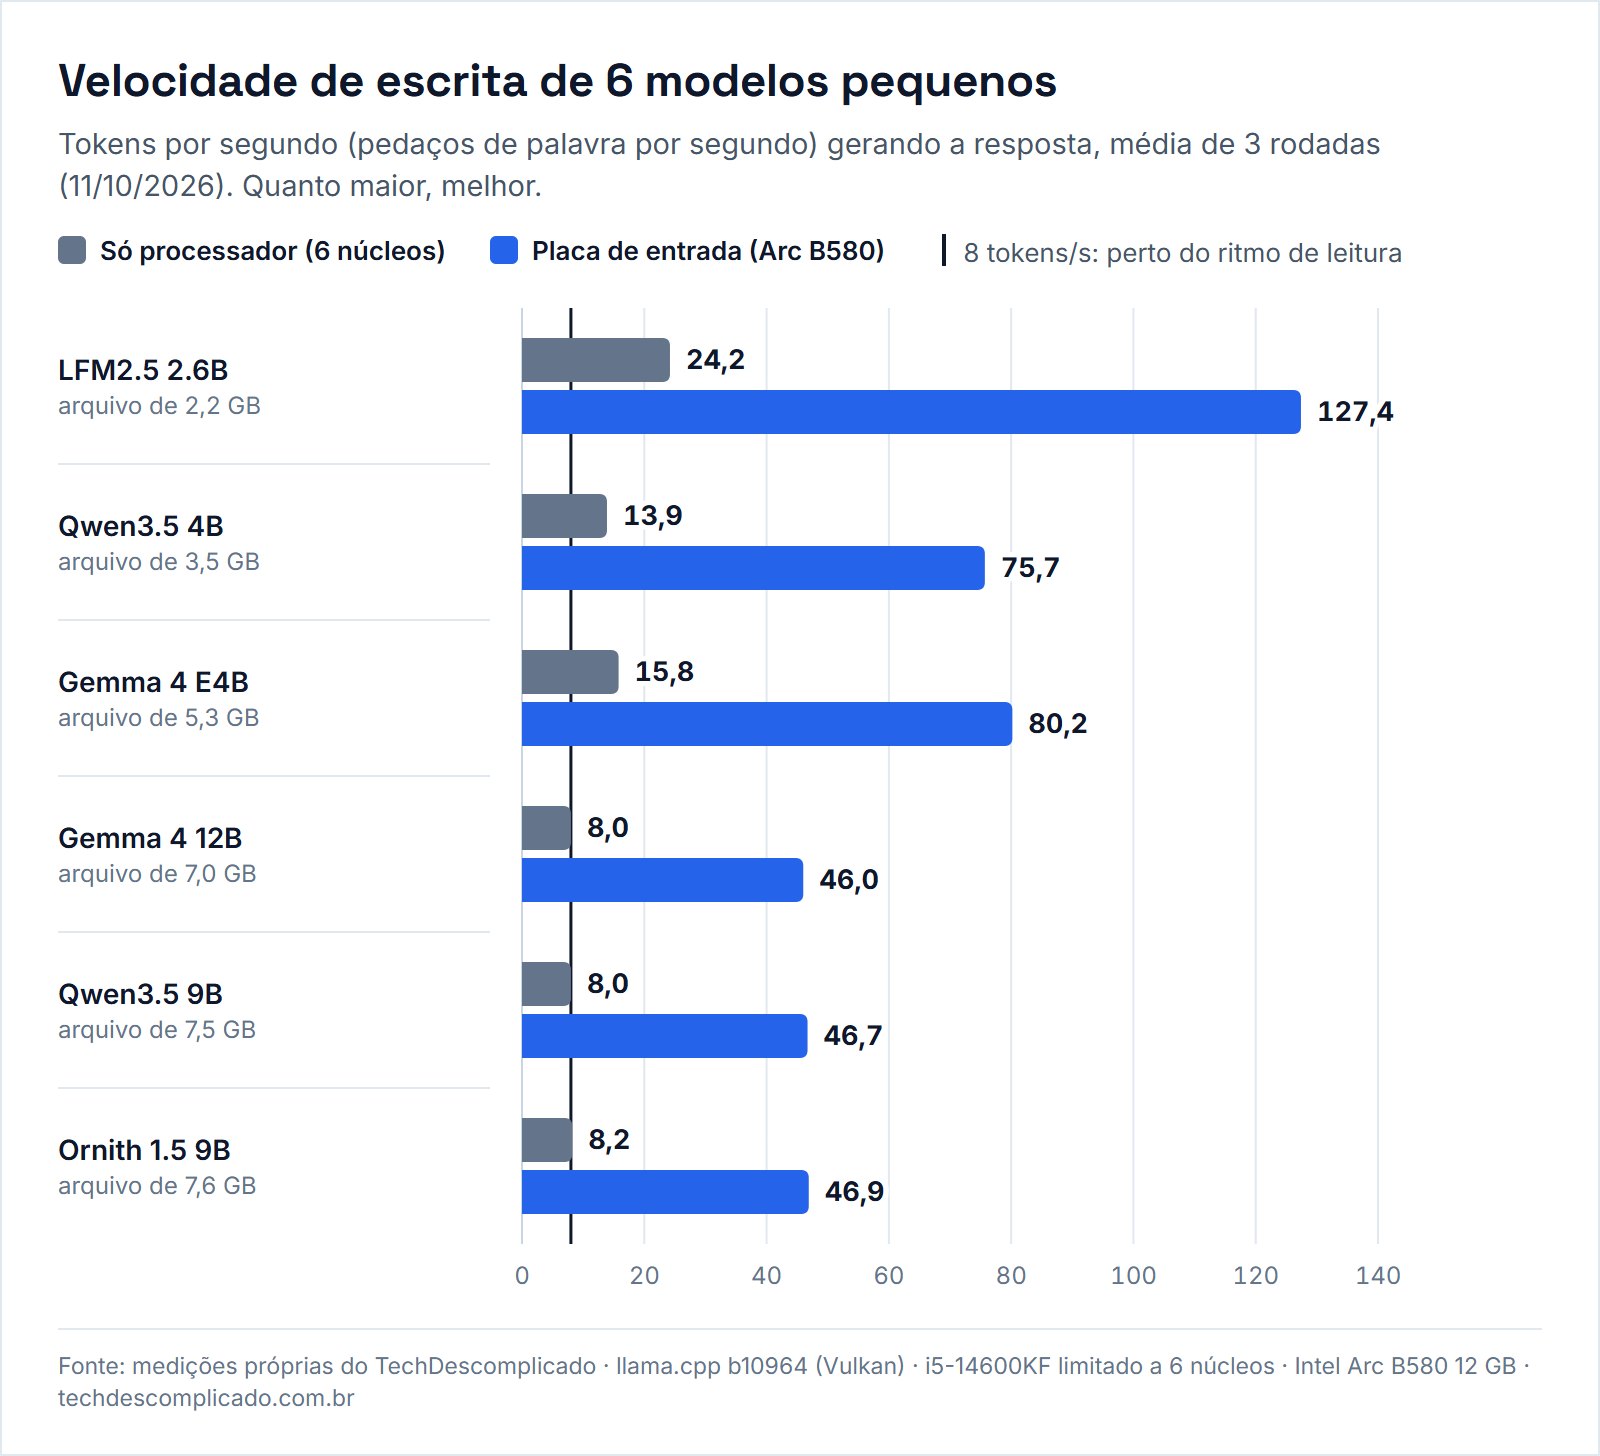
Como ler a tabela: escrever a 8 tokens por segundo é mais ou menos o ritmo em que a gente lê, então até os modelos de 9 a 12 bilhões de parâmetros são usáveis só no processador. Acima de 15 a resposta já sai fluida. Na placa de vídeo, tudo parece instantâneo. A leitura pesa quando você cola um texto grande: um texto de 500 tokens (uma página curta) leva uns 5 segundos para o LFM2.5 e uns 16 para o Qwen3.5 9B no processador, contra menos de meio segundo na placa.
Um aviso honesto: o nosso processador é recente. Num notebook mais antigo, espere números menores, principalmente na leitura. Se quiser ver como modelos maiores se saem em placas mais fortes, o Laboratório de IA tem os testes completos, e o texto sobre quanta memória de vídeo você precisa ajuda a planejar um upgrade.
Qual modelo escolher para o seu PC
Juntando os requisitos com os números da bancada, esta é a minha sugestão de primeiro modelo para cada tipo de computador:
| Se o seu PC tem | Comece com | Velocidade de escrita esperada |
|---|---|---|
| 8 GB de RAM e nenhuma placa de vídeo | LFM2.5 2.6B | cerca de 24 tokens/s |
| 16 GB de RAM e nenhuma placa de vídeo | Gemma 4 E4B ou Qwen3.5 4B | 14 a 16 tokens/s |
| Placa de vídeo com 8 GB | Gemma 4 E4B | cerca de 80 tokens/s |
| Placa de vídeo com 12 GB | Gemma 4 12B ou Qwen3.5 9B; para programar, Ornith 1.5 9B | cerca de 46 tokens/s |
Em geral, um modelo maior erra menos e escreve melhor, e um menor responde mais rápido. Vale começar pelo sugerido e trocar depois: no LM Studio, trocar de modelo é só escolher outro no topo da tela.
Problemas comuns ao rodar IA local (e como resolver)
- O modelo baixado não aparece na lista: o LM Studio só enxerga modelos guardados no formato pasta-principal › autor › modelo › arquivo.gguf. Aconteceu aqui: apontamos o programa para a nossa pasta de modelos e ele achou só 1 de 24. Se você já tem arquivos .gguf de outro programa, crie essa estrutura de pastas (ou atalhos de pasta, que não ocupam espaço) em vez de copiar gigabytes.
- Está muito lento: quase sempre o modelo é grande demais para a placa e parte dele foi para o processador. Escolha um modelo menor ou uma versão Q4.
- Erro ao carregar ou falta de memória: feche programas pesados, como o navegador cheio de abas, ou escolha um modelo menor. Conversas muito longas também enchem a memória: começar uma conversa nova resolve.
- A resposta veio em inglês: peça no começo da conversa para responder sempre em português. Os modelos pequenos entendem bem o pedido.
- Fica “pensando” por muito tempo: desligue o modo de raciocínio no botão Think. Para perguntas simples ele não faz falta.
- O LM Studio nem abre: confira se o processador tem AVX2, que é exigido no Windows. Processadores anteriores a 2013 e alguns Pentium e Celeron mais simples não têm.
LM Studio ou Ollama?
Os dois rodam os mesmos arquivos de modelo (.gguf) e se apoiam na mesma base técnica, a do projeto llama.cpp. A diferença é o jeito de usar. O LM Studio é um programa com janela: você procura o modelo, clica em baixar e conversa, como num aplicativo de mensagens. O Ollama nasceu na linha de comando e é o preferido de quem quer ligar a IA a outros programas, embora hoje também tenha uma janela simples. Para a primeira IA local, eu iria de LM Studio. Se depois você quiser automatizar alguma coisa, os dois oferecem um servidor local compatível com a API da OpenAI.
Minha opinião
Oito tokens por segundo não parece grande coisa no papel, mas na tela é a resposta aparecendo no ritmo de quem lê. Foi isso que me fez mudar a recomendação que eu daria para quem está começando: não precisa comprar placa de vídeo para experimentar. Instale o LM Studio, baixe um modelo pequeno e use por uma semana nas tarefas do dia a dia. Só depois disso dá para saber se vale gastar com hardware.
No uso, eu separo os modelos pelo tamanho. Os que têm poucos bilhões de parâmetros, como os menores deste teste, eu trato como um estagiário rápido e discreto: ótimos para resumir, reescrever e explicar, sem que nada saia do computador. Para fato, número e data, eu confiro sempre, porque modelo pequeno inventa com a mesma segurança com que acerta. Esse cuidado vale para qualquer IA, mas pesa mais nas pequenas. A partir de uns 9 bilhões de parâmetros, eles já ficam mais inteligentes e produtivos para as tarefas simples do dia a dia.
Com uns 26 bilhões de parâmetros, já dá para fazer códigos menores, tarefas medianas e tarefas agênticas, em que a IA executa etapas sozinha. Modelos como o Qwen3.6, nas versões de 27 e 35 bilhões, e o Qwen3.8 27B já são bem inteligentes para a maioria das tarefas, inclusive programação mais complexa, e ajudam muito um programador ou quem trabalha em outras áreas e precisa de uma IA que resolva com qualidade e eficiência. Ainda assim, ficam bem abaixo dos modelos pagos de fronteira, mas servem muito bem para os momentos em que você precisa de ajuda e não tem um modelo pago à mão.
Acima desses, os modelos maiores já prometem competir com os grandes modelos pagos e são indicados para tarefas agênticas e mais complexas, de um ambiente de trabalho profissional, porque têm muito mais parâmetros para resolver a maioria das necessidades. O preço é o hardware: para rodarem com boa velocidade e com menos quantização, sem perder qualidade nos resultados, eles pedem uma máquina como a nossa bancada ou maior.
Perguntas frequentes sobre rodar IA localmente
Como rodar o ChatGPT localmente?
O ChatGPT em si não roda fora dos servidores da OpenAI. Dá para rodar modelos abertos parecidos no LM Studio, inclusive o gpt-oss, que a própria OpenAI liberou, mas ele pede bem mais memória que os modelos deste guia.
Qual a melhor IA para rodar localmente?
Depende do seu computador. Pelos nossos testes, o Gemma 4 E4B é um bom começo para quem tem 16 GB de RAM ou uma placa de 8 GB, e o LFM2.5 2.6B é o mais rápido para PCs com 8 GB de RAM.
Como instalar uma IA localmente no PC?
Baixe o LM Studio no site oficial, instale, procure um modelo na aba de busca, clique em Download e depois carregue o modelo na aba de conversa. Leva uns 15 minutos, contando o download.
Preciso de placa de vídeo para rodar IA local?
Não. Os modelos pequenos rodam só no processador: no nosso teste, eles escreveram de 8 a 24 tokens por segundo sem placa de vídeo. A placa deixa tudo de 5 a 6 vezes mais rápido.
A IA local funciona sem internet?
Sim. A internet só é necessária para baixar o programa e o modelo. Depois disso, tudo roda no seu computador.
O LM Studio é gratuito?
Sim, para uso pessoal e, desde julho de 2025, também para uso no trabalho.
Rodar IA local é seguro?
O que você escreve não sai do computador, o que é ótimo para privacidade. Baixe modelos só de fontes conhecidas, de preferência os que aparecem com selo de verificado no LM Studio.
Qual modelo rodou bem no seu computador? Conta aqui nos comentários, com a configuração do seu PC.
Resumo
- Para rodar IA localmente no PC, o caminho mais fácil é o LM Studio: grátis, com janela e sem linha de comando.
- São 3 passos: instalar, baixar um modelo na aba de busca e carregar o modelo na aba de conversa.
- Só no processador, os modelos pequenos escreveram de 8 a 24 tokens por segundo no nosso teste; numa placa de entrada, de 46 a 127.
- Com 8 GB de RAM, comece pelo LFM2.5 2.6B; com 16 GB ou placa de 8 GB, pelo Gemma 4 E4B.
- IA local é ótima para privacidade e funciona sem internet, mas confira fatos e números: modelo pequeno erra com segurança.
Fontes
- LM Studio: requisitos de sistema
- LM Studio: primeiros passos e como baixar um modelo
- LM Studio: gratuito também para uso no trabalho (08/07/2025)
- llama.cpp (motor e ferramenta de medição usados no teste)
- Medições próprias na bancada do TechDescomplicado em 11/10/2026