O Qwen3.8 27B em Q2, ou seja, comprimido para cerca de 2 bits por peso, acaba de ganhar uma versão que chamou a atenção da comunidade de IA local: o Underdog Saluki 27B. Publicado no Hugging Face nesta semana, ele coloca o modelo de 27 bilhões de parâmetros da Alibaba num arquivo de 7,89 GB, contra 54 GB da versão completa, e promete manter a habilidade que mais importa para agentes: chamar ferramentas.
A promessa é boa, e em parte se confirma. Mas um teste independente feito no mesmo dia mostrou o outro lado da compressão. Neste texto eu explico o que é o Saluki, o que ele ganha, o que ele perde, quanta placa de vídeo você precisa de verdade e como ele se compara com o Qwen3.8 27B de 4 bits que a gente já roda na bancada do Laboratório.
O que é o Underdog Saluki 27B
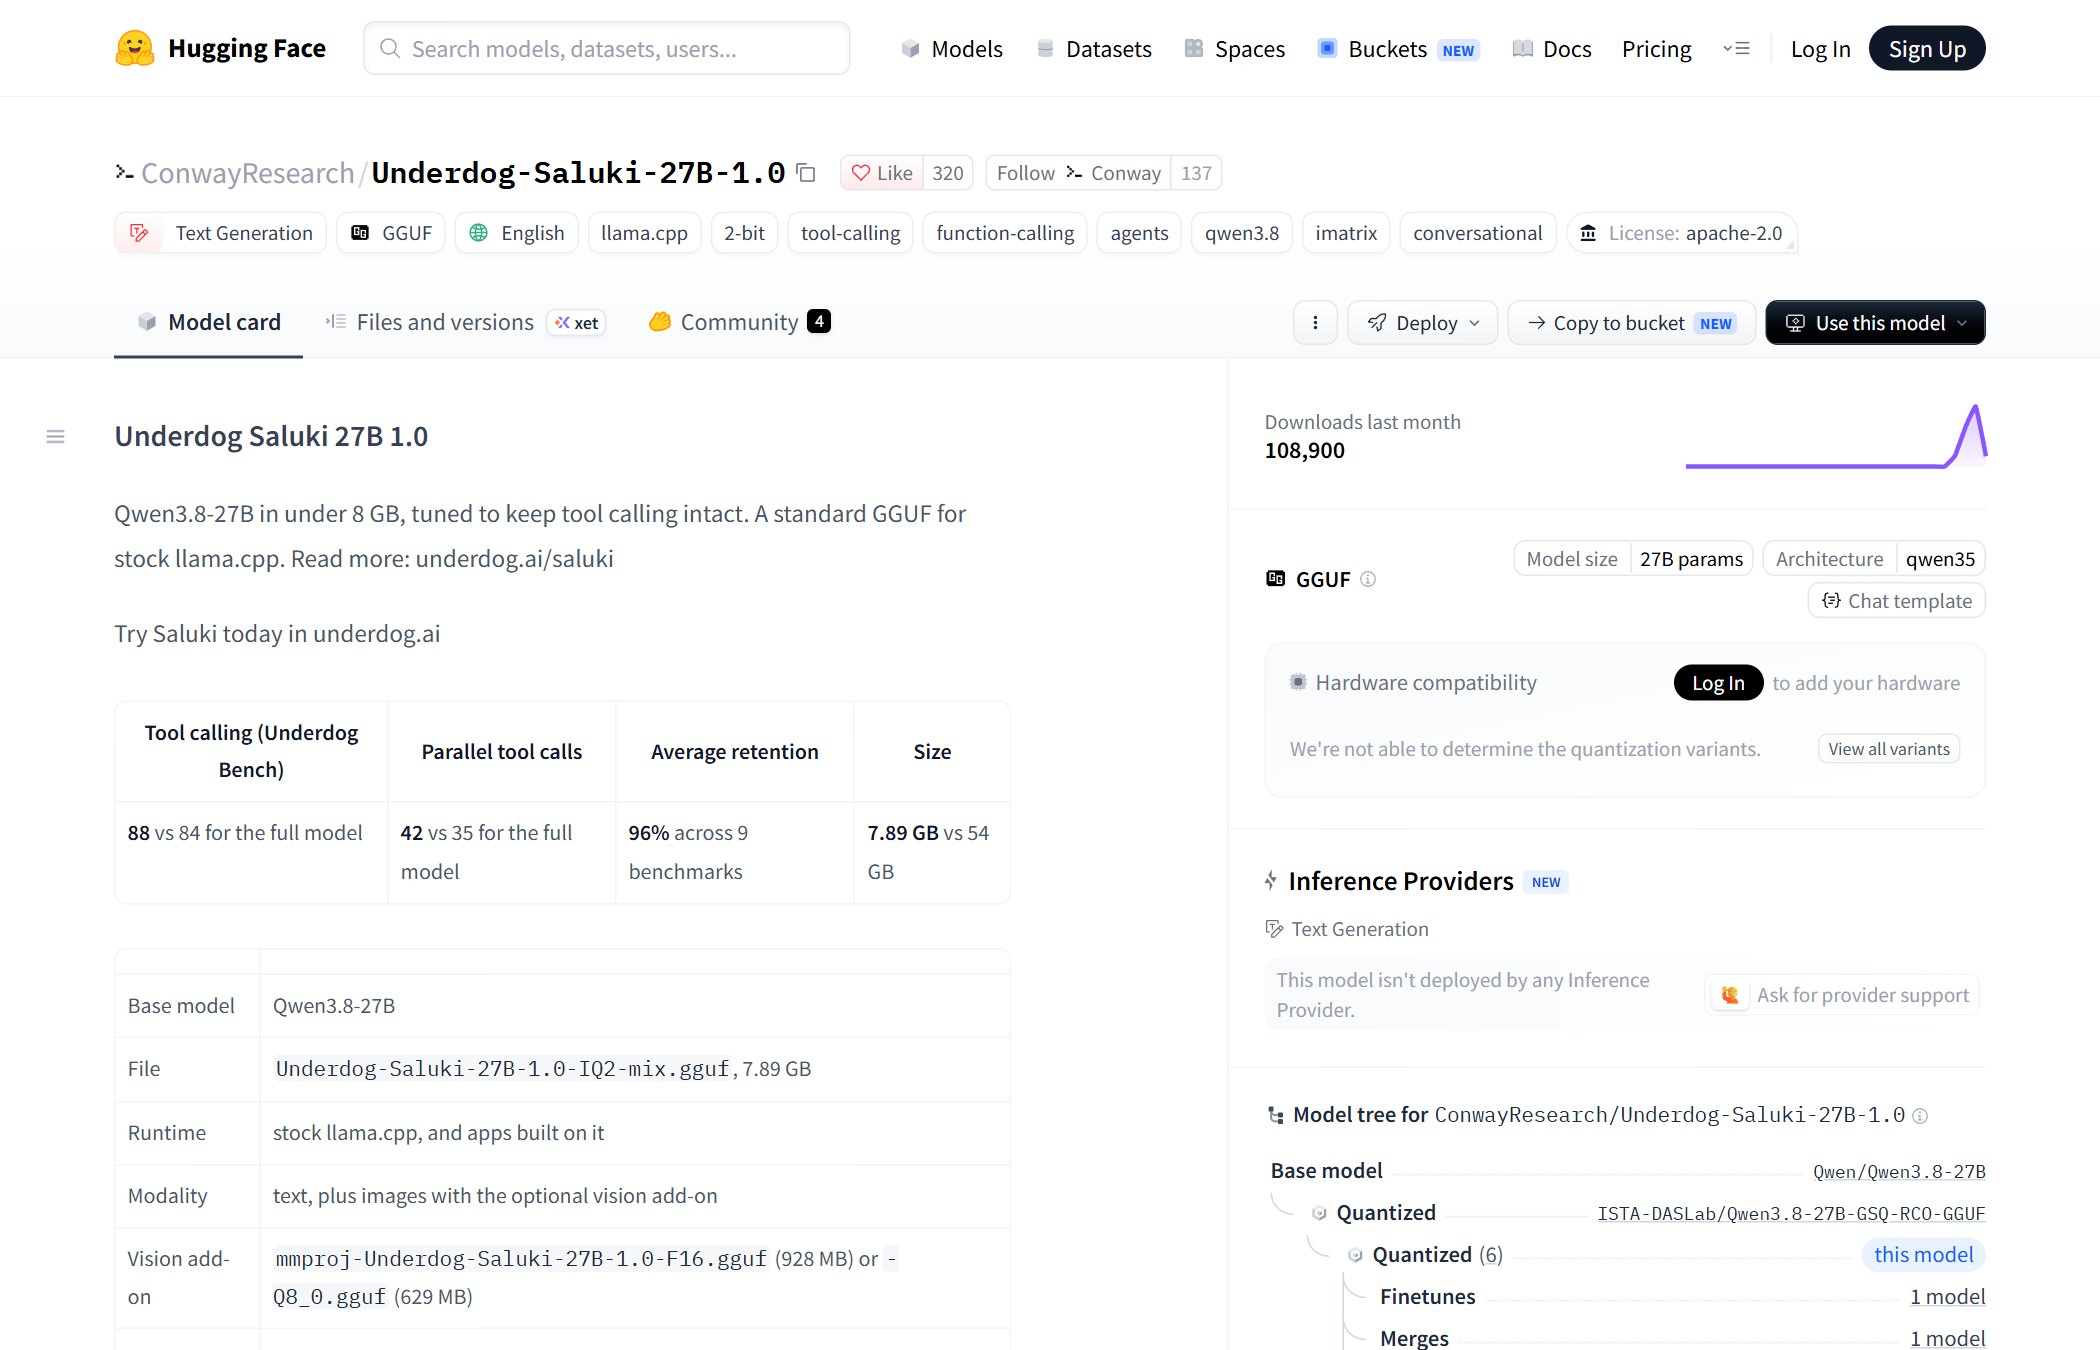
O Saluki é o Qwen3.8-27B comprimido para 2 bits e ajustado para não perder a chamada de ferramentas. Quem fez foi a Underdog, que publicou o modelo na organização ConwayResearch do Hugging Face, com licença Apache 2.0 (pode usar, inclusive comercialmente). Ele parte de uma versão já comprimida pelo grupo de pesquisa ISTA-DASLab, a Qwen3.8-27B-GSQ-RCO, e roda no llama.cpp comum, sem versão especial.
Pense numa foto em JPEG muito comprimida: o arquivo fica minúsculo, a foto continua reconhecível, mas os detalhes finos somem. A quantização faz isso com os “pesos” do modelo, os números que guardam o que ele aprendeu. Em 4 bits, quase nada se perde. Em 2 bits, a conta fica apertada, e a graça do Saluki é escolher onde perder.
| Item | Underdog Saluki 27B |
|---|---|
| Modelo de origem | Qwen3.8-27B (Alibaba), denso, com raciocínio ligado por padrão |
| Arquivo principal | 7,89 GB (GGUF, formato IQ2-mix), só texto |
| Visão (imagens) | Arquivo extra opcional de 629 MB (Q8_0) ou 928 MB (F16) |
| Versão completa | 54 GB |
| Licença | Apache 2.0 |
| Onde roda | llama.cpp padrão e programas feitos sobre ele |
O Qwen3.8 27B Q2 ficou melhor que o original?
Em chamada de ferramentas, segundo o próprio fabricante, sim. Em raciocínio e matemática, não. A Underdog testou o modelo em 120 tarefas tiradas do BFCL v4, um teste de chamada de funções, com o raciocínio desligado: o Saluki acertou 88, e o Qwen3.8 27B completo, de 54 GB, acertou 84. Em chamadas paralelas (várias ferramentas de uma vez), foram 42 contra 35. Na média de 9 testes, o Saluki manteve 96% do resultado do original.
| Teste (números do fabricante) | Saluki (7,89 GB) | Qwen3.8 27B completo |
|---|---|---|
| Chamada de ferramentas, 120 tarefas | 88 | 84 |
| Chamadas paralelas, 100 tarefas | 42 | 35 |
| SWE-bench Verified (50 problemas) | 30 | 33 |
| IFEval (seguir instruções) | 93,5 | 91,5 |
| MBPP+ (programação) | 78,0 | 83,9 |
| MuSR (raciocínio em várias etapas) | 67,5 | 79,6 |
| AIME 2025 (matemática de competição) | 79,2 | 96,7 |
| AIME 2026 | 80,0 | 94,6 |
Os limites também estão na página do modelo, e é raro um fabricante ser tão direto: ele guarda de 82% a 85% da nota de matemática de competição, vai mal em quebra-cabeças de letras (palíndromos, ordem alfabética), cerca de um quinto das respostas com chamadas paralelas sai com pequenos erros de formato e, com o raciocínio ligado, ele costuma pensar bastante antes de responder.
O teste independente que mostrou o outro lado
Um desenvolvedor japonês que publica com o nome zephel01 testou o Saluki no dia do lançamento e encontrou um resultado bem pior em programação. Foram 60 problemas de correção de código, cada um rodado 5 vezes, com o raciocínio ligado. O Saluki resolveu 76,7%; a versão de 2 bits da qual ele foi derivado resolveu 91,7% no mesmo teste. Numa bateria mais difícil, de 16 problemas, foram 25% contra 43,8% a 68,8%.
O detalhe mais interessante é o tipo de erro. Dos 14 problemas em que o Saluki falhou, em 10 ele não entregou código nenhum: o raciocínio batia no limite de 16.384 tokens ou entrava em repetição. Quando entregava, o código tinha qualidade parecida com a do modelo de origem. O autor reconhece que usou temperatura 0,35, e não os 0,6 recomendados, e que o teste do fabricante (raciocínio desligado, temperatura zero) é outro cenário. Então os dois números não se contradizem: medem coisas diferentes.
O que bate com o resto da literatura: o estudo da Quesma sobre as versões comprimidas do Qwen3.8 27B mostrou que a de 4 bits (17 GB) empata com o modelo completo num teste de agente de programação, a de 2 bits funciona “até certo ponto” e a de 1 bit desaba. O Saluki é uma tentativa de empurrar o 2 bits para cima, e ele consegue isso na tarefa para a qual foi ajustado.
Placa de 8 GB roda o Qwen3.8 27B em Q2?
O arquivo cabe, mas a placa fica no limite. Arquivo de 7,89 GB não é o mesmo que placa de 8 GB: além do modelo, a placa precisa guardar o contexto (a “memória de curto prazo” da conversa) e o que o sistema e o monitor já usam. No teste do zephel01, com contexto de 65 mil tokens, o uso medido de memória de vídeo foi de 12,3 GB. Com 32 mil tokens, o padrão sugerido na página do modelo, sobra menos para cortar.
| Memória da placa | O que esperar do Saluki |
|---|---|
| 8 GB (RTX 5060, RX 9060 XT 8 GB) | Só com contexto pequeno e sem o arquivo de visão; parte pode ir para a RAM e a velocidade cai |
| 10 a 12 GB (Arc B570, Arc B580, RTX 5070) | Cabe com contexto útil para conversa e agente |
| 16 GB (RTX 5060 Ti 16 GB, RX 9070, RX 9070 XT) | Folga para contexto longo; aqui já dá para pensar no Qwen3.8 27B de 3 bits |
| 24 GB ou duas placas | Vale ir direto para a versão de 4 bits, que perde quase nada |
Se você está escolhendo placa agora, eu falo dos preços de hoje e de quanta memória faz sentido no guia de placa de vídeo para IA custo-benefício, e explico a conta da memória com calma em quanta VRAM você precisa para IA local.
Q2 contra Q4: o que a nossa bancada já mediu
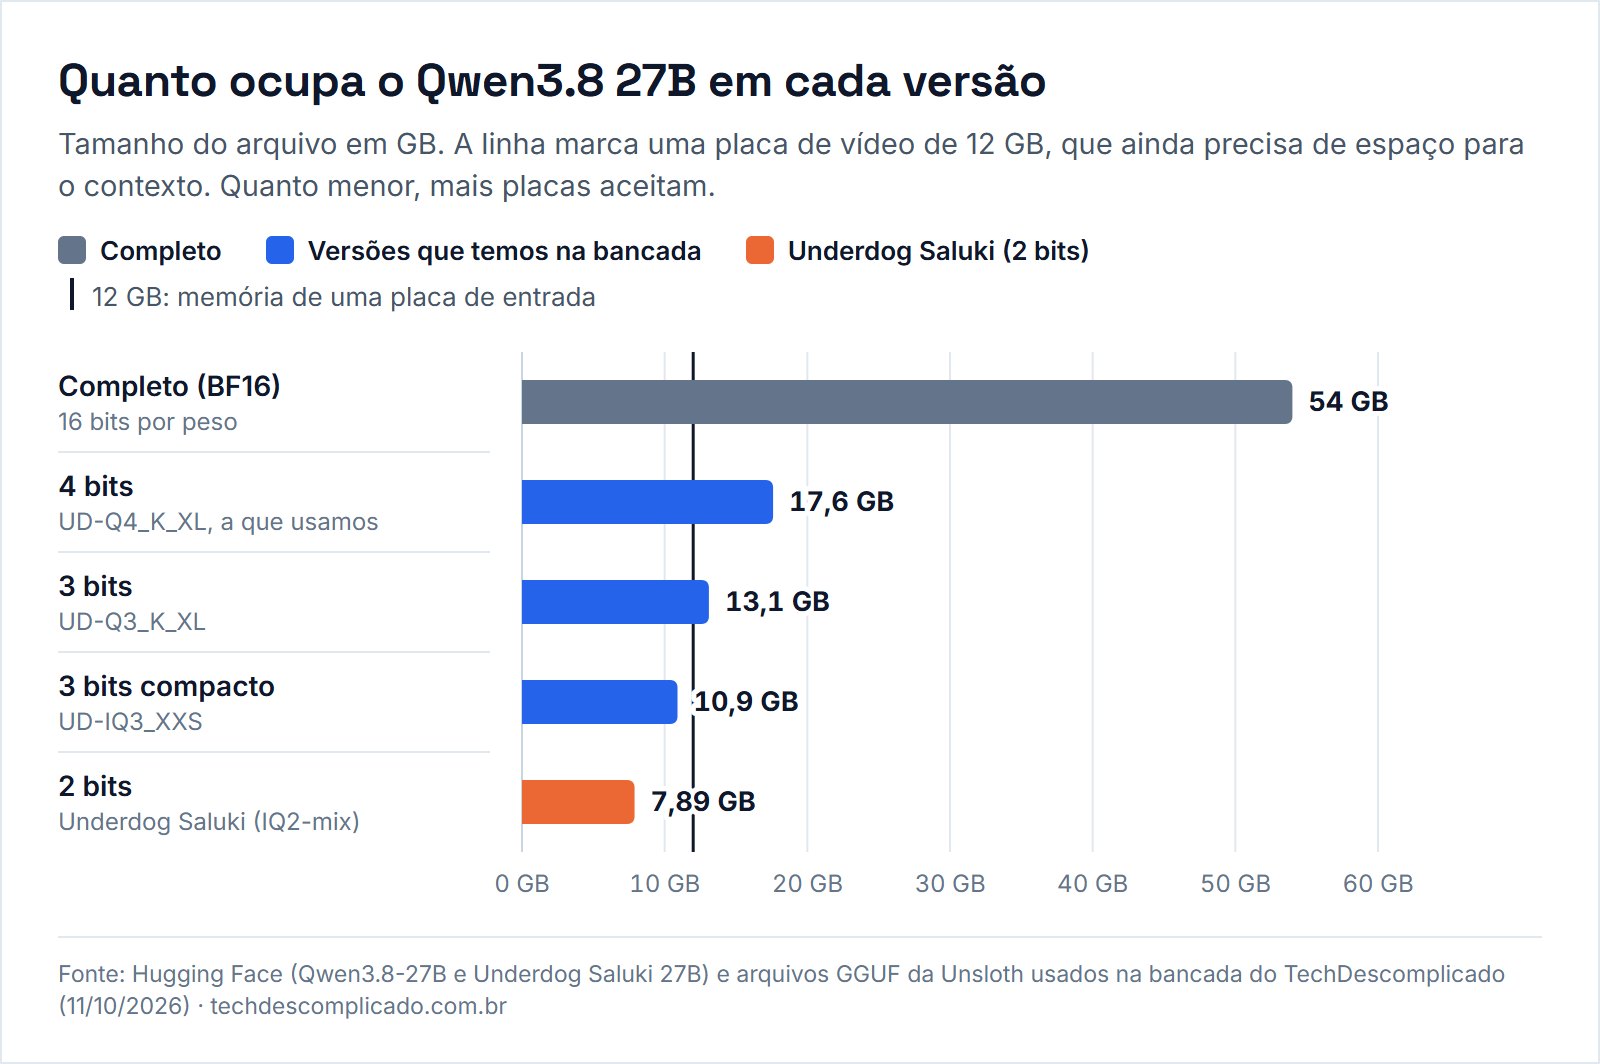
O Qwen3.8 27B já passou pelo nosso Laboratório de IA em três tamanhos, e o de 4 bits é o que a gente usa nos testes. Os números abaixo mostram o tamanho de cada versão e por que o Saluki é notícia: ele leva o 27B para o tamanho de uma placa de 12 GB, com folga para o contexto, sem abrir mão da chamada de ferramentas.
| Versão do Qwen3.8 27B | Arquivo | Como roda na bancada |
|---|---|---|
| Completa (BF16) | 54 GB | Não cabe nas nossas placas |
| 4 bits (UD-Q4_K_XL, a que usamos) | 17,6 GB | 2 placas: 21,7 tokens por segundo, 33,8 com o “palpite” MTP |
| 3 bits (UD-Q3_K_XL) | 13,1 GB | Cabe só na RX 9070 XT (16 GB) |
| 3 bits (UD-IQ3_XXS) | 10,9 GB | Cabe numa placa de 12 GB, com pouco contexto |
| 2 bits (Underdog Saluki) | 7,89 GB | Ainda não testado por nós |
Na nossa régua, com 28 GB de memória de vídeo somando as duas placas, o 4 bits continua sendo a escolha certa, porque perde quase nada. O Saluki faz sentido para quem tem uma placa só, de 12 GB, e quer um modelo de 27B para agente e automação, aceitando que ele tropeça em raciocínio longo. Para entender como juntar duas placas, veja llama.cpp com duas placas de vídeo.
Como rodar o Saluki
O caminho mais direto é o llama.cpp. A página do modelo recomenda este comando, que liga o modelo de conversa do Qwen (necessário para ferramentas e raciocínio), põe tudo na placa e usa 32 mil tokens de contexto:
llama-server -m Underdog-Saluki-27B-1.0-IQ2-mix.gguf --jinja -ngl 99 -fa on -c 32768Ele abre um servidor compatível com a API da OpenAI na porta 8080, que pode ser ligado a ferramentas de agente. Para uso geral, o fabricante sugere temperatura 0,6, top_p 0,95 e top_k 20; para chamadas de ferramenta rápidas, raciocínio desligado e temperatura 0. Se você nunca rodou um modelo no PC, comece pelo nosso guia de como rodar IA localmente no PC, com o LM Studio.
O olhar de QA
“Melhor que o original” em quê, exatamente? É a primeira pergunta que eu faria antes de colocar o Saluki em qualquer automação. O número do fabricante é verdadeiro para o cenário dele: chamada de ferramenta, raciocínio desligado, temperatura zero, 120 tarefas. O número do teste independente também é verdadeiro para o cenário dele: programação com raciocínio ligado. O erro seria pegar o primeiro e usar no segundo. O tipo de falha também importa. Resposta vazia é um defeito fácil de detectar e de repetir automaticamente; código errado que parece certo é bem pior. Se eu fosse usar o Saluki num agente, ligaria a chamada de ferramenta sem raciocínio, colocaria um limite de tempo e uma nova tentativa quando a resposta voltasse vazia, e mediria com as minhas próprias tarefas antes de confiar. Compressão boa é a que falha de um jeito previsível.
Perguntas frequentes sobre o Qwen3.8 27B em Q2
O que é o Underdog Saluki 27B?
É uma versão do Qwen3.8-27B comprimida para cerca de 2 bits, com arquivo de 7,89 GB, publicada pela Underdog no Hugging Face com licença Apache 2.0. Ela foi ajustada para manter a chamada de ferramentas, usada por agentes de IA.
O Saluki roda em placa de vídeo de 8 GB?
O arquivo cabe, mas sobra pouco espaço para o contexto. Com 8 GB, só com contexto pequeno e sem o arquivo de visão. Uma placa de 10 a 12 GB é o mínimo confortável; num teste independente, com 65 mil tokens de contexto, o uso medido foi de 12,3 GB.
O Saluki é melhor que o Qwen3.8 27B original?
Em chamada de ferramentas, segundo o fabricante: 88 contra 84 acertos em 120 tarefas. Em matemática e raciocínio longo, não: no AIME 2025 foram 79,2 contra 96,7. Um teste independente de programação com raciocínio ligado deu 76,7% contra 91,7% do modelo de origem.
Qual a diferença entre Q2 e Q4?
É quantos bits guardam cada peso do modelo. O Q4 (4 bits) do Qwen3.8 27B tem cerca de 17 GB e empata com o modelo completo em testes de programação; o Q2 (2 bits) cai para perto de 8 GB e perde precisão, principalmente em raciocínio.
Como rodar o Qwen3.8 27B Q2 no PC?
Baixe o arquivo GGUF do Saluki no Hugging Face e rode com o llama.cpp: llama-server -m Underdog-Saluki-27B-1.0-IQ2-mix.gguf –jinja -ngl 99 -fa on -c 32768. Programas feitos sobre o llama.cpp também abrem o arquivo GGUF.
Você trocaria um modelo menor por um de 27B comprimido em 2 bits? Conta aqui nos comentários.
Resumo
- O Underdog Saluki põe o Qwen3.8-27B num arquivo de 7,89 GB (2 bits), contra 54 GB do modelo completo; licença Apache 2.0.
- Segundo o fabricante, ele acerta mais chamadas de ferramenta que o original (88 × 84) e perde em matemática (AIME 2025: 79,2 × 96,7).
- Um teste independente de programação com raciocínio ligado deu 76,7% contra 91,7% do modelo de origem; quase todas as falhas foram respostas vazias.
- Arquivo de 8 GB não é placa de 8 GB: 10 a 12 GB é o mínimo confortável.
- Na nossa bancada, o Qwen3.8 27B de 4 bits (17,6 GB) roda a 21,7 tokens por segundo, ou 33,8 com MTP, em duas placas.
Fontes
- Hugging Face: ConwayResearch/Underdog-Saluki-27B-1.0 (página do modelo)
- MarkTechPost: Meet the Underdog Saluki 27B, a 2-bit Qwen3.8-27B that beats the original at tool calling (09/10/2026)
- zephel01 (note.com): teste do Underdog-Saluki-27B com 60 problemas × 5 rodadas (09/10/2026, em japonês)
- Quesma: Qwen3.8 27B quantizations benchmarked
- Hugging Face: Qwen/Qwen3.8-27B (modelo original)