O JetBrains Mellum 2.1 é o novo modelo aberto da empresa que faz o IntelliJ IDEA e o PyCharm, e foi feito para uma tarefa específica: servir de cérebro para agentes de programação rodando no seu próprio computador. Lançado na quarta-feira (8), ele tem 12 bilhões de parâmetros, mas usa só 2,5 bilhões a cada token, vem com licença Apache 2.0 e já tem versões oficiais para llama.cpp, Ollama e LM Studio.
O salto em relação à versão anterior é grande, e a própria JetBrains mostra onde ele ainda perde para o concorrente direto, o Qwen3.5-9B. Esse concorrente a gente mediu na bancada do Laboratório, então dá para colocar os números lado a lado. Neste texto: o que é o Mellum 2.1, onde ele ganha, onde perde, quanta placa precisa e como usar como IA local para programar.
O que é o JetBrains Mellum 2.1
É um modelo de linguagem do tipo MoE (mistura de especialistas): por dentro, ele tem 64 “especialistas”, e cada pedaço de texto passa por apenas 8 deles. Por isso, dos 12 bilhões de parâmetros, só 2,5 bilhões trabalham a cada token, o que deixa a resposta mais rápida do que a de um modelo denso do mesmo tamanho. A janela de contexto é de 131 mil tokens, e por enquanto só existe a versão “Thinking”, que raciocina antes de responder.
A arquitetura é a mesma do Mellum 2, aberto em junho. O que mudou foi o treino depois do pré-treino, quase todo por aprendizado por reforço: segundo o blog da JetBrains, o modelo passou por milhões de execuções em ambientes isolados, mexendo em repositórios de código reais, rodando comandos no terminal, editando arquivos e ganhando “pontos” quando os testes passavam. É como treinar um estagiário dentro do projeto, e não só com exercícios de livro.
| Item | Mellum 2.1 |
|---|---|
| Fabricante | JetBrains (IntelliJ IDEA, PyCharm, Kotlin) |
| Parâmetros | 12 bilhões no total, 2,5 bilhões ativos por token (MoE, 64 especialistas, 8 ativos) |
| Contexto | 131.072 tokens |
| Versão | Só “Thinking” (raciocina antes de responder) |
| Licença | Apache 2.0 (uso comercial liberado) |
| Arquivos para PC | GGUF oficial de 7,0 GB a 12,9 GB |
| Lançamento | 8 de outubro de 2026 |
Onde o Mellum 2.1 ganha e onde perde para o Qwen3.5-9B
Resposta direta: ele ganha nas tarefas curtas de programação e perde nas tarefas longas dentro de um projeto de verdade. No LiveCodeBench v6, de problemas de programação, fez 82,0 contra 75,4 do Qwen3.5-9B. No SWE-bench Verified, que mede se o modelo resolve problemas reais em repositórios do GitHub, saiu de 2% no Mellum 2 para 47%, mas ainda fica atrás dos 50% do Qwen. No Terminal-Bench 2.1 e no SWE-bench Pro, a diferença a favor do Qwen é maior.
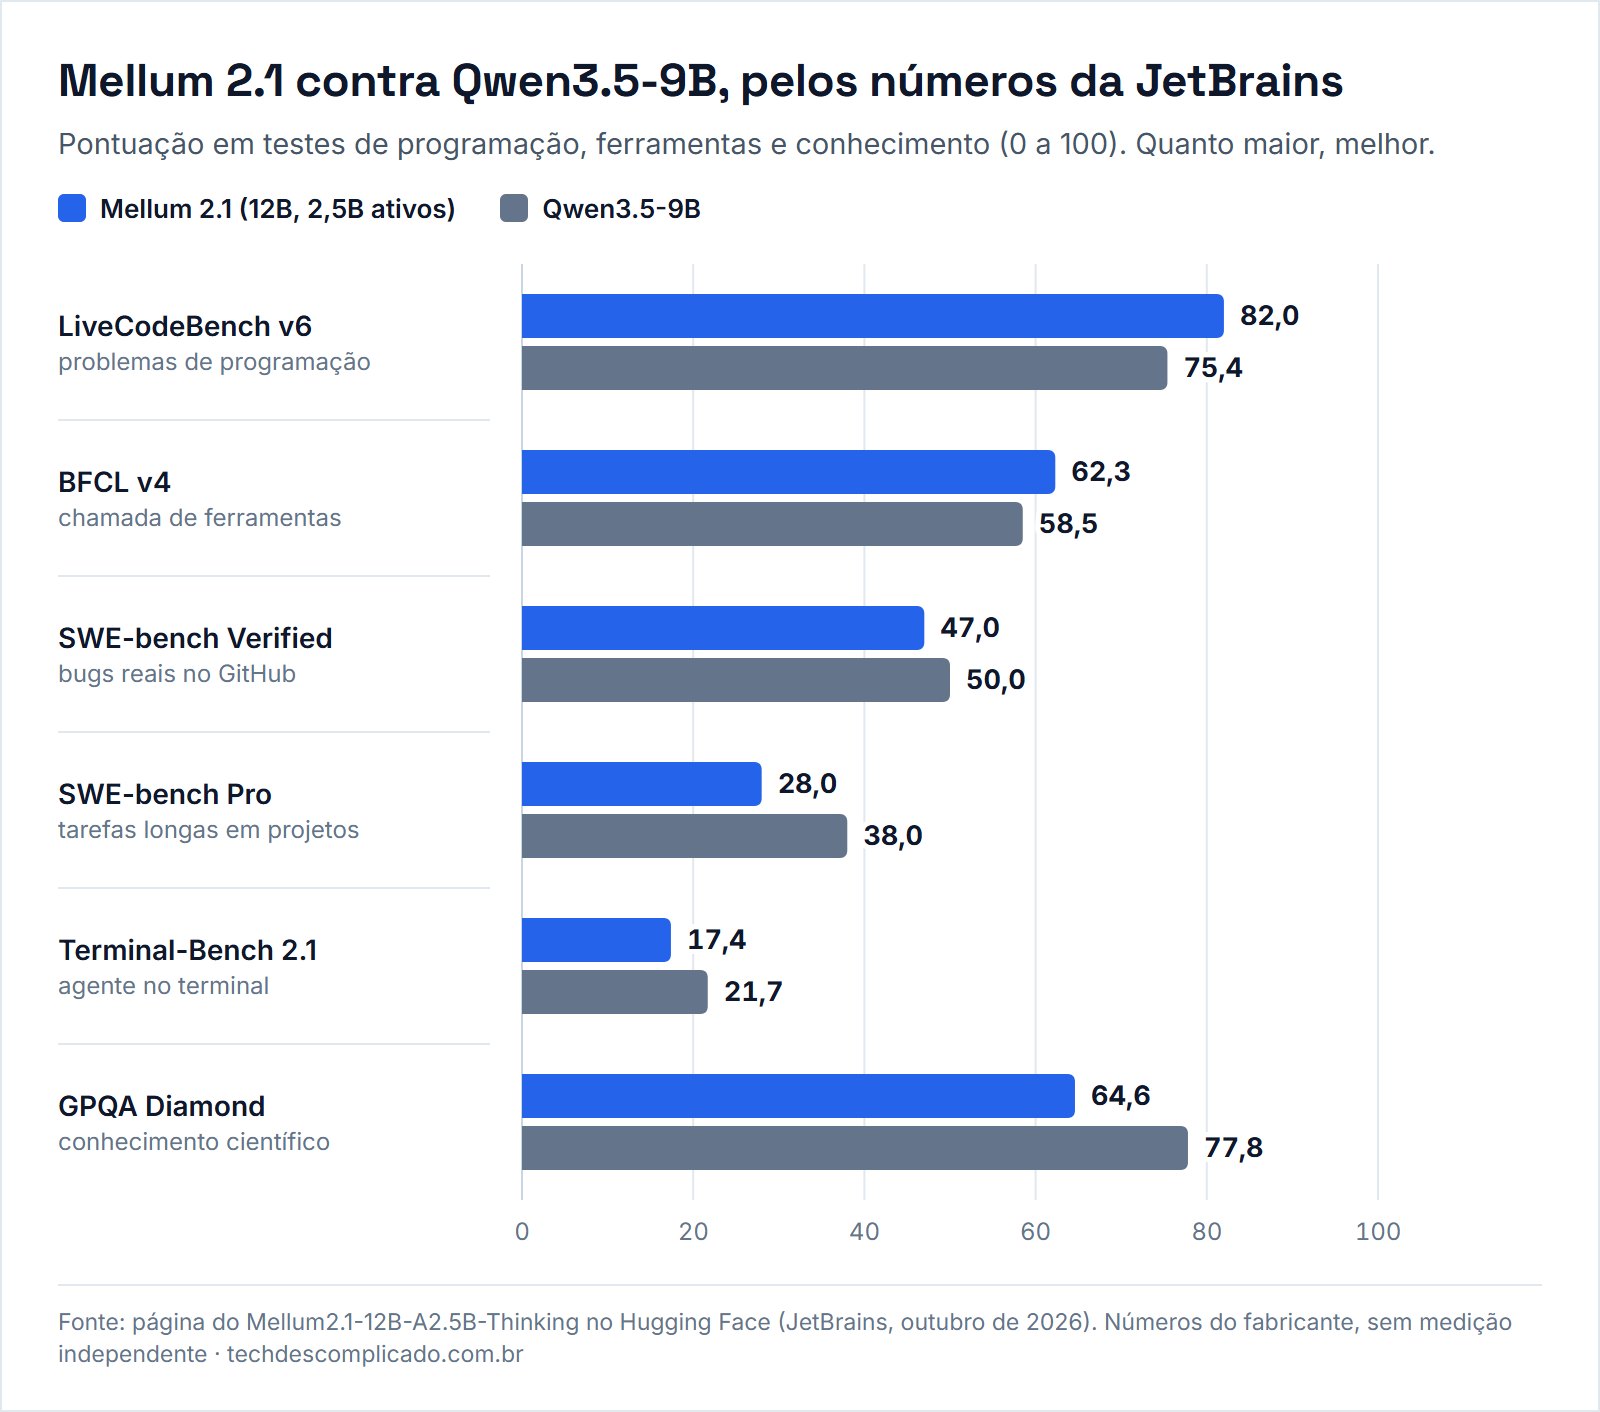
| Teste (números da JetBrains) | Mellum 2.1 | Mellum 2 | Qwen3.5-9B | Gemma 4 E4B |
|---|---|---|---|---|
| LiveCodeBench v6 | 82,0 | 69,4 | 75,4 | 69,4 |
| HumanEval+ | 91,5 | 90,9 | 89,6 | 89,1 |
| SWE-bench Verified | 47,0 | 2,0 | 50,0 | 23,0 |
| SWE-bench Pro | 28,0 | 0,0 | 38,0 | 4,0 |
| Terminal-Bench 2.1 | 17,4 | 0,6 | 21,7 | 3,4 |
| BFCL v4 (chamada de ferramentas) | 62,3 | 49,6 | 58,5 | 52,5 |
| GPQA Diamond (conhecimento científico) | 64,6 | 51,0 | 77,8 | 53,1 |
| HarmBench (menor é melhor) | 8,5 | 21,5 | 6,6 | 38,1 |
Duas leituras importantes. Primeira: no conhecimento geral (GPQA), o Qwen3.5-9B segue bem à frente, o que faz sentido para um modelo focado em código. Segunda: no HarmBench, que mede quanto o modelo obedece a pedidos perigosos, o Mellum caiu de 21,5 para 8,5, perto do Qwen. A JetBrains também afirma que, numa placa de servidor H200 sob carga alta, o Mellum 2.1 entrega quase o dobro de tokens por segundo que o Qwen3.5-9B, e que a previsão de vários tokens de uma vez (MTP) deixa um pedido isolado cerca de 1,6 vez mais rápido.
IA local para programar: quanta placa o Mellum 2.1 precisa
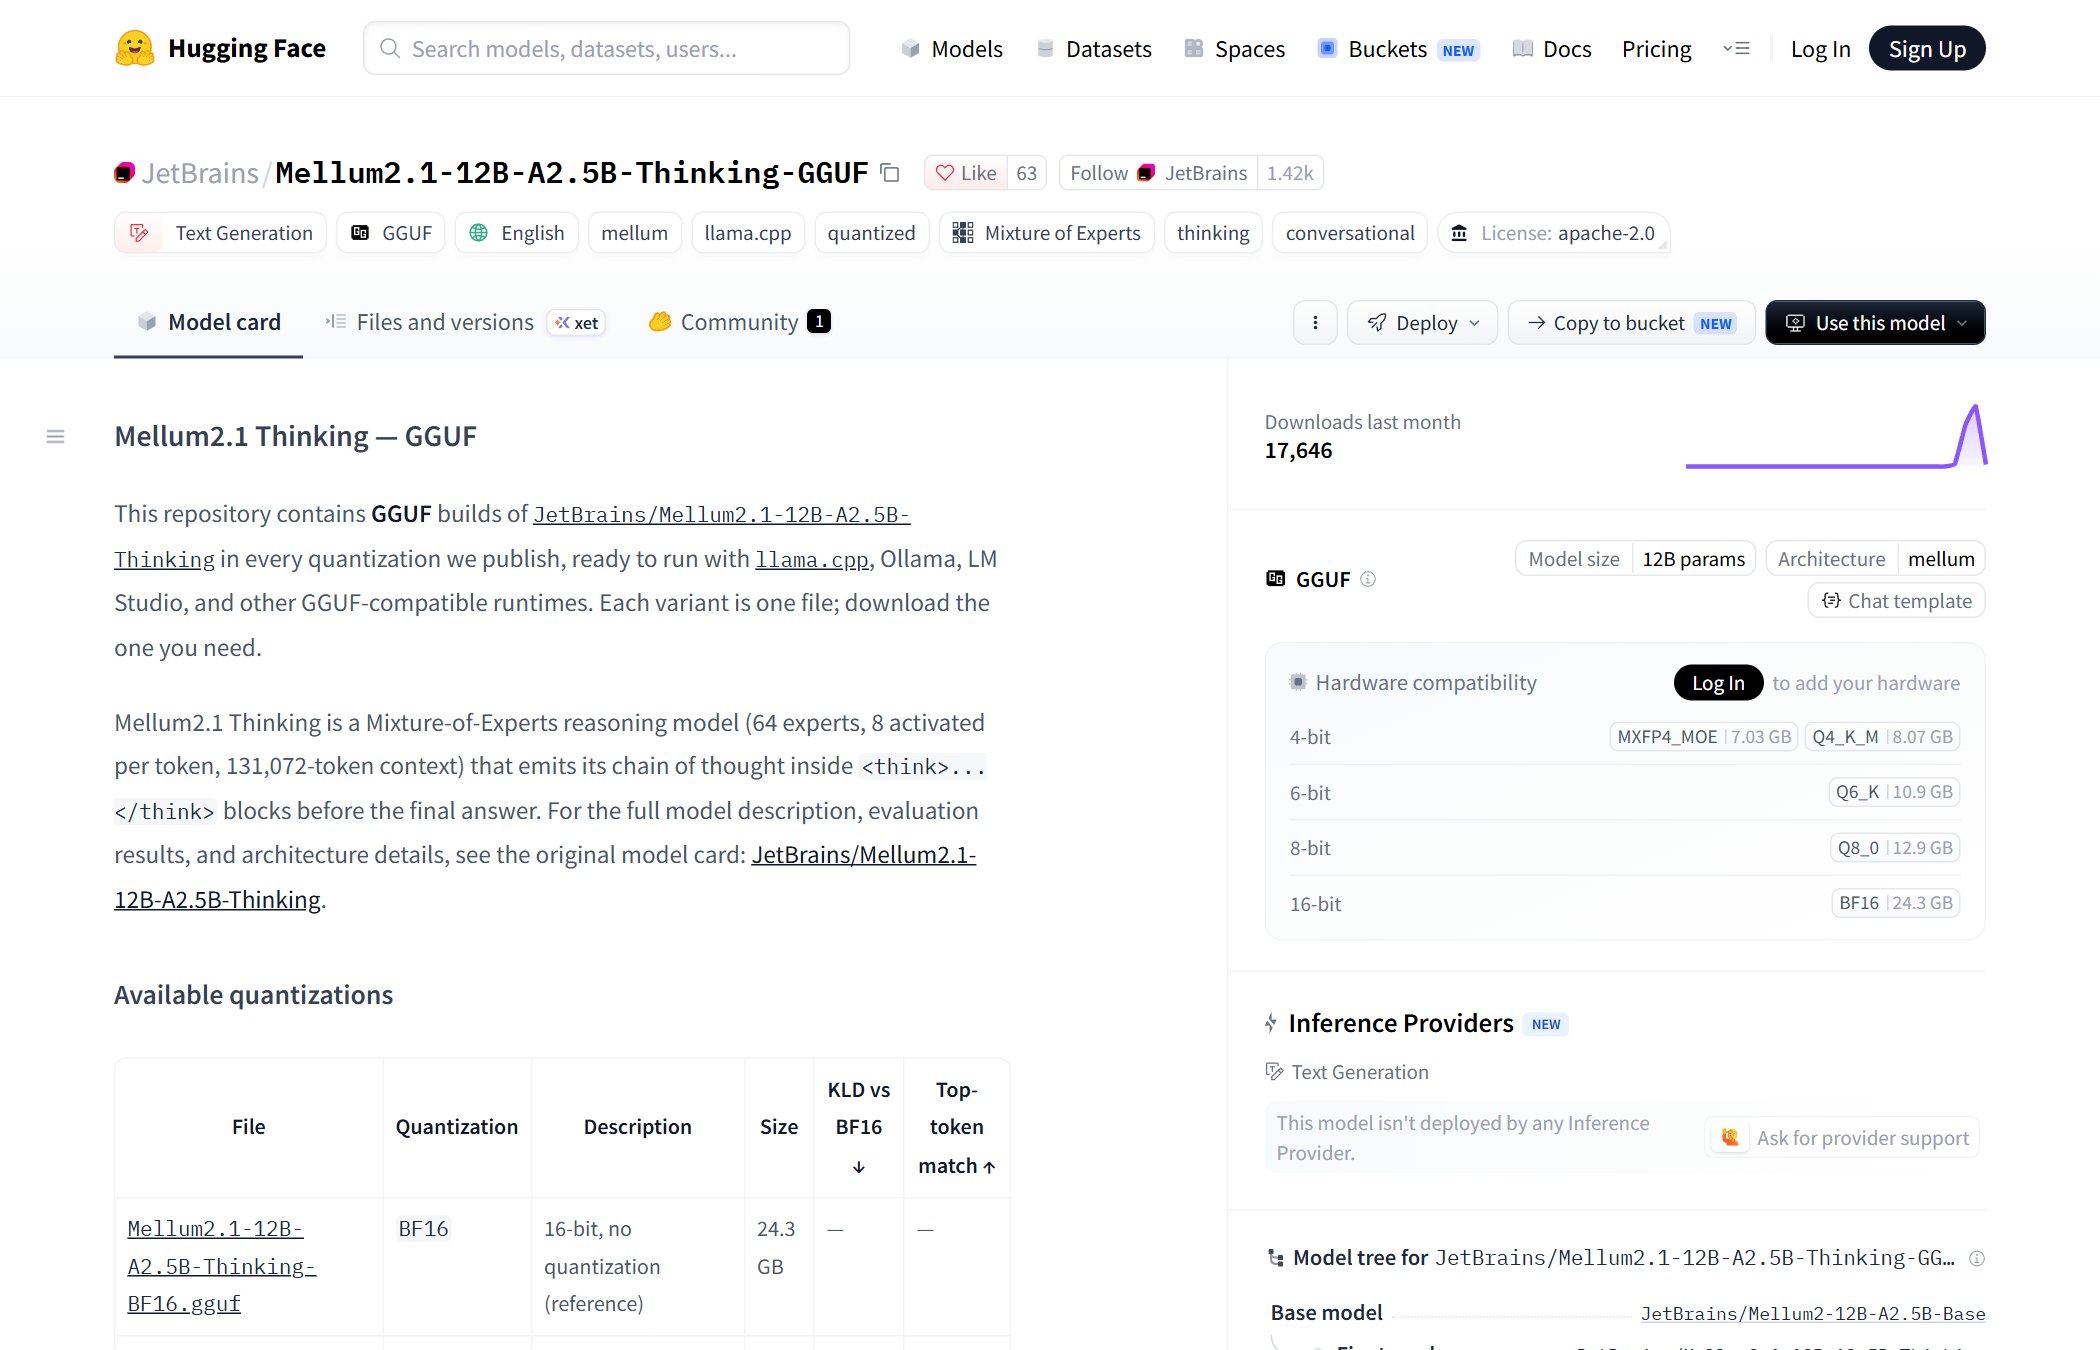
A JetBrains publicou um repositório oficial com os arquivos GGUF, o formato usado pelo llama.cpp, pelo Ollama e pelo LM Studio. A versão recomendada, Q4_K_M, tem 8,1 GB. Somando o contexto, uma placa de 12 GB é o ponto confortável; com 8 GB, dá para tentar a versão MXFP4 (7,0 GB) com contexto curto. Por ser MoE, ele também tolera melhor deixar parte do modelo na memória RAM do que um modelo denso.
| Arquivo | Tamanho | Fidelidade ao original* | Placa indicada |
|---|---|---|---|
| Q8_0 | 12,9 GB | 96,1% | 16 GB |
| Q6_K | 10,9 GB | 93,9% | 12 a 16 GB |
| Q4_K_M (recomendado) | 8,1 GB | 88,0% | 12 GB |
| MXFP4_MOE (menor) | 7,0 GB | 85,6% | 8 GB, com contexto curto |
Para comparar, o Qwen3.5-9B em Q6_K (7,5 GB) é um dos modelos que mais rodamos no Laboratório de IA. Os números dele na nossa bancada ajudam a calibrar o que esperar de um modelo desse porte:
| Onde rodou o Qwen3.5-9B (Q6_K) | Escrita | Observação |
|---|---|---|
| RX 9070 XT (16 GB) | 72,4 tokens/s | teste PULSE do Laboratório, 09/10/2026 |
| Intel Arc B580 (12 GB) | 46,7 tokens/s | llama-bench, 11/10/2026 |
| Só o processador (6 núcleos) | 8,0 tokens/s | llama-bench, 11/10/2026 |
| Teste de agente (Agente CSV) | nota 10 e 8,3 | duas rodadas, 09/10/2026 |
Como o Mellum ativa 2,5 bilhões de parâmetros por token, contra 9 bilhões do Qwen3.5-9B, a expectativa é que ele escreva mais rápido na mesma placa. Mas expectativa não é número: a gente só publica a velocidade depois de medir. Se você ainda está escolhendo a placa, os preços de hoje estão no guia de placa de vídeo para IA custo-benefício.
Como rodar o Mellum 2.1 no llama.cpp, no Ollama e no LM Studio
São três caminhos, todos com o arquivo oficial. No llama.cpp, este comando baixa a versão Q4_K_M e sobe um servidor compatível com a API da OpenAI em http://localhost:8080/v1, com as configurações recomendadas pela JetBrains:
llama-server -hf JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF:Q4_K_M --ctx-size 131072 --temp 0.6 --top-p 0.95 --top-k 20Com pouca memória, troque --ctx-size 131072 por 32768. No Ollama, o comando é ollama run hf.co/JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF:Q4_K_M. No LM Studio, basta buscar “Mellum2.1” na aba de modelos; se é a sua primeira vez, o passo a passo está em como rodar IA localmente no PC.
Para virar assistente de programação, o servidor local pode ser ligado a ferramentas que aceitam a API da OpenAI, como Continue, Cline, Aider ou OpenCode. É aí que o treino em repositórios reais do Mellum deveria aparecer: explorar o projeto, editar arquivos e rodar os testes.
O olhar de QA
De 2% para 47% no SWE-bench Verified é o tipo de salto que pede segunda conferência, e não por desconfiança da JetBrains. Quando um modelo é treinado com recompensa por “fazer o teste passar”, ele aprende a fazer o teste passar, e isso nem sempre é o mesmo que corrigir o problema. Agente que apaga ou afrouxa o teste que falhava e declara vitória é um defeito conhecido desse tipo de treino. Por isso o detalhe que mais me interessa é o tipo de tarefa: o Mellum ganha nas curtas e perde nas longas, que são justamente as do dia a dia num projeto grande. Para mim, ele tem cara de subagente rápido, que resolve tarefas pequenas e bem delimitadas para um modelo maior, e não de agente principal. E o fato de a JetBrains publicar a tabela mostrando onde perde para o Qwen é um bom sinal: fornecedor que mostra a derrota costuma ser mais confiável na vitória.
Perguntas frequentes sobre o JetBrains Mellum 2.1
O que é o Mellum 2.1?
É um modelo de IA aberto da JetBrains, lançado em 8 de outubro de 2026, feito para agentes de programação. Tem 12 bilhões de parâmetros, dos quais 2,5 bilhões trabalham por token (arquitetura MoE), contexto de 131 mil tokens e licença Apache 2.0.
O Mellum 2.1 é gratuito?
Sim. Os pesos estão no Hugging Face com licença Apache 2.0, que permite usar, modificar e usar comercialmente. Você paga só o hardware e a energia de quem roda.
Quanto de VRAM o Mellum 2.1 precisa?
A versão recomendada (Q4_K_M) tem 8,1 GB; com o contexto, uma placa de 12 GB é o ponto confortável. A menor versão (MXFP4, 7,0 GB) pode rodar em 8 GB com contexto curto.
Dá para usar o Mellum 2.1 no Ollama e no LM Studio?
Dá. A JetBrains publicou os arquivos GGUF oficiais. No Ollama: ollama run hf.co/JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF:Q4_K_M. No LM Studio, é só buscar “Mellum2.1” na aba de modelos.
O Mellum 2.1 é melhor que o Qwen3.5-9B?
Depende da tarefa. Pelos números da JetBrains, ele ganha em problemas curtos de programação (LiveCodeBench v6: 82,0 contra 75,4) e em chamada de ferramentas, e perde em tarefas longas em repositórios (SWE-bench Verified: 47 contra 50) e em conhecimento geral.
Qual a melhor IA local para programar?
Não existe uma só. Para placas de 12 a 16 GB, modelos como o Qwen3.5-9B e agora o Mellum 2.1 são bons candidatos; com mais memória, modelos maiores de código rendem mais. O melhor teste é rodar as suas próprias tarefas, no seu PC.
O que é a JetBrains?
É uma empresa de software com sede em Praga, na República Tcheca, conhecida pelas IDEs IntelliJ IDEA e PyCharm e pela linguagem Kotlin.
Você usaria um modelo local como assistente de programação no lugar de um pago? Conta aqui nos comentários.
Resumo
- A JetBrains lançou em 8/10 o Mellum 2.1, modelo aberto (Apache 2.0) para agentes de programação: 12B de parâmetros, 2,5B ativos por token, contexto de 131 mil tokens.
- O treino por reforço em repositórios reais levou o SWE-bench Verified de 2% para 47%; o Qwen3.5-9B ainda faz 50%.
- Ele ganha em tarefas curtas (LiveCodeBench v6: 82,0 × 75,4) e perde em tarefas longas e conhecimento geral.
- O GGUF oficial vai de 7,0 GB a 12,9 GB; a versão recomendada, de 8,1 GB, roda bem numa placa de 12 GB.
- Na nossa bancada, o rival Qwen3.5-9B escreve a 72,4 tokens/s na RX 9070 XT e a 46,7 na Arc B580; o Mellum ainda não foi medido.
Fontes
- Blog da JetBrains: Mellum2.1 gets to work, a fast open model for coding agents (outubro de 2026)
- Hugging Face: JetBrains/Mellum2.1-12B-A2.5B-Thinking (página do modelo, com a tabela de testes)
- Hugging Face: JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF (arquivos oficiais e comandos)
- MarkTechPost: JetBrains releases Mellum2.1, a 12B MoE open model for coding agents (08/10/2026)
- DataNorth: Mellum2.1 resolve quase metade dos bugs (em holandês)