O Nemotron 3.5 Bolt, modelo de IA aberto da NVIDIA para rodar agentes no próprio computador, chegou ao Hugging Face nesta quinta-feira (15). São 74 bilhões de parâmetros espremidos em um arquivo de 22 GB, com licença aberta que permite uso comercial e suporte no llama.cpp e no Ollama desde o primeiro dia.
Agora que os arquivos estão no ar, dá para trocar o anúncio pelos fatos: o Bolt também enxerga imagens e vídeo, nasceu da compressão de um modelo maior e veio com uma tabela de testes que inclui a comparação entre a versão de 2 bits e a original. Neste texto: o que é o Nemotron 3.5 Bolt, como ele cabe em 24 GB, quanta placa de vídeo ele pede de verdade e como rodar.
O que é o Nemotron 3.5 Bolt
É um modelo do tipo MoE (mistura de especialistas) com 74 bilhões de parâmetros no total, dos quais cerca de 9 bilhões trabalham a cada token. A arquitetura mistura camadas Mamba-2, que gastam pouca memória com conversas longas, com camadas de atenção, e o contexto vai até 256 mil tokens. O Bolt aceita texto, imagem e vídeo e responde em texto, inclusive em português do Brasil, que está na lista oficial de idiomas.
O Bolt não foi treinado do zero. A NVIDIA pegou o Nemotron 3.5 Super VL, de 120 bilhões de parâmetros, que também saiu hoje, e usou uma técnica chamada Star Elastic para cortar especialistas e camadas até o modelo caber no alvo de memória. Depois vieram rodadas de treino para recuperar a visão e o desempenho como agente.
| Item | Nemotron 3.5 Bolt 74B-A9B 24GB |
|---|---|
| Tipo | MoE híbrido (Mamba-2 + atenção), 74 bilhões de parâmetros, cerca de 9 bilhões ativos |
| Origem | Comprimido do Nemotron 3.5 Super VL 120B-A12B |
| Entrada e saída | Texto, imagem e vídeo na entrada; texto na saída |
| Contexto | até 256 mil tokens |
| Arquivos (GGUF) | modelo 22,02 GB + visão 1,73 GB + rascunho DFlash 1,0 GB |
| Licença | OpenMDW-1.1 (uso comercial e não comercial liberado) |
| Onde roda | llama.cpp (build b11669 ou mais novo), Ollama (nemotron-3.5-bolt), LM Studio |
| Lançamento | 15 de outubro de 2026 |
Como um modelo de 74B cabe em 24 GB
O segredo é a compressão em 2 bits feita junto com o treino. Normalmente, o modelo é treinado com números de alta precisão e só depois é “espremido” para caber no PC, e é nessa compressão que ele perde qualidade. No Bolt, os especialistas foram convertidos para o formato IQ2_XXS (cerca de 2 bits por parâmetro) com uma etapa de destilação ciente da quantização, a QAD: o modelo comprimido aprende a imitar o original e se adapta à perda. É o mesmo princípio da Gemma 4 em versão QAT que usamos no Laboratório de IA.
E deu certo, pelos números da própria NVIDIA. Na comparação entre a versão de 2 bits e a original (BF16), o Bolt comprimido manteve quase toda a nota: 50,98 contra 53,93 no Terminal-Bench 2.1, 86,43 contra 88,83 no GPQA Diamond e 66,75 contra 70,00 no BrowseComp. No WebArena com visão, a versão de 2 bits ficou até um pouco à frente (50,86 contra 50,25).
| Teste | Bolt 24GB (2 bits) | Bolt original (BF16) | Qwen3.6-35B-A3B | Gemma 4 26B-A4B | Nemotron 3.5 Lightning 30B |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 (agente no terminal) | 50,98 | 53,93 | 44,38 | 37,22 | 23,46 |
| MCP-Atlas (uso de ferramentas) | 52,20 | 55,60 | 51,20 | — | 46,40 |
| BrowseComp (pesquisa na web) | 66,75 | 70,00 | 48,74 | 26,30 | 36,81 |
| GPQA Diamond (ciência) | 86,43 | 88,83 | 83,40 | 79,61 | 75,57 |
| SciCode (programação científica) | 41,02 | 44,49 | 35,33 | 40,28 | 31,38 |
| AA-Omniscience: não alucinar | 61,27 | 56,14 | 65,85 | 14,22 | 68,81 |
Dois cuidados na leitura. Primeiro, todos esses números foram medidos pela própria NVIDIA. Segundo, a comparação é desigual a favor dos rivais: Qwen3.6, Gemma 4 e Lightning aparecem na versão completa, sem compressão, enquanto o Bolt aparece em 2 bits. Mesmo assim, ele vence a maioria das linhas. A exceção que chama atenção é a de alucinação: no teste que mede quantas vezes o modelo evita inventar resposta, o Bolt marca 61,27, abaixo do Qwen3.6 (65,85) e do Lightning (68,81).
Nemotron 3.5 Bolt roda no meu PC? Quanta placa precisa
O nome “24GB” fala do tamanho do modelo, não da placa. As duas receitas oficiais da NVIDIA para o llama.cpp pedem mais: a de 28 GB (64 mil tokens de contexto) foi pensada para placas de 32 GB ou para os notebooks RTX Spark de 64 GB, e a de 32 GB (contexto completo de 256 mil) para placas de 48 GB ou mais. Os 22 GB do modelo somam com a visão (1,73 GB), o rascunho que acelera as respostas (1,0 GB) e a memória da conversa.
| Configuração | O que esperar | Por quê |
|---|---|---|
| Placa de 48 GB ou mais (ou RTX Spark de 128 GB) | Roda inteiro, com os 256 mil tokens | Receita oficial de 32 GB |
| Placa de 32 GB (ou RTX Spark de 64 GB) | Roda inteiro, com 64 mil tokens | Receita oficial de 28 GB, com memória da conversa comprimida (q8) |
| Duas placas somando 28 GB (RX 9070 XT + Arc B580) | Roda inteiro, com 128 mil tokens (medido) | Com 160 mil tokens, transbordou e caiu para cerca de 3 tokens por segundo |
| Placa de 24 GB | Só sem visão e sem o rascunho, com contexto curto | Sobram cerca de 2 GB depois do modelo |
| Placa de 16 GB + RAM | Roda, bem mais devagar | Parte do modelo vai para a RAM; por ser MoE, tolera melhor que um denso |
Se você está escolhendo hardware, o guia de quanta VRAM a placa de vídeo precisa para IA local e o de duas placas de vídeo no llama.cpp ajudam a fazer a conta.
Nemotron 3.5 Bolt na nossa bancada: 61 tokens por segundo
Baixamos o Bolt no mesmo dia e rodamos nas duas placas da bancada, uma RX 9070 XT de 16 GB e uma Intel Arc B580 de 12 GB, com o llama.cpp b11669. Ele carregou inteiro com 128 mil tokens de contexto e escreveu a 45,8 tokens por segundo sem ajuda; com o rascunho LiLiCorr adivinhando 4 tokens por vez, subiu para 61,3 em código e 48,3 em texto. Para comparar, o Qwen3-Coder-Next de 80B, que precisa usar a RAM, roda a cerca de 31 tokens por segundo aqui.
Duas surpresas. A primeira: a receita da NVIDIA, com rascunho de 6 tokens, foi a mais lenta das versões com rascunho no nosso PC (50,9 em código e 41,1 em texto), porque cada palpite errado custa tempo; com 3 ou 4, o rascunho acerta mais e o ganho aparece. A segunda: com 160 mil tokens de contexto, a memória das placas estourou, o sistema passou a usar a RAM compartilhada e a velocidade despencou para cerca de 3 tokens por segundo. No Bolt, os 28 GB da bancada param em 128 mil.
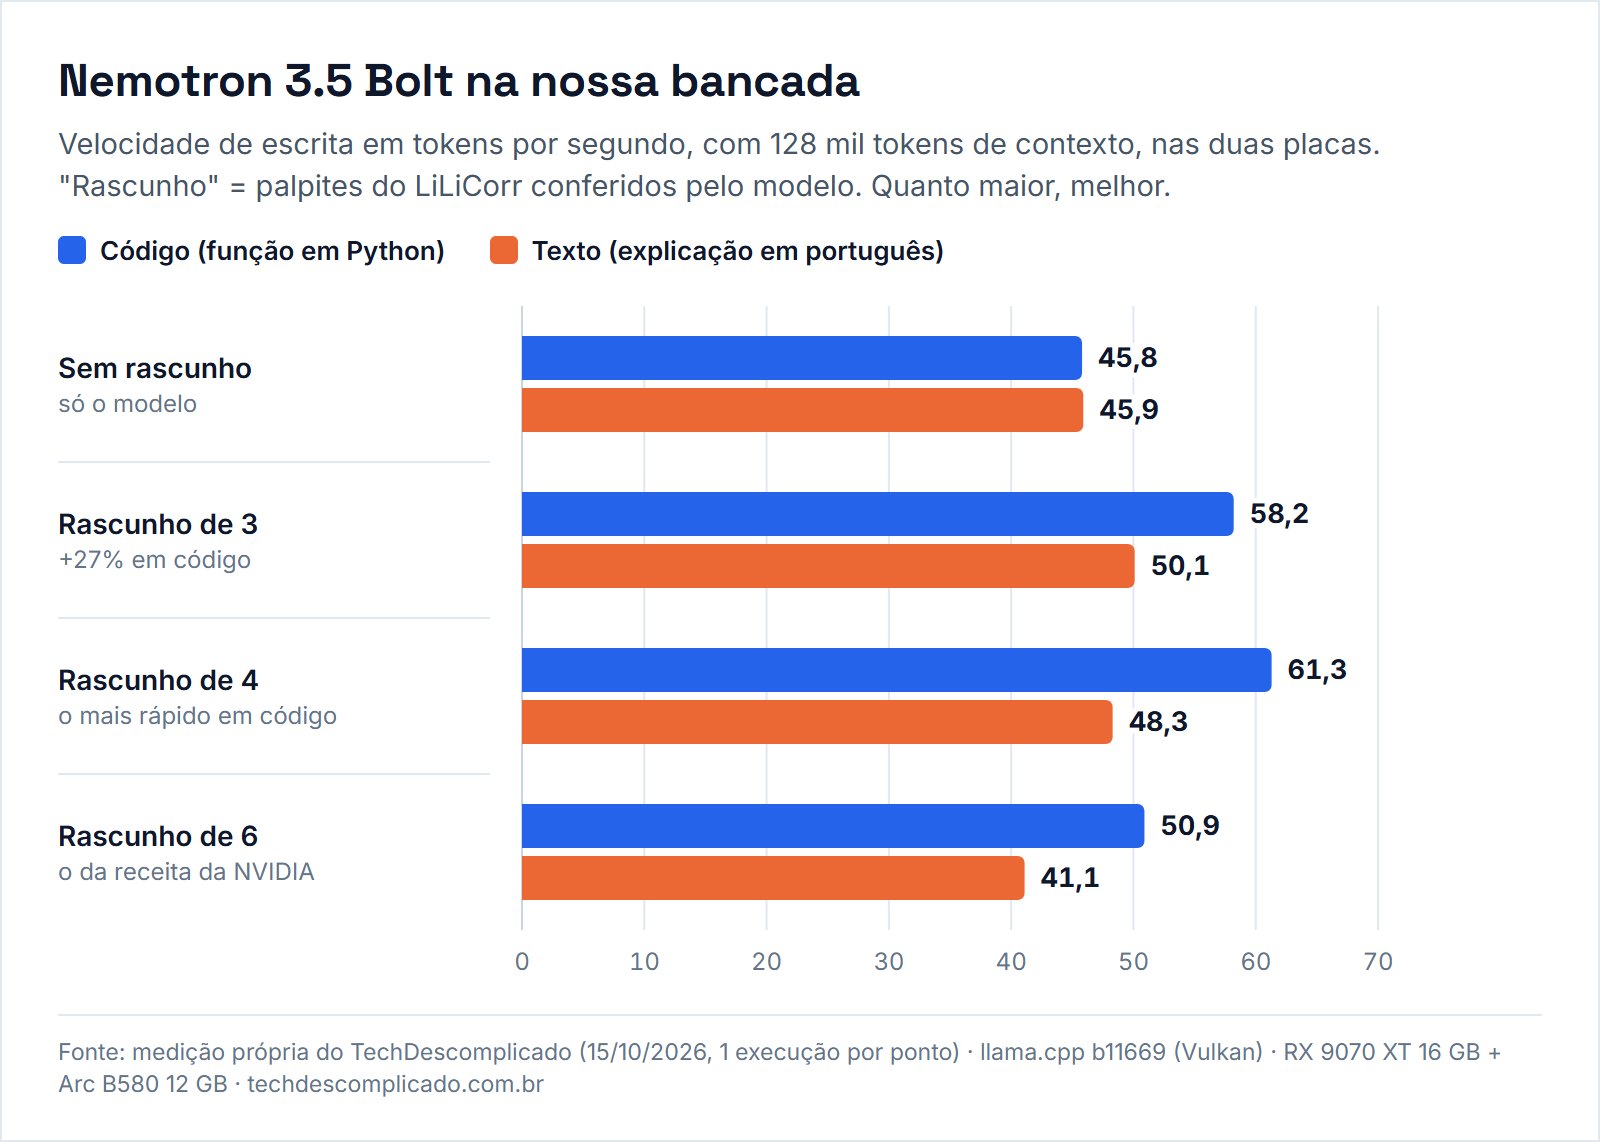
Isso é velocidade, não qualidade. O Bolt já está configurado para entrar nos mesmos testes de jogos e de agente do Laboratório de IA, e os resultados aparecem lá quando a rodada terminar. Se você quer entender por que duas placas às vezes perdem para uma, o teste de uma ou duas placas de vídeo para IA mostra a conta.
Como rodar o Nemotron 3.5 Bolt no Ollama e no llama.cpp
No Ollama, o modelo já está na biblioteca oficial com o nome nemotron-3.5-bolt (cerca de 24 GB): basta rodar ollama run nemotron-3.5-bolt. No llama.cpp, o suporte à arquitetura entrou nesta quinta-feira, e o primeiro build oficial com ele é o b11669. Versões anteriores não carregam o modelo, então atualize antes de baixar os 22 GB.
A NVIDIA recomenda temperatura 1.0 e top-p 0.95 para todos os usos, e o modelo pensa antes de responder por padrão (dá para desligar pelo modelo de conversa, com enable_thinking). A receita oficial do llama.cpp liga o rascunho LiLiCorr, que adivinha até 6 ou 7 tokens à frente para o modelo principal só conferir, uma forma de ganhar velocidade sem mudar a resposta.
Nemotron 3.5 Bolt e os notebooks RTX Spark
O Bolt é a vitrine do lançamento dos notebooks com RTX Spark, que a NVIDIA diz chegarem às lojas nesta sexta-feira (16). Os preços ficam com os fabricantes. Já falamos desse chip quando a Microsoft apresentou o Surface Laptop Ultra com RTX Spark. O irmão menor, o Bolt E4B, de cerca de 4 GB e voltado para assistentes de voz e personagens de jogos, está anunciado para 23 de outubro.
O olhar de QA
Promessa de lançamento eu leio como requisito sem critério de aceite: soa bem, mas do jeito que está escrita não dá para testar. “Mais rápido que a maioria dos densos e mais inteligente que a maioria dos MoE do mesmo tamanho” cabe em qualquer anúncio. Eu queria ver três coisas antes de chamar o Bolt de bom: a tabela de testes com os concorrentes do mesmo tamanho, a comparação entre a versão de 2 bits e a original (quanto a compressão preservou de verdade) e o desempenho em tarefa de agente, que é a promessa principal. O que já merece elogio é a abertura: pesos, dados de treino e receitas públicos permitem que qualquer pessoa confira o que a NVIDIA diz, e isso vale mais do que qualquer gráfico de lançamento.
No dia do lançamento, a NVIDIA entregou as duas primeiras: a tabela está lá e a versão de 2 bits perdeu pouco para a original. A terceira continua em aberto, porque teste de agente medido pelo fabricante é o laudo do próprio réu. E a linha da alucinação eu não deixaria passar: um modelo feito para agir sozinho, que inventa resposta com mais frequência que o Qwen3.6, precisa de supervisão justamente onde promete autonomia. O Bolt já está baixado aqui, e a bancada vai dizer se ele sustenta a promessa nos mesmos testes que usamos com os outros modelos.
Perguntas frequentes sobre o Nemotron 3.5 Bolt
O que é o Nemotron 3.5 Bolt?
É um modelo de IA aberto da NVIDIA, lançado em 15 de outubro de 2026, para agentes que rodam no próprio computador. Tem 74 bilhões de parâmetros (cerca de 9 bilhões ativos por token), entende texto, imagem e vídeo e cabe em um arquivo de 22 GB graças à compressão em 2 bits.
O Nemotron 3.5 Bolt é grátis?
Sim. Os pesos estão no Hugging Face com a licença OpenMDW-1.1, que permite uso comercial e não comercial. A NVIDIA também publicou os conjuntos de dados de treino.
Quanta VRAM o Nemotron 3.5 Bolt precisa?
O modelo tem 22 GB, mais 1,73 GB da visão e 1,0 GB do rascunho que acelera as respostas. As receitas oficiais pedem uma placa de 32 GB (64 mil tokens de contexto) ou de 48 GB ou mais (256 mil tokens). Em placa de 24 GB, só sem visão e com contexto curto.
Dá para usar o Nemotron 3.5 Bolt no Ollama?
Sim, com o comando ollama run nemotron-3.5-bolt. No llama.cpp, é preciso o build b11669 ou mais novo, o primeiro com suporte à arquitetura.
Qual a diferença entre o Nemotron 3.5 Bolt e o Lightning?
O Lightning tem 30 bilhões de parâmetros com 3 bilhões ativos e só lê texto. O Bolt é maior (74B, cerca de 9B ativos), lê imagem e vídeo e vem comprimido em 2 bits; nos testes da NVIDIA, supera o Lightning em quase tudo, menos no de alucinação.
O Nemotron 3.5 Bolt fala português?
Sim. O português do Brasil está na lista oficial de idiomas do modelo, ao lado de inglês, espanhol, francês, alemão, italiano, japonês, hindi, coreano e chinês.
Você testaria o Nemotron 3.5 Bolt como agente no seu PC? Conta aqui nos comentários.
Resumo
- A NVIDIA lançou em 15/10 o Nemotron 3.5 Bolt: MoE de 74B com cerca de 9B ativos, que lê texto, imagem e vídeo, em um arquivo de 22 GB.
- Ele foi comprimido do Nemotron 3.5 Super VL 120B e quantizado em 2 bits com treino; nos testes da NVIDIA, perdeu pouco para a versão original.
- A licença OpenMDW-1.1 libera uso comercial; roda no Ollama (nemotron-3.5-bolt) e no llama.cpp a partir do build b11669.
- As receitas oficiais pedem placa de 32 GB ou mais; o “24GB” do nome é o tamanho do modelo, não da placa.
- No teste de alucinação da própria NVIDIA, ele fica atrás do Qwen3.6 e do Lightning.
Fontes
- Hugging Face: NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB GGUF (15/10/2026)
- Hugging Face: Nemotron 3.5 Bolt 74B-A9B BF16 (tabela 2 bits × original)
- Hugging Face: rascunho LiLiCorr para decodificação especulativa
- llama.cpp: build b11669, o primeiro com suporte ao Nemotron 3.5 Bolt e Super VL
- Ollama: nemotron-3.5-bolt
- NVIDIA: All systems go, global PC app ecosystem ready for NVIDIA RTX Spark (13/10/2026)