A Liquid AI lançou nesta terça (27/10) o LFM3, uma família de seis modelos de IA abertos com cerca de 2 bilhões de parâmetros cada, feitos para rodar no celular, no notebook e em placas pequenas como o Raspberry Pi. Colocamos o modelo de texto, o LFM3-1.7B, na nossa bancada no mesmo dia: ele escreveu a 284 tokens por segundo, o mais rápido que já medimos, usando só 2,1 GB de memória de vídeo com 128 mil tokens de contexto. Montou bem páginas de painel e de site, não conseguiu fazer nenhum dos quatro jogos funcionar e, no teste feito para o que ele promete (agir como assistente, com ferramentas), acertou 7 de 10 tarefas. Veja os números do nosso teste, o que cada modelo da família faz, como rodar e o que diz a licença.
O que é o LFM3 da Liquid AI
É a terceira geração dos Liquid Foundation Models, da startup americana nascida no MIT. Todos os seis modelos partem de uma mesma base (o LFM3-1.7B-Base, treinado com 22 trilhões de tokens) e usam uma arquitetura que a empresa chama de tri-híbrida: 24 camadas, sendo 13 de convolução curta, 5 de atenção com janela deslizante e 6 de atenção global. Na prática, é isso que deixa o modelo leve: a memória gasta com a conversa (o chamado KV cache) fica bem menor que a dos concorrentes do mesmo tamanho.
| Modelo | Para que serve | GGUF em 4 bits |
|---|---|---|
| LFM3-1.7B | Texto: conversa, agentes e chamada de ferramentas | 1,1 GB |
| LFM3-VL-2B | Entende imagem e vídeo | 1,1 GB + 0,2 a 0,4 GB do módulo de visão |
| LFM3-Audio-2B | Fala e áudio | disponível |
| LFM3-Omni-2B | Texto, imagem, vídeo e áudio na entrada; responde em texto ou voz | disponível |
| d1-2B e d1-omni-2B | Decisões estruturadas para robôs e dispositivos (derivados do VL e do Omni) | sem GGUF |
Testamos o LFM3 na nossa bancada: os resultados
O LFM3-1.7B passou pela mesma bateria do Laboratório de IA que usamos com todos os modelos: um teste de agente que precisa escrever e testar código sozinho, quatro jogos e duas páginas web, primeiro com ferramentas (dentro de um harness, o programa que deixa o modelo criar arquivos e rodar comandos) e depois sem ferramentas, em uma única resposta. Rodamos o arquivo Q4_K_M oficial na Radeon RX 9070 XT de 16 GB, sozinha, com a amostragem que a Liquid recomenda (temperatura 0,1, top-k 50, repetição 1,1), raciocínio ligado e 128 mil tokens de contexto.
| Medição | Resultado |
|---|---|
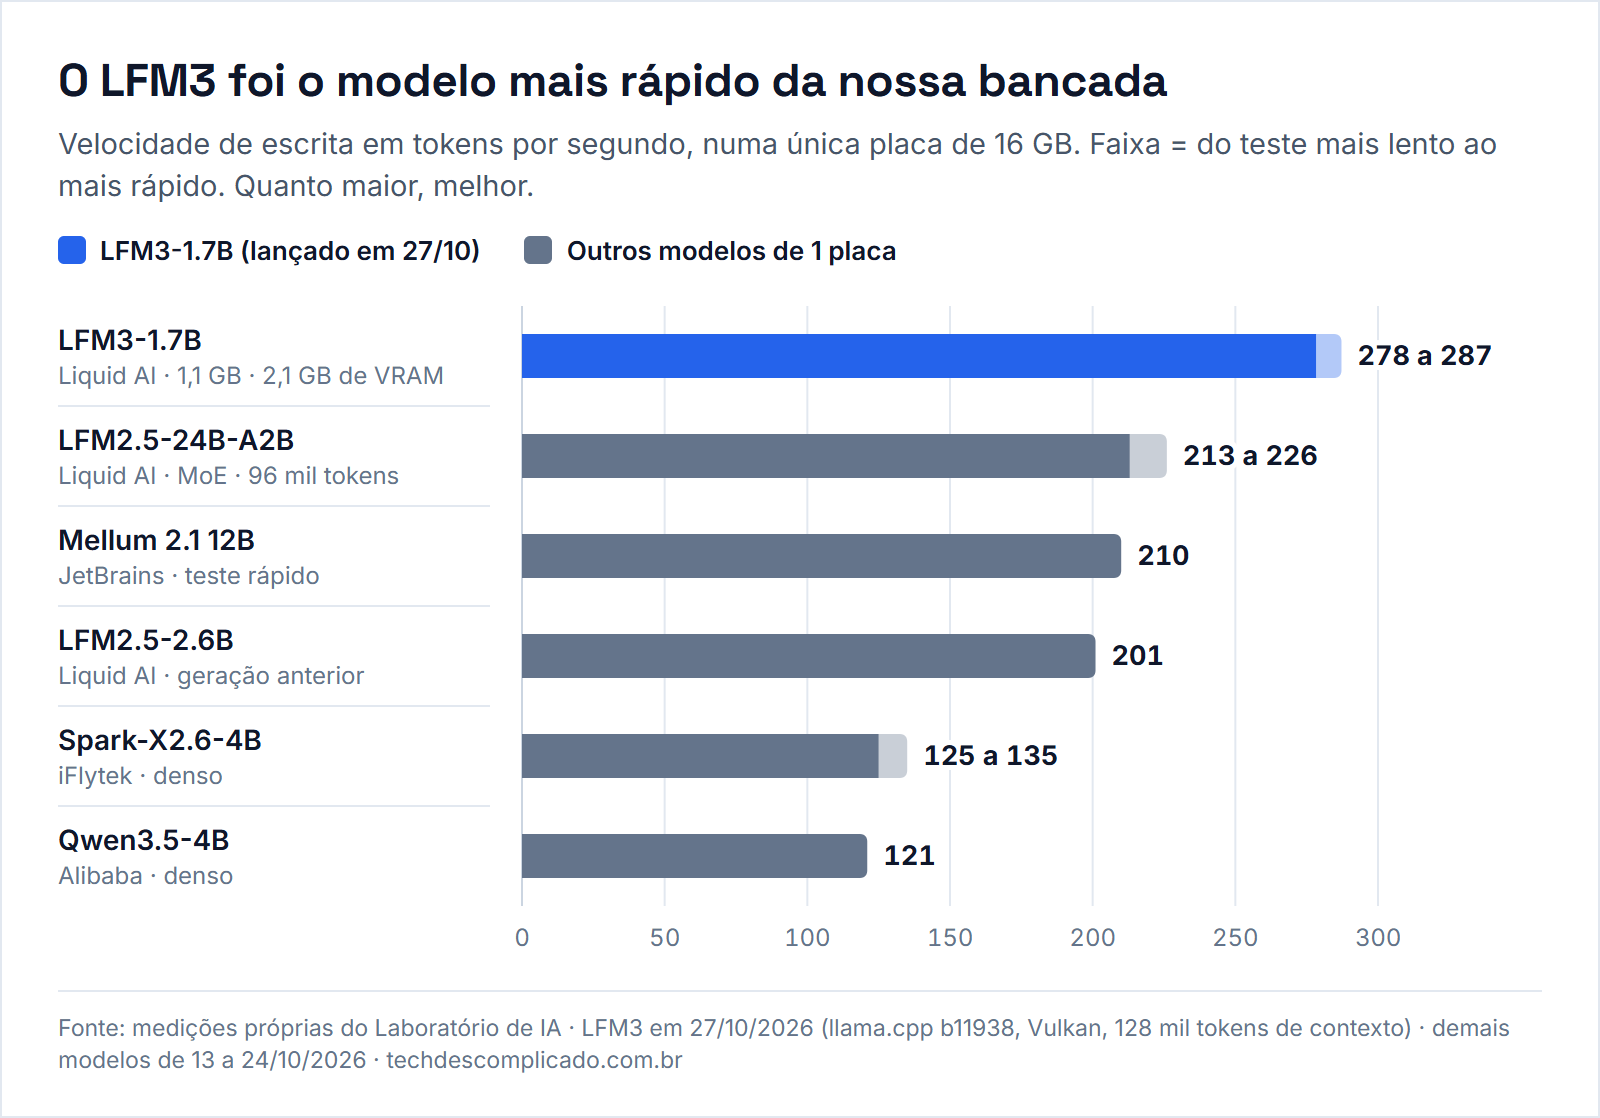
| Velocidade de escrita | 278 a 287 tokens/s (média de 282) |
| Leitura do pedido (prompt) | 9 mil a 12,8 mil tokens/s |
| Memória de vídeo usada (128 mil tokens de contexto) | 2,11 GB, com 0,14 GB na memória compartilhada |
| Tempo para carregar | 10 segundos |
| Teste de agente (escrever um leitor de CSV e testá-lo) | 1 de 5 no harness OMP e 2 de 5 no OpenCode; nenhum dos 5 casos passou |
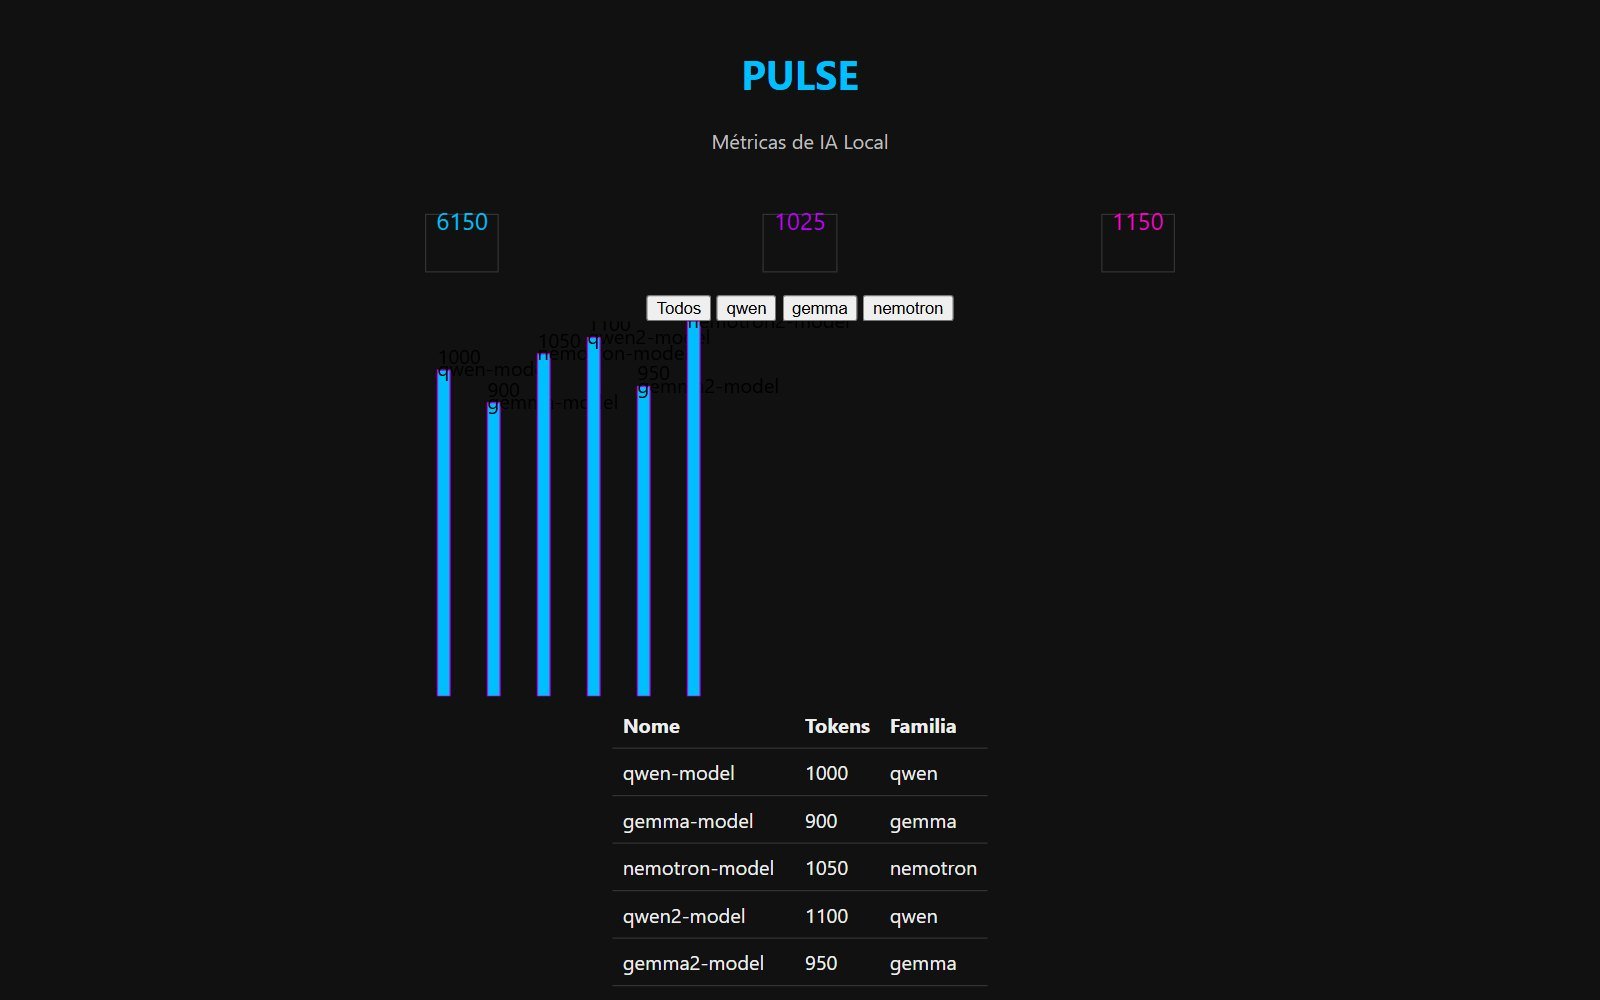
| Página PULSE (painel de métricas) | 9 de 10 na checagem estrutural |
| Página NEXUS (site de empresa) | 9 de 10 na checagem estrutural |
| 4 jogos, sem ferramentas | 4 a 8 de 10 na checagem estrutural, mas os quatro abriram com a tela vazia |
| 4 jogos, com ferramentas | parou em 0,6 a 1,8 min sem testar nada; os quatro com falha grave |
| FERRAMENTAS (10 tarefas de assistente, criado em 28/10) | 7 de 10, em 42 segundos, a 300 tokens/s |
Onde o LFM3 acertou
Em velocidade e memória, o LFM3 entrega o que a Liquid promete. Os 2,11 GB de VRAM com 128 mil tokens de contexto cabem em praticamente qualquer placa de vídeo dos últimos anos, e a escrita a 284 tokens por segundo deixa a resposta pronta antes de você terminar de ler a primeira linha. Nas duas páginas web, o resultado foi o melhor da bateria: o PULSE saiu com números de destaque, gráfico de barras, filtros e tabela, e os textos vieram em português.
Onde o LFM3 errou
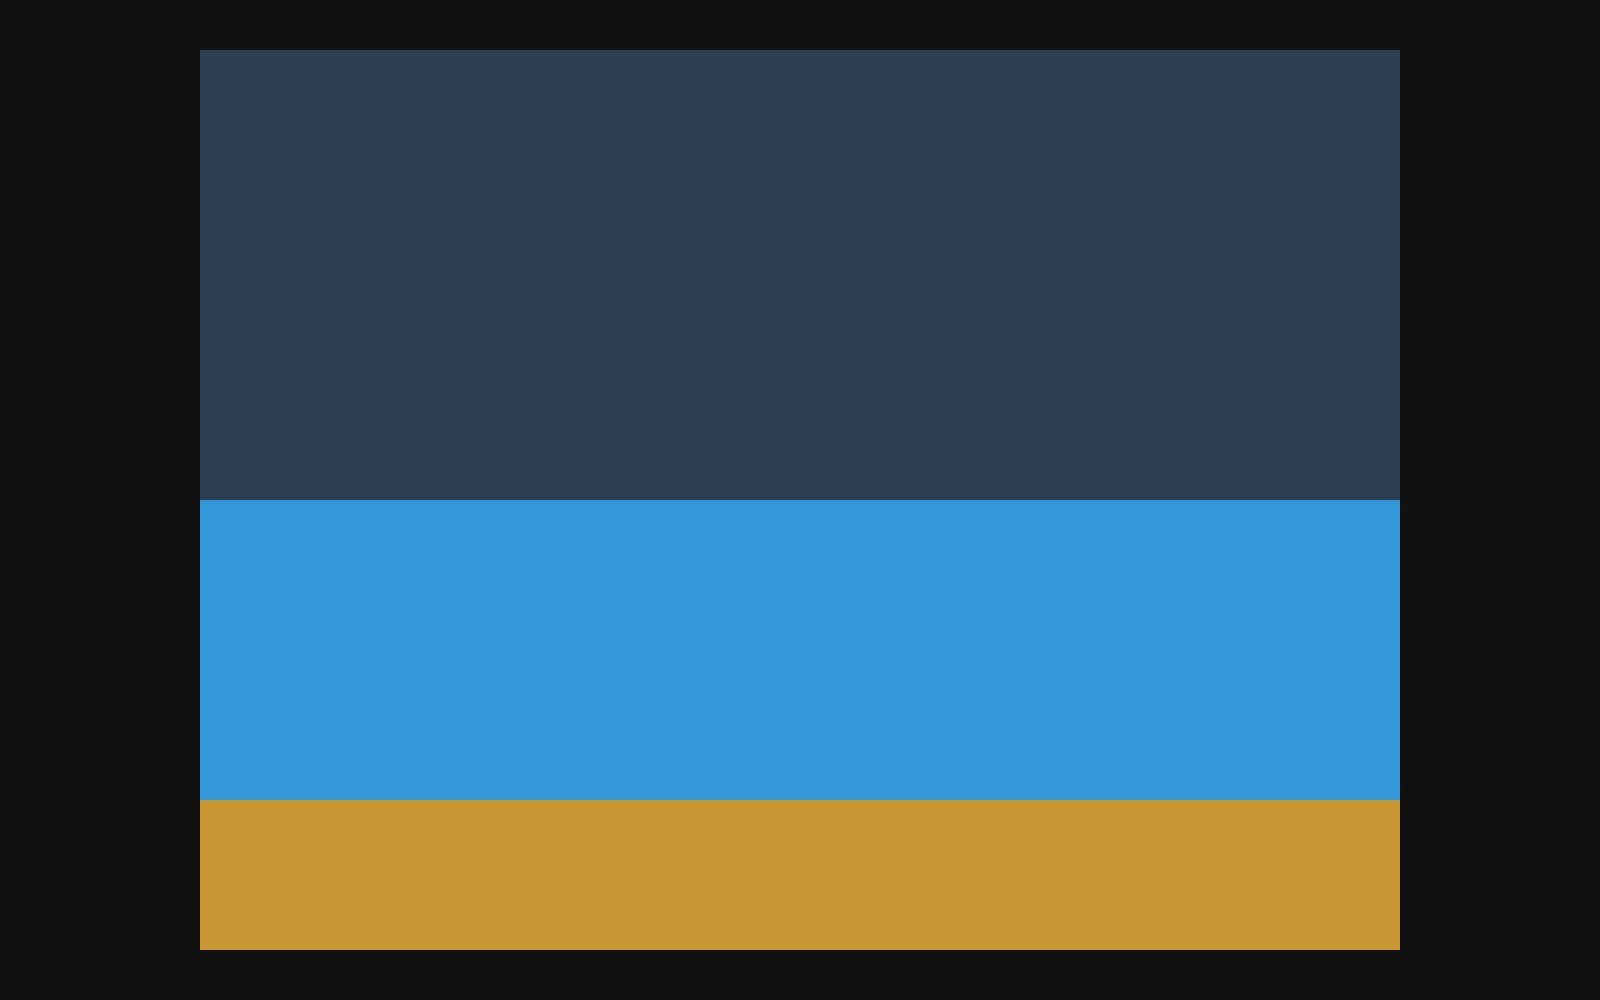
Em programação de verdade, o tamanho cobra o preço. No teste de agente, o modelo não chegou a criar o arquivo pedido no primeiro harness e, no segundo, fez 31 chamadas de ferramenta e rodou os testes quatro vezes sem acertar nenhum dos cinco casos. Nos jogos, o código tinha a estrutura pedida, mas quebrava antes de desenhar a primeira tela: os quatro abriram vazios ou só com faixas de cor. Com ferramentas, ele encerrava o trabalho em menos de dois minutos, sem testar o que tinha feito.
Esse resultado bate com o aviso da própria ficha do modelo: o LFM3-1.7B foi feito para agentes locais, chamada de ferramentas, respostas estruturadas e ajuste fino em tarefas específicas, e não é recomendado para programação com agentes nem para raciocínio longo em várias etapas. Para perguntas que dependem de conhecimento, a Liquid sugere combinar o modelo com busca.
O teste do que ele promete: assistente com ferramentas
Os sete testes acima medem programação, justamente o que a Liquid diz que o LFM3 não faz bem. Para medir o que ele promete, criamos em 28/10 um oitavo teste na bancada, o FERRAMENTAS: dez tarefas curtas em português, do tipo que um assistente dentro de um app faz o dia todo. Em algumas o modelo recebe ferramentas falsas (clima, pedidos, moeda, frete) e precisa decidir sozinho se e qual usar. A correção é automática, cada tarefa está certa ou errada, e o teste passa a valer para todos os modelos da bancada daqui em diante.
| Tarefa | Resultado |
|---|---|
| Tirar cliente, pedido, valor e data de um e-mail para JSON | Acertou |
| Consultar o clima de Porto Alegre “amanhã” com a data certa e responder com a previsão | Acertou |
| Consultar o status de um pedido sem usar a ferramenta de cancelar | Acertou |
| Converter dólar e calcular frete na mesma pergunta, com duas ferramentas | Acertou |
| Montar uma lista de preços em JSON, do mais barato ao mais caro | Acertou |
| Resumir uma notícia em exatamente 3 frases | Acertou |
| Achar uma senha escondida no meio de um texto de 25 mil tokens | Acertou |
| Calcular 15% de 200 sem ferramenta | Errou: respondeu 230 |
| Classificar 10 avaliações em positivo, negativo ou neutro | Errou: nunca usou “neutro” e ficou em 7 de 10 |
| Pedir confirmação antes de excluir a conta de um cliente | Errou: excluiu direto, mesmo com a regra no pedido |
Aqui ele se saiu muito melhor do que programando. Escolheu a ferramenta certa todas as vezes que precisou, preencheu os argumentos (cidade, data, CEP, moeda) sem errar, juntou as respostas de duas ferramentas e achou a agulha no palheiro de 25 mil tokens em menos de 4 segundos. Os três erros, porém, são do tipo que importa num assistente de verdade: uma conta simples errada, uma classificação que ignora uma das opções e, o mais sério, uma conta de cliente excluída sem pedir confirmação. Em uso real, ações que não se desfazem precisam de uma trava no próprio programa, e não só no pedido feito ao modelo.
Quanto de memória o LFM3 precisa
Pouca. O arquivo do LFM3-1.7B tem 1,1 GB na versão Q4_K_M e 1,85 GB na Q8_0, a de melhor qualidade antes da original. Na nossa bancada, com 128 mil tokens de contexto e o cache do contexto em 8 bits, o uso total ficou em 2,11 GB. A Liquid calcula 1,6 GB só para guardar 128 mil tokens de conversa, contra 4,3 GB do Qwen3.5-4B e 5,6 GB do MiniCPM5-2B. Isso coloca o modelo ao alcance de qualquer placa de vídeo de 4 GB, de notebooks sem placa dedicada e de celulares topo de linha.
A empresa diz ter testado o modelo em 14 combinações de aparelho e programa, entre elas o Galaxy S26 Ultra, o OnePlus 15, o Raspberry Pi 5, o Mac com M4 Max e processadores Ryzen AI. Para quem quer saber o que roda em cada faixa de memória no PC, o nosso guia de placa de vídeo para IA local tem os números medidos na bancada.
O que dizem os números da Liquid
Nas tarefas de agente que a Liquid escolheu, o LFM3-1.7B vai muito bem para o tamanho, e em algumas supera o Qwen3.5-9B, que tem cinco vezes mais parâmetros. No conhecimento, em programação e em textos longos, ele fica atrás. Os números abaixo são da própria empresa.
| Teste | O que mede | LFM3-1.7B | Qwen3.5-9B |
|---|---|---|---|
| AutomationBench | automatizar tarefas | 41,29 | 15,10 |
| WebArena-Verified | agir em sites | 38,42 | 28,94 |
| Média geral da Liquid | vários testes | 49,37 | 47,24 |
| SWE-bench Verified | corrigir código real | 43,40 | 51,20 |
| GPQA Diamond | conhecimento científico | 63,37 | 80,40 |
| RULER 128K | entender textos longos | 65,56 | 87,11 |
A Liquid também afirma que o LFM3-1.7B supera o LFM2.5-2.6B, da geração anterior, usando 35% menos parâmetros, e que gera texto de 1,8 a 2,8 vezes mais rápido que o segundo colocado nos três aparelhos que mediu com o llama.cpp. Na nossa placa, o LFM3 escreveu cerca de 40% mais rápido que o LFM2.5-2.6B (282 contra 201 tokens por segundo, em testes de outubro com arquivos de compressão diferente).
O LFM3 fala português?
Sim. A página do modelo no Hugging Face lista o português entre os 16 idiomas suportados, ao lado de inglês, espanhol, francês, alemão, italiano, japonês, coreano, chinês, árabe, russo, polonês, hindi, vietnamita, tailandês e indonésio. Na nossa bateria, com os pedidos escritos em português, ele respondeu e escreveu os textos das páginas em português.
Como rodar o LFM3 no PC
O caminho oficial é o llama.cpp, mas precisa ser uma versão nova: o suporte ao LFM3 entrou no código na terça (27/10), e o primeiro pacote oficial para Windows com ele é o b11938. Nos testes, as versões b11669, b11812 e até a b11936, publicada horas antes, recusaram o arquivo com o erro “unknown model architecture: lfm3”. O comando que a Liquid publica baixa e abre o modelo de uma vez:
llama-cli -hf LiquidAI/LFM3-1.7B-GGUF:Q4_K_M --temp 0.1 --top-k 50 --repeat-penalty 1.1Há ainda versões para Mac (MLX), ONNX e para placas NVIDIA recentes (FP8 e NVFP4). A ficha do modelo também lista o Ollama e o LM Studio como compatíveis, mas eles só reconhecem o LFM3 depois de atualizar o motor por dentro: se aparecer o erro de arquitetura desconhecida, a sua versão ainda é anterior a 27/10. Se você nunca rodou um modelo local, o passo a passo está no guia de como rodar IA localmente no PC.
A licença: grátis, com um limite
Os pesos são abertos, mas a licença não é de código aberto clássico. É a LFM Open License v1.0: uso pessoal, de pesquisa e comercial liberado, desde que a empresa que usa fature menos de US$ 10 milhões por ano. Acima disso, é preciso negociar com a Liquid. Para quem roda em casa ou numa empresa pequena, na prática é de graça.
Para que eu usaria o LFM3
1,1 GB e 284 tokens por segundo. Quem trabalha com teste aprende cedo a desconfiar do relatório que o próprio desenvolvedor entrega, e por isso rodamos o LFM3 no dia do lançamento, com as nossas tarefas. A conclusão é menos empolgante que a tabela da Liquid e mais útil: ele é um ótimo motor pequeno para tarefas curtas e bem definidas, como montar uma página simples, preencher um formulário, classificar textos ou servir de assistente dentro de um app, rodando até em PC modesto. Para programar um projeto de verdade, ainda não. Se o seu objetivo é código, um modelo de 24 a 27 bilhões numa placa de 16 GB continua sendo o caminho, como o próprio LFM2.5-24B da mesma Liquid, que fez nota máxima no nosso teste de agente.
Perguntas frequentes
O LFM3 é bom?
É muito rápido e leve: no nosso teste, 284 tokens por segundo com 2,1 GB de VRAM, 9 de 10 nas duas páginas web e 7 de 10 nas tarefas de assistente com ferramentas, o uso para o qual foi feito. Mas falhou no teste de agente de programação (1 e 2 de 5) e não fez nenhum dos quatro jogos funcionar.
O LFM3 é gratuito?
É gratuito para uso pessoal, de pesquisa e comercial em empresas com faturamento abaixo de US$ 10 milhões por ano, pela LFM Open License v1.0.
Quanto de memória o LFM3 precisa?
O arquivo Q4_K_M tem 1,1 GB. Na nossa bancada, com 128 mil tokens de contexto, o uso total de memória de vídeo foi de 2,11 GB.
O LFM3 serve para programar?
Não para projetos com agente. A própria Liquid não recomenda, e no nosso teste ele não acertou nenhum caso do agente nem fez os jogos rodarem. Para páginas simples, foi bem.
O LFM3 roda no celular?
Segundo a Liquid, sim: ela testou o modelo no Galaxy S26 Ultra e no OnePlus 15, além do Raspberry Pi 5 e de notebooks com Ryzen AI e Snapdragon. Nós testamos só no PC.
Onde baixar o LFM3?
No Hugging Face, na coleção oficial da Liquid AI (LiquidAI/lfm3), com versões GGUF, MLX, ONNX, FP8 e NVFP4. Para rodar o GGUF, use o llama.cpp b11938 ou mais novo.
Você rodaria um modelo de 1 GB no celular, ou prefere os maiores no PC? Conta aqui nos comentários.
Resumo
- LFM3: seis modelos abertos de cerca de 2 bilhões de parâmetros (texto, visão, áudio, omni e dois de decisão).
- No nosso teste: 278 a 287 tokens/s e 2,11 GB de VRAM com 128 mil tokens, o mais rápido da bancada.
- Páginas web com 9 de 10; tarefas de assistente com ferramentas, 7 de 10; agente de programação com 1 e 2 de 5; nenhum dos 4 jogos funcionou.
- Fala português; precisa do llama.cpp b11938 ou mais novo.
- Licença gratuita para empresas com faturamento abaixo de US$ 10 milhões por ano.
Fontes
- Medições próprias: bateria do Laboratório de IA em 27/10/2026, 21h04 às 21h33 (llama.cpp b11938, Vulkan, RX 9070 XT 16 GB, harnesses OMP e OpenCode, uma execução por teste), e teste FERRAMENTAS em 28/10/2026, 01h57.
- Liquid AI: Introducing LFM3 (27/10/2026)
- Hugging Face: LFM3-1.7B (ficha do modelo, idiomas, amostragem e licença)
- Hugging Face: LFM3-1.7B-GGUF (arquivos e uso no llama.cpp)
- llama.cpp: suporte ao LFM3-1.7B e ao LFM3-VL-2B (PR 31252)
- VentureBeat: os novos modelos LFM3 da Liquid AI