Assinatura de IA, limite de uso e cobrança por token pesam no bolso de quem usa inteligência artificial todo dia. A alternativa é rodar o modelo no seu próprio computador, sem pagar por uso. O problema, até pouco tempo, era o tamanho: os modelos realmente capazes são enormes e pedem servidores.
Foi esse limite que o Strata mexeu. Ele é um programa gratuito e de código aberto que faz o Qwen3.8-Flash-Next, um modelo de 125 bilhões de parâmetros, funcionar num PC de casa, com uma placa de vídeo só. Testamos no nosso Laboratório de IA, com o mesmo modelo em três versões, e a diferença de velocidade foi grande: de 19 para 63 tokens por segundo no mesmo computador, e com uma placa a menos.
Neste texto você vê o que testamos, os números, o que cada versão criou (com capturas de tela), o que você precisa ter para rodar e para quem vale a pena. Um aviso honesto desde já: a qualidade ainda não está no nível dos modelos pagos em tudo. Mas a distância encolheu muito, e dá para medir.
O que testamos: o Qwen3.8-Flash-Next em três versões
O modelo é o Qwen3.8-Flash-Next 125B-A6B, da equipe Qwen, da Alibaba, uma prévia da arquitetura do Qwen 4 (já falamos dela em Qwen 4 anunciado: o que se sabe da versão 27B para rodar em casa). Ele tem 125 bilhões de parâmetros no total, mas é do tipo MoE, uma “equipe de especialistas”: a cada palavra, só cerca de 6 bilhões trabalham. É isso que torna possível rodá-lo fora de um data center.
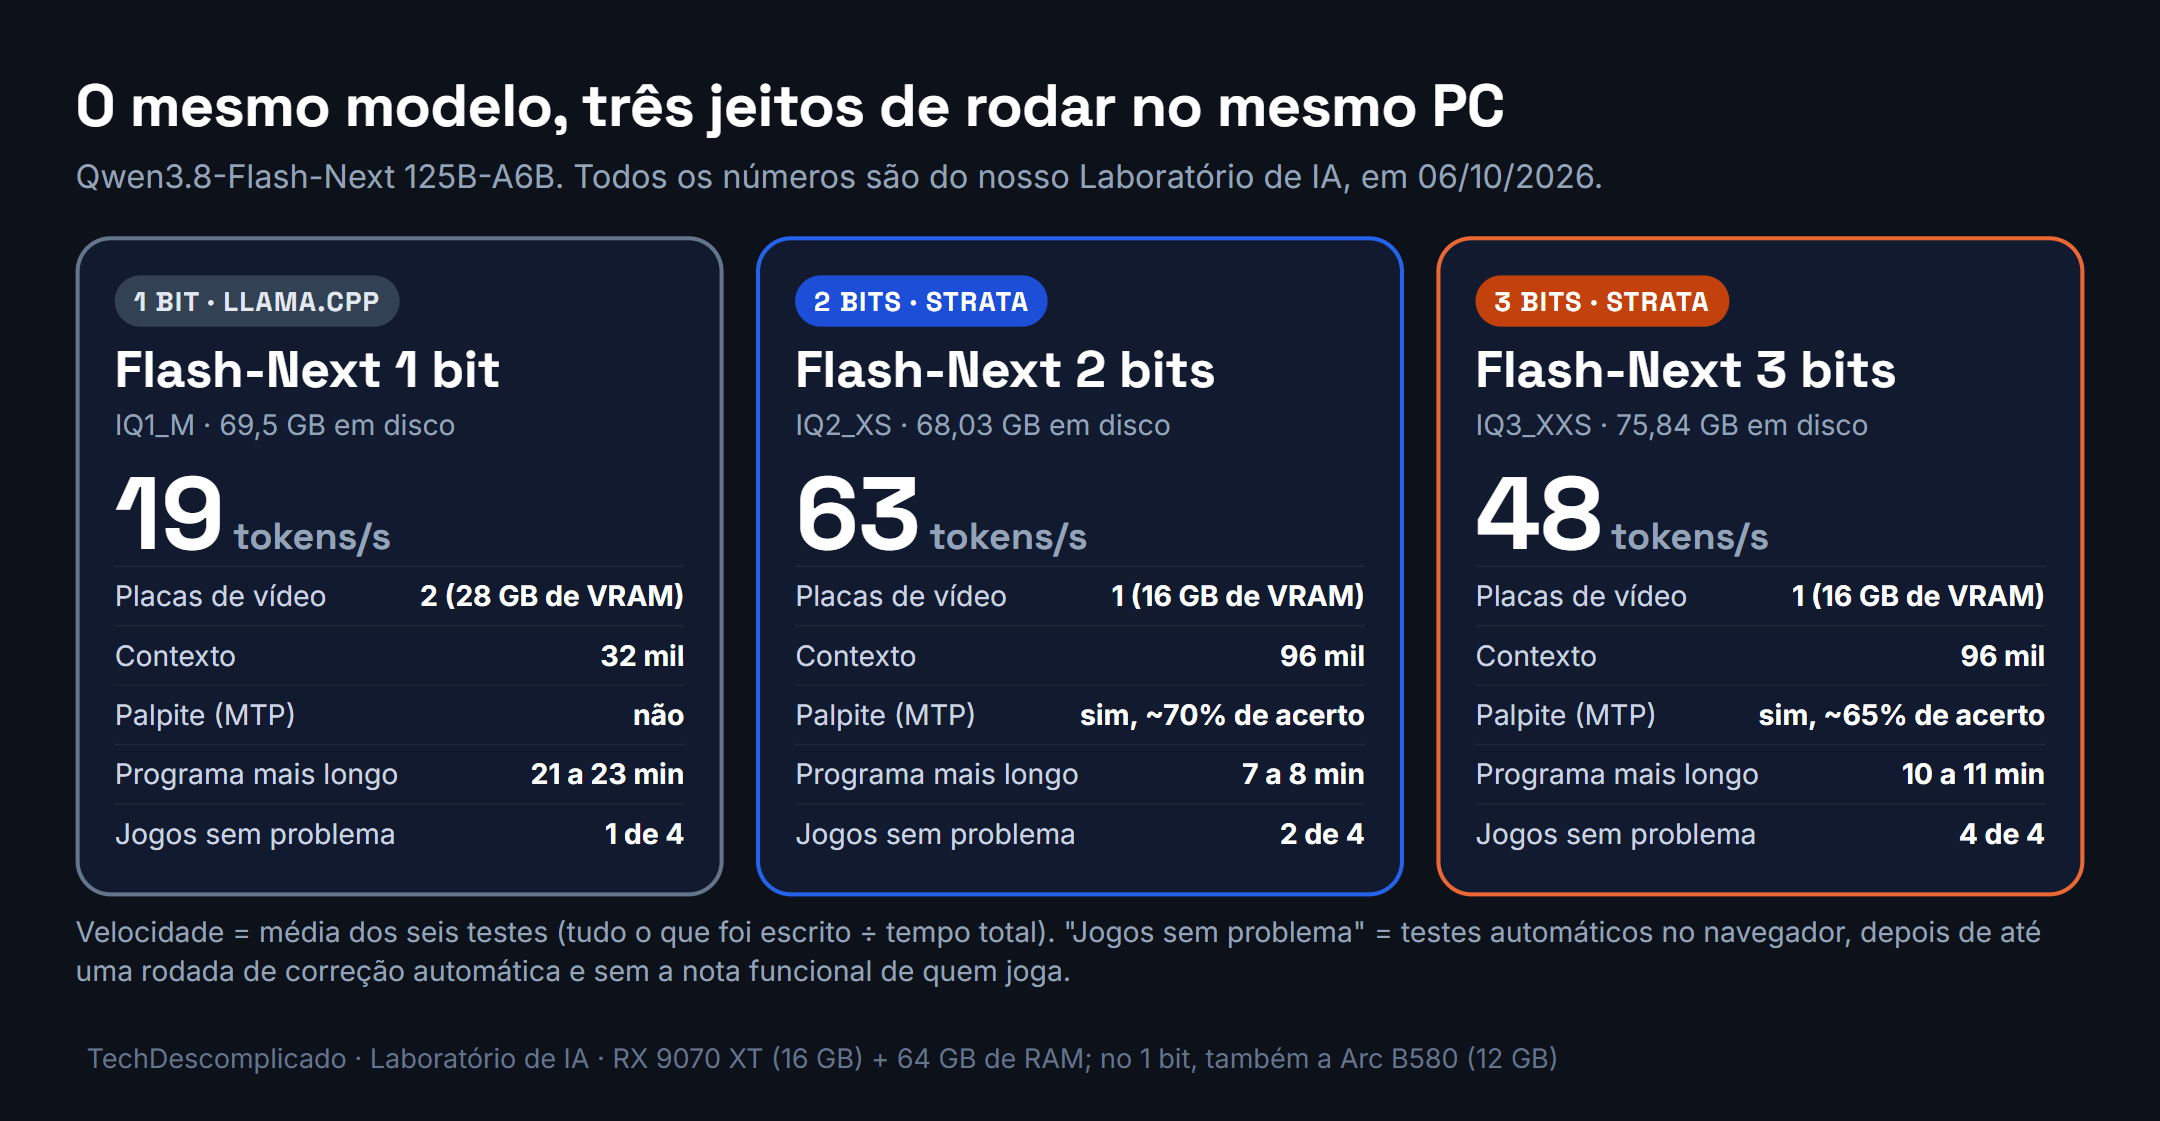
Para caber num PC, o modelo precisa ser comprimido, e quanto mais bits sobram para cada número, mais fiel ele fica ao original (e mais pesado). Comparamos três versões, no mesmo PC (RX 9070 XT de 16 GB e 64 GB de RAM; no 1 bit, também a Arc B580 de 12 GB):
| Versão | Programa | Tamanho em disco | Placas | Contexto | Palpite (MTP) |
|---|---|---|---|---|---|
| 1 bit (IQ1_M) | llama.cpp | 69,5 GB | 2 | 32 mil | não |
| 2 bits (IQ2_XS) | Strata | 68,03 GB | 1 | 96 mil | sim |
| 3 bits (IQ3_XXS) | Strata | 75,84 GB | 1 | 96 mil | sim |
O pedido foi igual para todas: seis programas completos escritos do zero, quatro jogos para navegador (VOO LIVRE, BOMBA LAB, HEXÁGONO e CORREDOR 3D) e duas páginas (PULSE, um painel de métricas, e NEXUS TECH, o site de uma loja). Cada jogo roda numa conversa nova, com a janela de contexto inteira só para ele, e tem direito a uma rodada de correção automática se o teste no navegador achar problema: o modelo recebe o pedido, o jogo que ele mesmo escreveu e a lista de erros, e escreve a versão corrigida.
Como o Strata faz um modelo desse tamanho caber
Os modelos gigantes costumam exigir centenas de gigabytes na memória da placa de vídeo. O Strata muda o jogo ao repartir o trabalho pelo PC inteiro: a placa de vídeo fica com as camadas principais e os especialistas mais usados, a memória RAM guarda todos os especialistas, e uma tabela de consulta de 29 GB fica no SSD. O modelo de 125 bilhões tem 24.576 especialistas, e cada palavra usa só 10 deles.
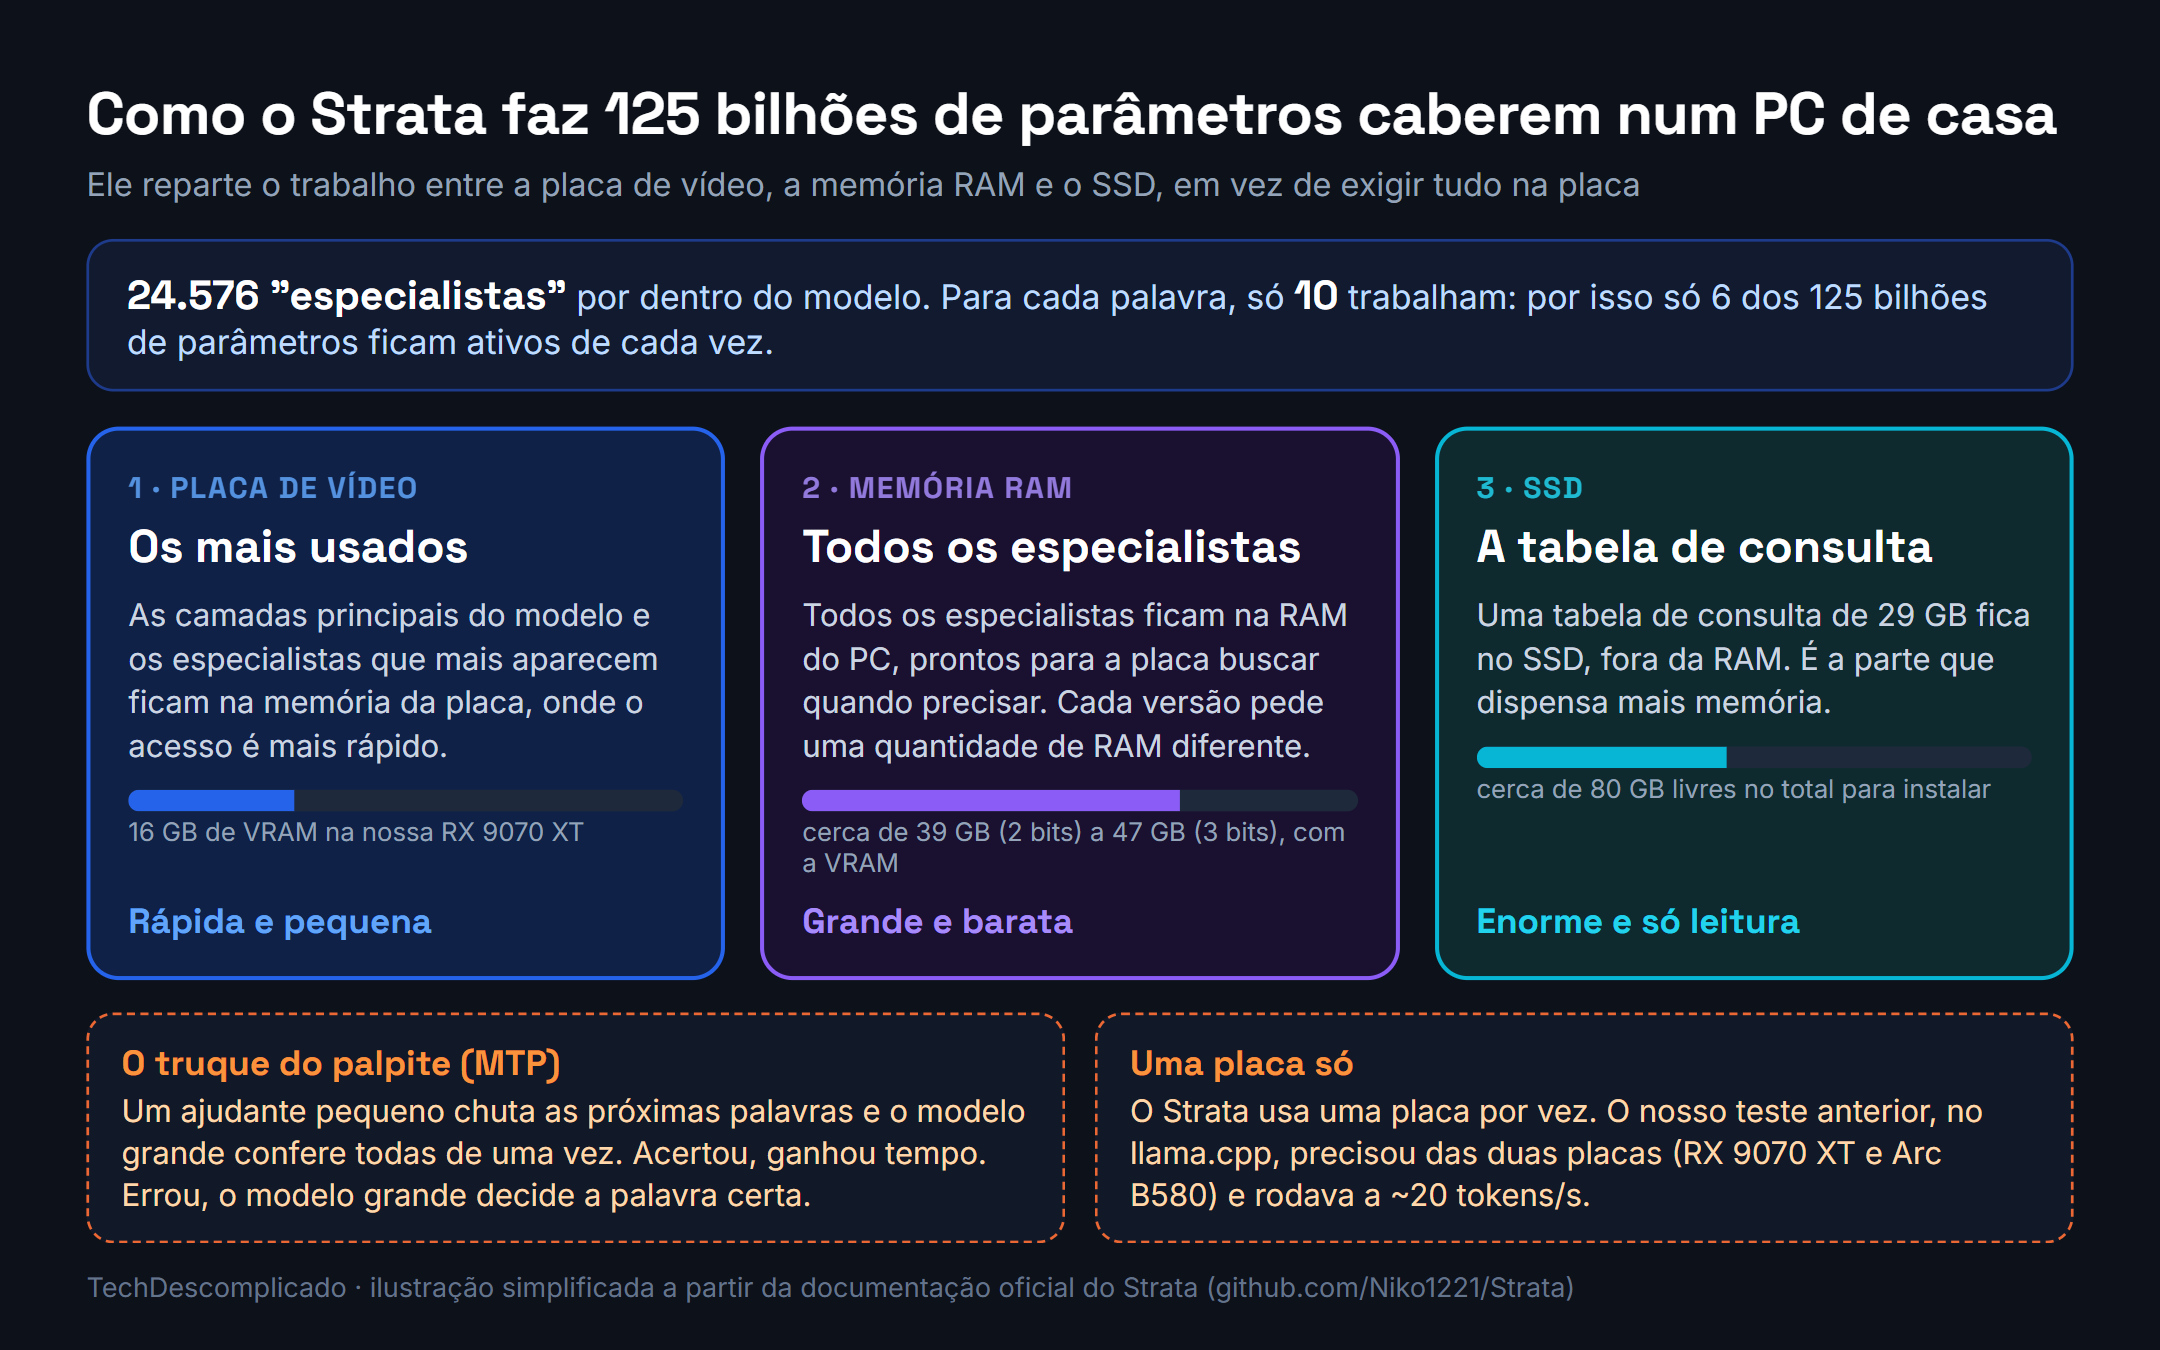
Há ainda o palpite (MTP): um ajudante pequeno chuta as próximas palavras e o modelo grande confere todas de uma vez. Quando o palpite acerta, saem várias palavras no tempo de uma. Nos nossos testes o palpite acertou cerca de 70% no 2 bits e 65% no 3 bits, e o modelo grande decide cada palavra: segundo o projeto, o palpite só ganha tempo e a qualidade da resposta é a mesma.
O Strata é de código aberto (licença MIT) e feito por outra pessoa, não por nós. Está no GitHub do projeto. E já vale responder a dúvida que muita gente tem: ele não é uma solução geral para qualquer modelo. A documentação do projeto só lista o Qwen3.8-Flash-Next e as variantes dele (Coder, Swift 1.5 e as versões da Unsloth). Modelos de outras empresas, como Llama ou Gemma, não aparecem como suportados. Para esses, o caminho continua sendo o llama.cpp.
Velocidade: de 19 para 63 tokens por segundo
Um token é um pedaço de palavra, mais ou menos três quartos de uma palavra. Medimos quantos o modelo escreve por segundo, contando tudo (o raciocínio e a resposta) e dividindo pelo tempo total. O 1 bit no llama.cpp ficou em 18 a 20 tokens por segundo. No Strata, o 2 bits ficou entre 59 e 68 (média de 63, cerca de 3,3 vezes mais rápido) e o 3 bits entre 47 e 51 (média de 48, cerca de 2,6 vezes), com uma placa só.
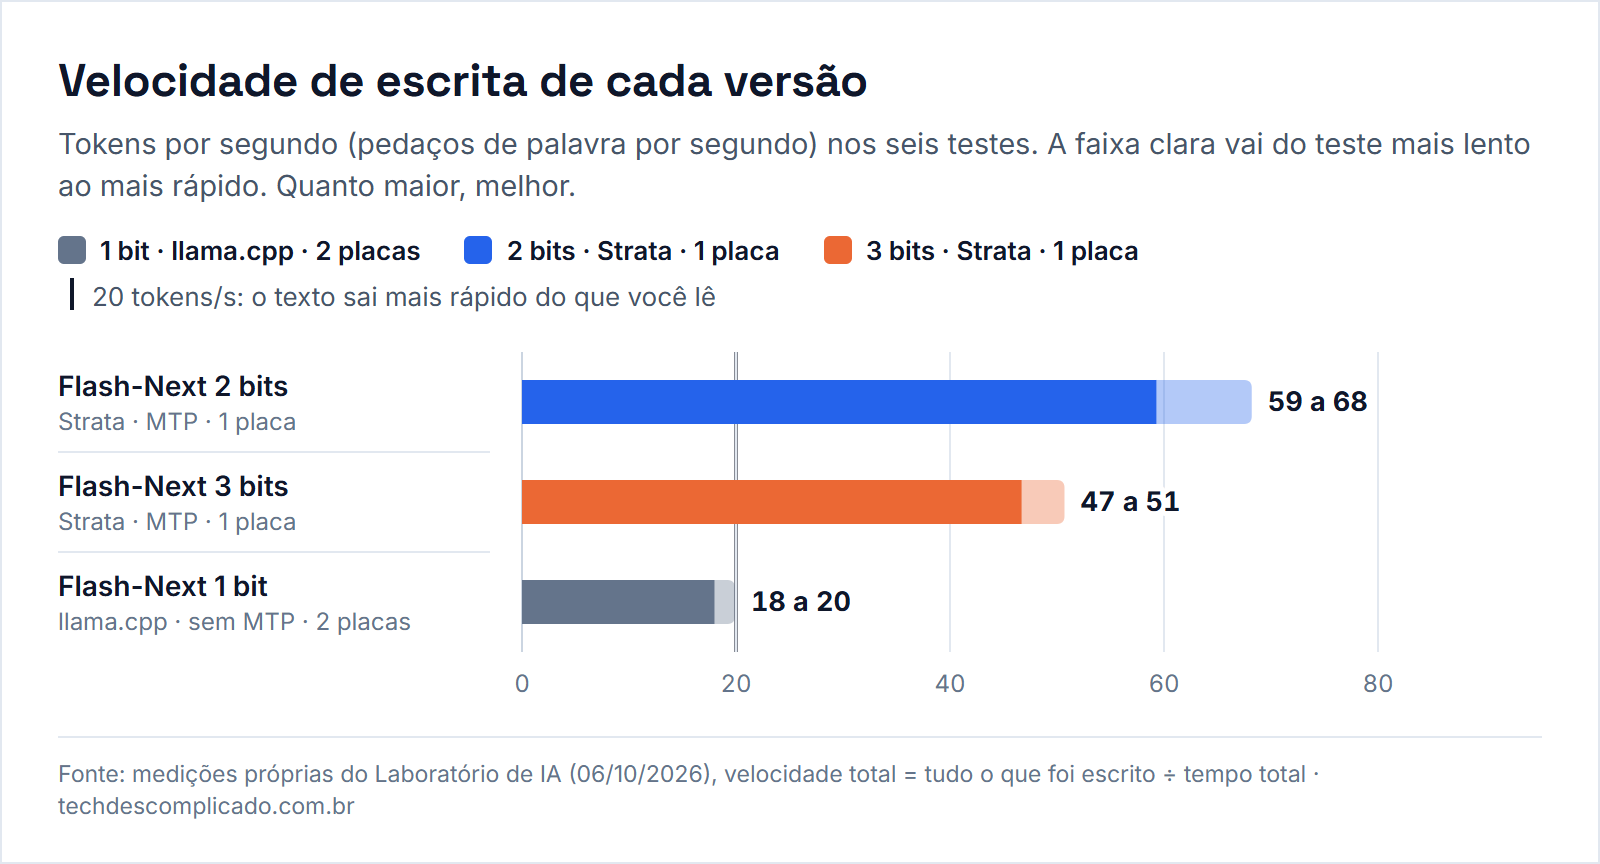
O projeto publica números parecidos: 79 e 62 tokens por segundo para o 2 e o 3 bits numa RTX 5070 de 12 GB, segundo a documentação dos modelos. O nosso PC é outro, o teste é de código longo e rodamos no Windows com placa AMD, então é natural que os valores sejam um pouco menores.
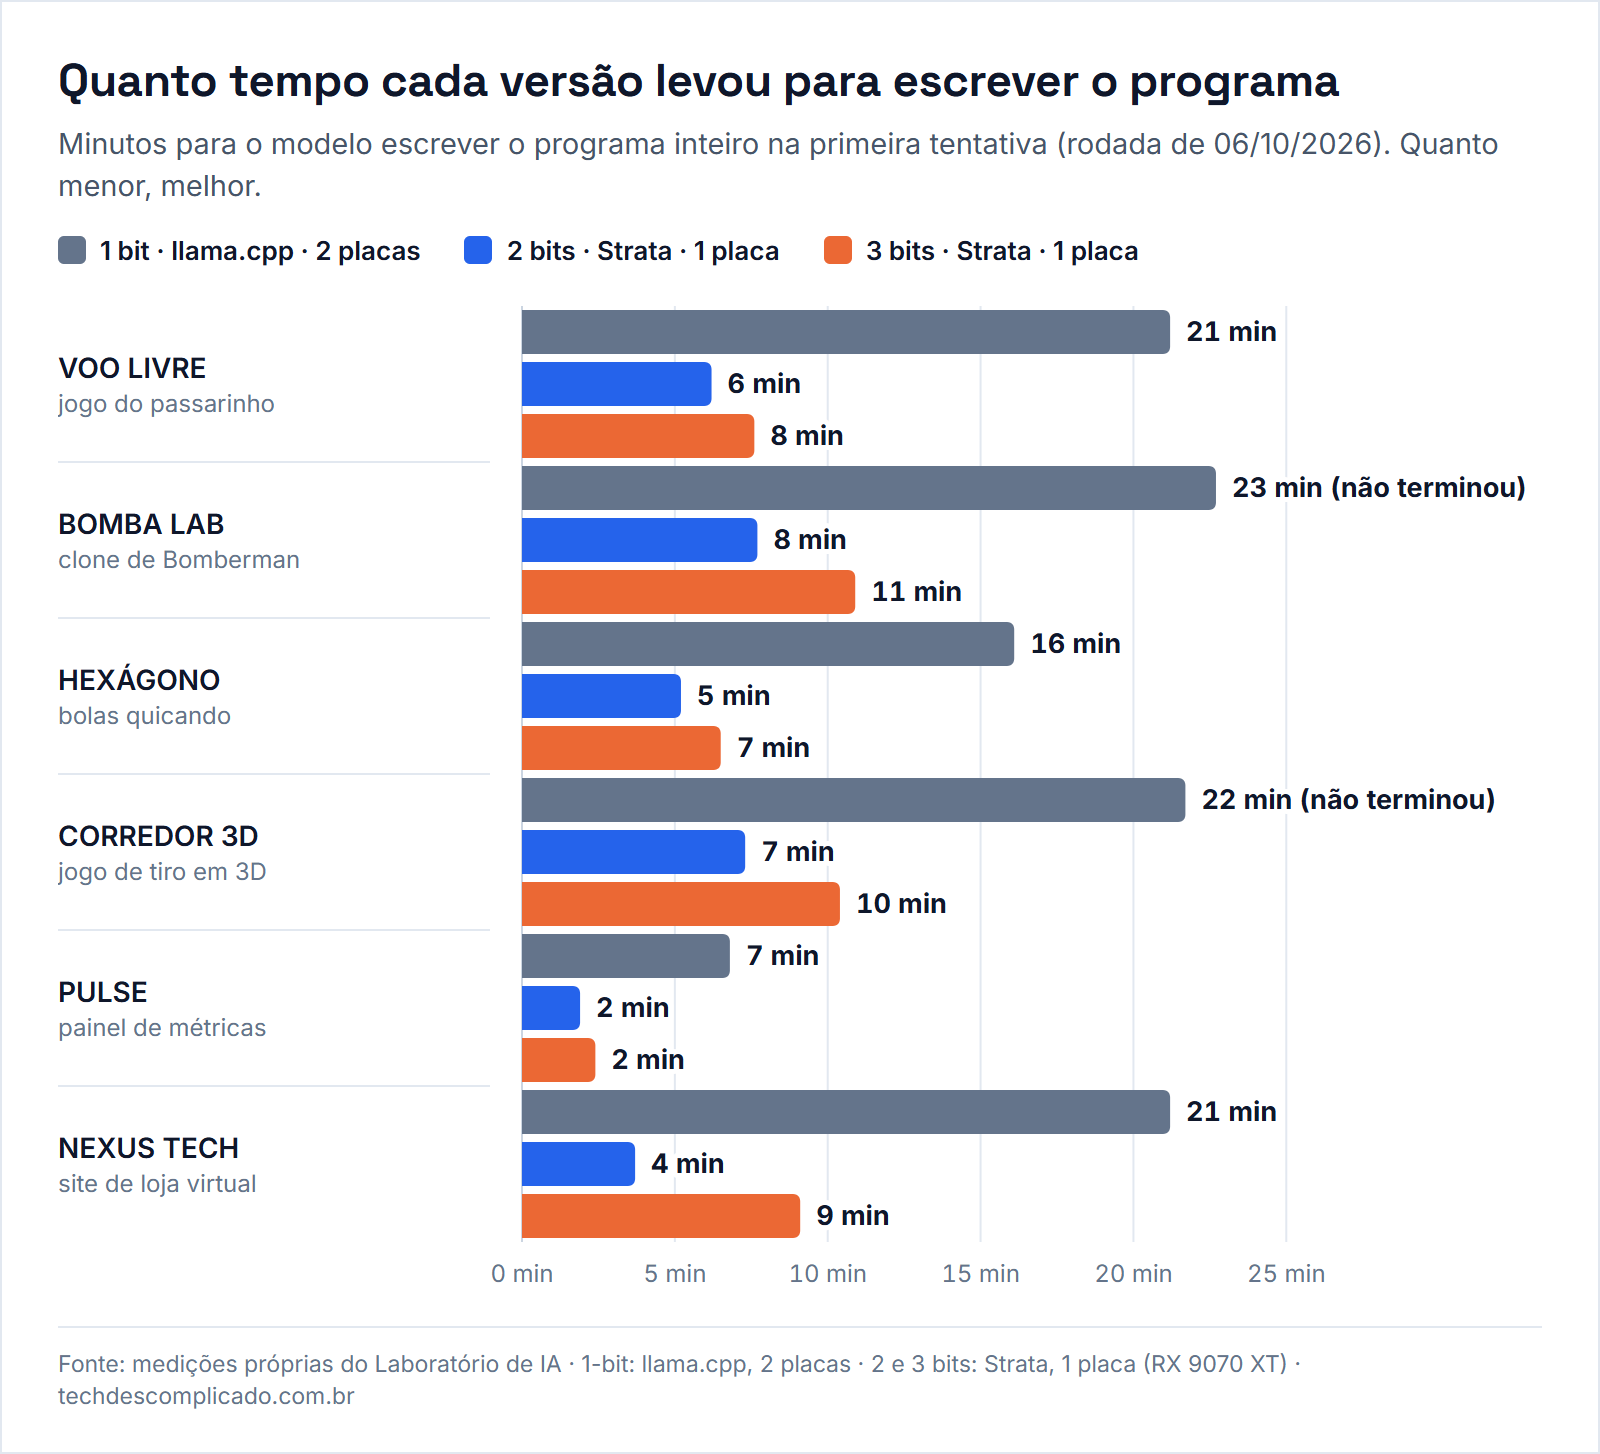
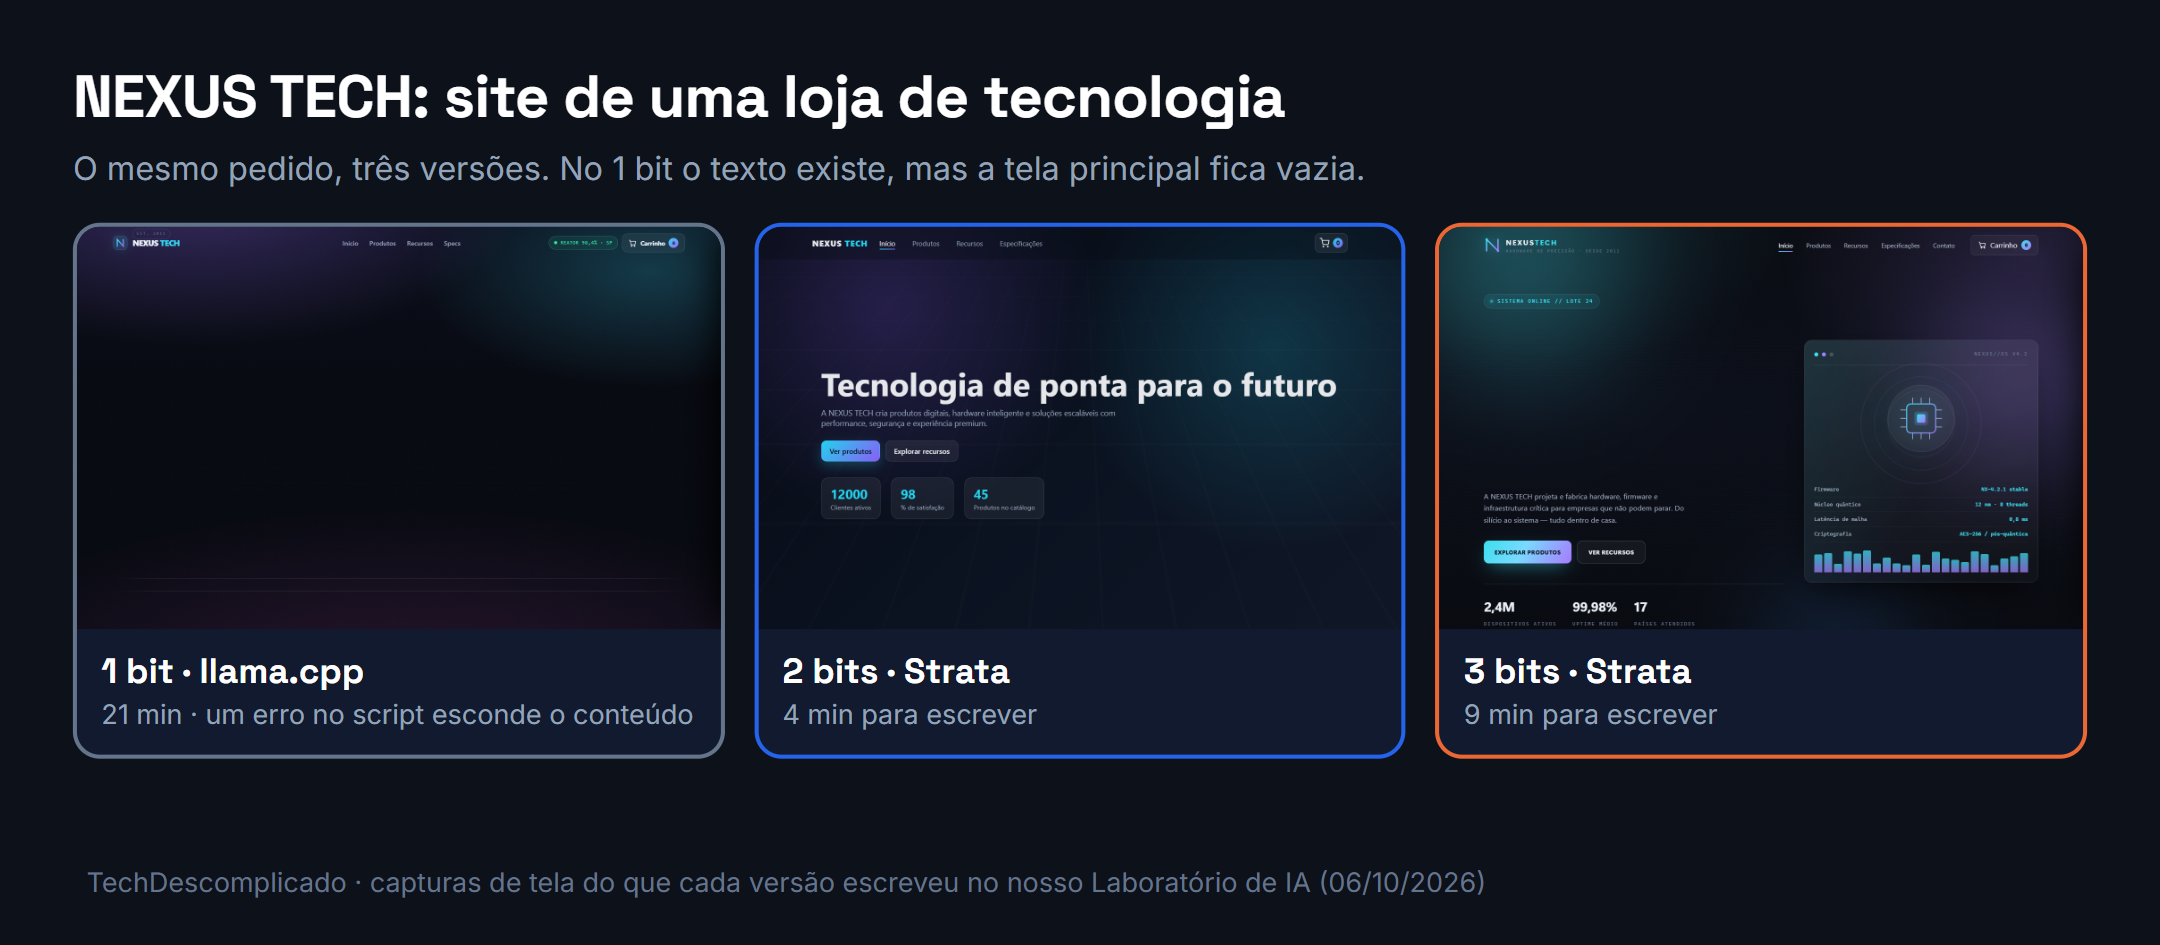
Na prática, a diferença é o tempo de espera. O HEXÁGONO levou 16 minutos para ser escrito no 1 bit, 5 no 2 bits e 7 no 3 bits. O site NEXUS TECH, 21 minutos, 4 e 9. Dois jogos nem chegaram ao fim no 1 bit: o modelo bateu no limite de texto antes de terminar.
E a qualidade? Quanto mais bits, mais jogos limpos
Aqui está o ponto em que um número só engana, então vamos por partes. Depois de escrito, cada jogo passa por um teste automático no navegador (abre, aperta Enter, move, verifica se funciona). O resultado, já contando a rodada de correção:
| Jogo | 1 bit · llama.cpp | 2 bits · Strata | 3 bits · Strata |
|---|---|---|---|
| VOO LIVRE | abre em branco | abre em branco | sem problemas (após 1 ajuste) |
| BOMBA LAB | não terminou de escrever | sem problemas (após correção) | sem problemas (após correção) |
| HEXÁGONO | sem problemas | sem problemas | sem problemas (após 1 ajuste) |
| CORREDOR 3D | não terminou de escrever | 5 problemas graves | sem problemas |
| Jogos sem problemas | 1 de 4 | 2 de 4 | 4 de 4 |
Isso é uma triagem automática, não é a nota de quem joga. A nota funcional (se o jogo é divertido e realmente funciona) vai ser dada por nós, jogando, e entra depois no Laboratório. Também vale lembrar que cada teste rodou uma vez por versão, e o resultado de um modelo pode variar de uma rodada para outra. Mesmo assim, o padrão é nítido: o 3 bits fechou os quatro jogos limpos, o 2 bits dois e o 1 bit um.
Para ter uma régua, passamos os mesmos quatro jogos ao Claude Opus 5.5, um modelo pago: os quatro saíram com nota estrutural 10 e só com defeitos leves. Ou seja, o modelo pago ainda faz melhor. A boa notícia é a distância: um modelo gratuito, no seu PC, já entrega jogos completos que abrem e funcionam em boa parte dos testes.
O que cada versão criou
Capturas de tela do que cada versão escreveu, sem retoque. No HEXÁGONO, as três entregaram um jogo que abre e anima:
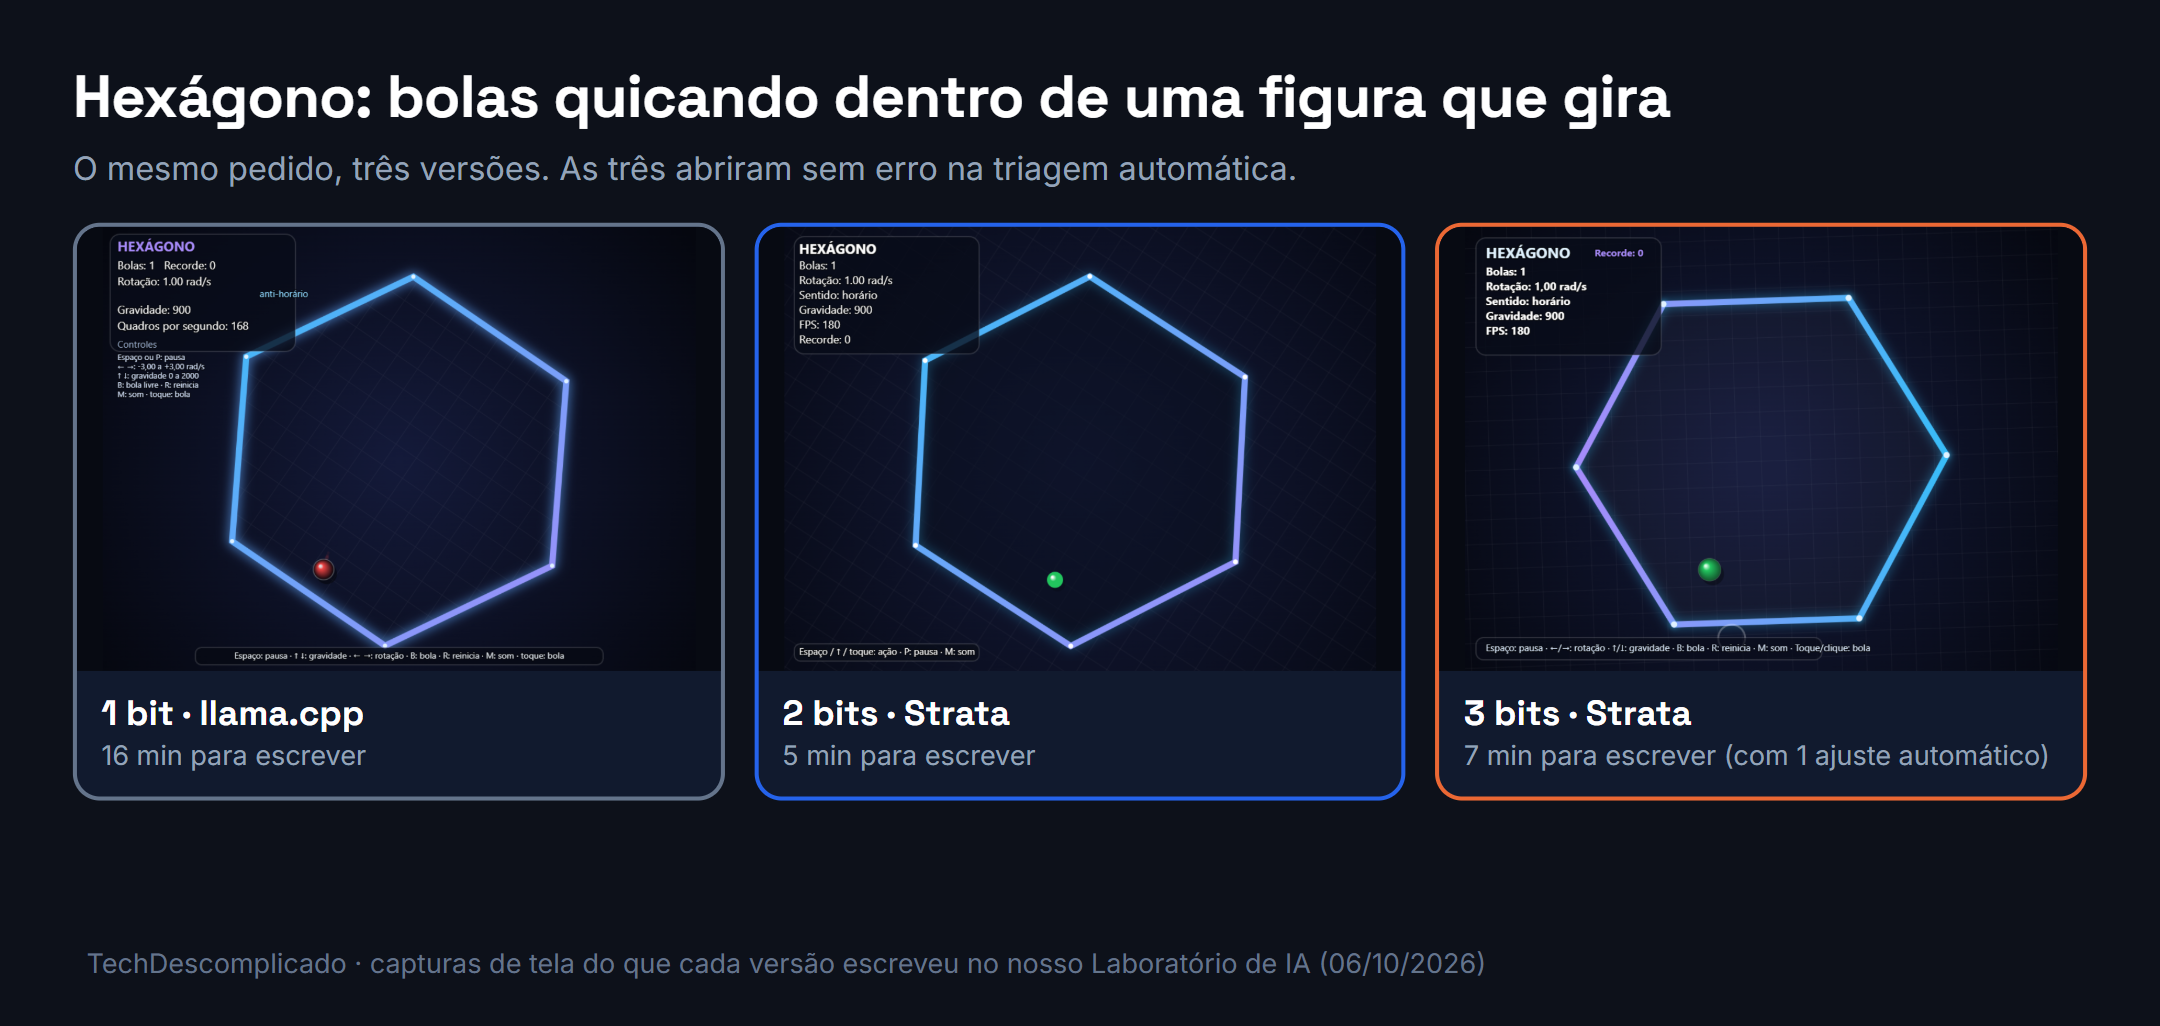
No NEXUS TECH, a diferença aparece. O 1 bit escreveu a página inteira, mas um erro no script ($$ is not defined) impede a animação de entrada, e a área principal fica vazia. O 2 e o 3 bits entregaram páginas completas, cada uma com seu estilo:
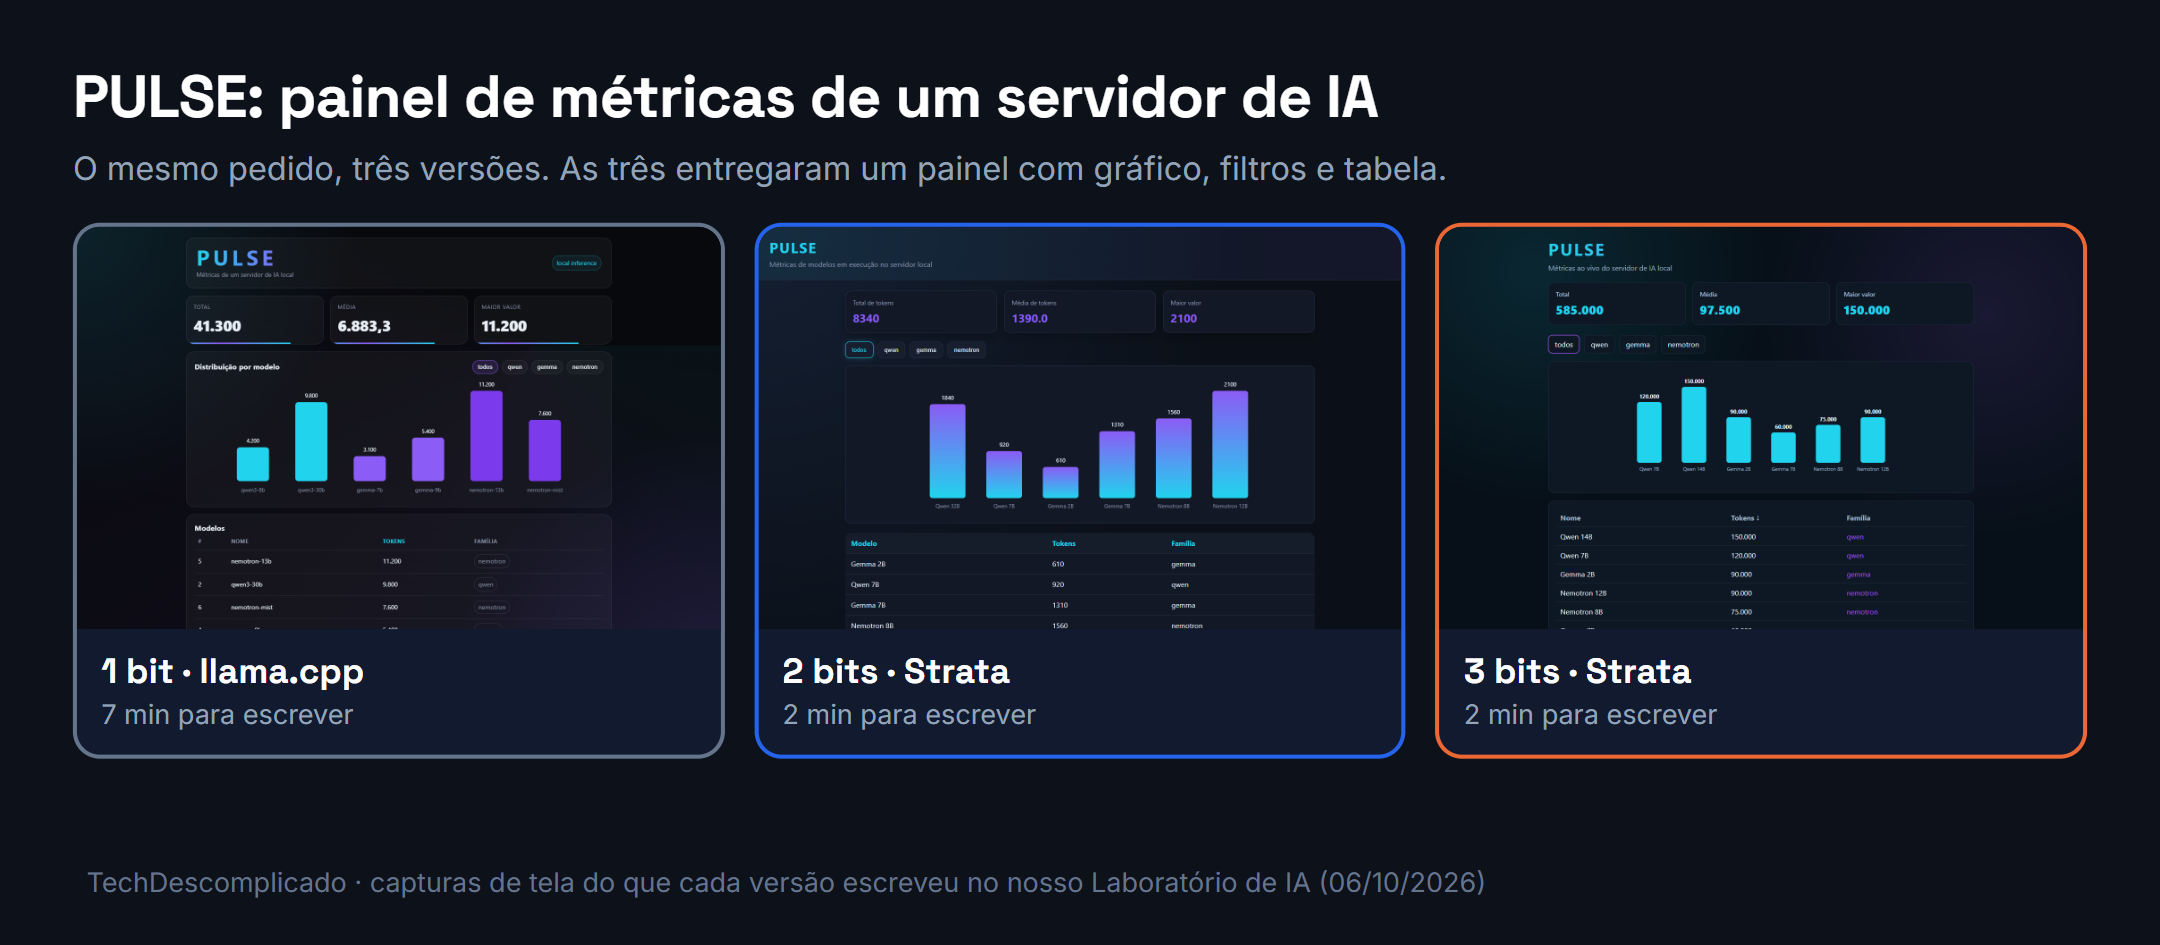
No PULSE, o painel de métricas, as três versões acertaram, com gráfico, filtros e tabela:
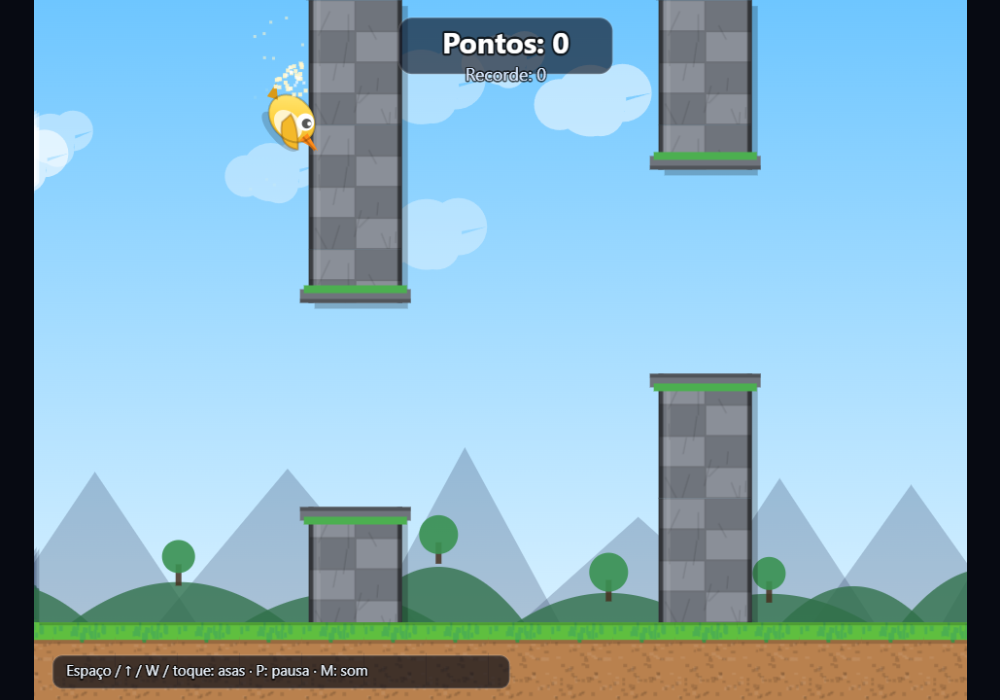
E o VOO LIVRE, o jogo do passarinho, que só o 3 bits entregou funcionando nesta rodada:
Requisitos para rodar o Qwen3.8-Flash-Next no PC e qual versão escolher
Segundo o projeto, o mínimo é uma placa NVIDIA (RTX 20 em diante) ou uma AMD da lista do projeto, com 12 GB de VRAM ou mais, 32 GB de RAM ou mais (com 64 GB, qualquer versão roda) e cerca de 80 GB livres no disco, de preferência em SSD. A placa que usamos, uma RX 9070 XT de 16 GB, custava cerca de R$ 5.159 à vista em 30/09/2026 no nosso levantamento de preços.
- 32 GB de RAM: a versão Coder, boa em programação e mais fraca no resto.
- 48 GB: o 2 bits (IQ2_XS), que é o recomendado pelo projeto e o mais rápido dos que testamos.
- 64 GB: o 2 bits ou o 3 bits (IQ3_XXS). O 3 bits é mais lento e, nos nossos testes, entregou mais jogos limpos.
- 96 GB ou mais: o IQ3_S, que o projeto diz igualar o modelo original nos testes publicados. Não testamos.
Atenção a três avisos do projeto: no Windows com placa AMD o suporte é recente (uma placa por modelo e sem leitura de imagens por enquanto), o PC pode ficar lento ou travado de 1 a 3 minutos enquanto o modelo carrega, e o uso comercial do modelo está sujeito à licença dele (Qwen Community), que vale a pena ler antes.
O olhar de QA
A coisa mais importante deste teste não é o número de tokens por segundo, é o que ele muda no seu dia a dia. Com 63 tokens por segundo, esperar um programa de mil linhas deixou de ser “vá tomar um café” e virou uma espera curta, e é aí que um modelo local começa a ser usável de verdade como ferramenta de trabalho. O cuidado que eu teria como QA é não confundir “abre” com “funciona”: nossos três modelos tiraram nota estrutural 10 em quase tudo, e mesmo assim parte dos jogos tinha erros que só aparecem quando alguém joga. Se você for usar um modelo local para escrever código, teste o resultado antes de confiar, exatamente como faria com um colega novo.
Como testamos e o que ainda falta
- Não é uma comparação só de compressão. O 1 bit rodou no llama.cpp, com duas placas, 32 mil de contexto, sem palpite (MTP) e com a amostragem padrão do Qwen3.8 (temperatura 1,0). O 2 e o 3 bits rodaram no Strata, com uma placa, 96 mil de contexto e palpite (MTP) ativado, e chegaram a 68,2 tokens por segundo no 2 bits e 50,7 no 3 bits, as velocidades máximas que medimos.
- Por que o 1 bit precisou de duas placas e ficou em 32 mil de contexto. Pelo tamanho do modelo (69,5 GB), tivemos que dividi-lo entre as duas placas no llama.cpp e deixar o restante na memória RAM. Para piorar, não conseguimos fazer o palpite (MTP) funcionar no nosso PC: testamos vários arquivos de MTP no llama.cpp e nenhum carregou. E ficamos limitados a 32 mil tokens de janela de contexto: acima disso, a memória de vídeo das duas placas estourava, parte dos especialistas ia para a RAM do sistema e a velocidade caía de 20–21 para 13–14 tokens por segundo.
- Com o Strata, o mesmo modelo roda numa placa só. Como explicamos acima, ele traz o palpite embutido e deixa o resto dos pesos na RAM. Por isso rodou versões maiores e menos comprimidas que a de 1 bit, a 50 tokens por segundo ou mais, conforme a versão.
- O 1 bit se corrigiu com pouco espaço. Com 32 mil de contexto, o pedido de correção (o jogo anterior já ocupa quase tudo) deixa pouca janela para a resposta: a correção do VOO LIVRE parou por limite de texto. No Strata, com 96 mil, esse problema não aparece.
- Uma rodada por teste. Os resultados podem variar de uma rodada para outra e a velocidade variou cerca de 10% entre duas medições do mesmo modelo no mesmo PC.
- Corrigimos um erro nosso. Na primeira rodada do 2 bits, nosso programa de teste leu a resposta do Strata com a codificação errada e deformou os acentos dos arquivos. Descobrimos, corrigimos e refizemos a rodada inteira antes de publicar estes números. Outro erro nosso: a correção do BOMBA LAB no 3 bits foi recusada na primeira vez porque pedimos uma resposta 887 tokens maior do que cabia no contexto. Ajustamos o teste e refizemos só essa correção.
- Falta a nota funcional, dada por quem joga, e uma bateria maior de testes, inclusive com outros tipos de tarefa (escrita, resumo, raciocínio).
Perguntas frequentes sobre o Qwen3.8-Flash-Next no PC
O Qwen3.8-Flash-Next roda numa placa de vídeo comum?
Sim, com o Strata. Segundo o projeto, basta uma placa NVIDIA (RTX 20 em diante) ou uma AMD da lista do projeto com 12 GB de VRAM ou mais, junto com 32 GB de RAM ou mais. No nosso teste, uma RX 9070 XT de 16 GB com 64 GB de RAM rodou as versões de 2 e de 3 bits.
Quanta memória RAM é preciso para rodar o Qwen3.8-Flash-Next?
Depende da versão: 32 GB para a versão Coder, 48 GB para o 2 bits e 64 GB para o 2 ou o 3 bits. Para entender quanto cada tipo de modelo pede da placa de vídeo, veja o nosso guia quanta VRAM você precisa para IA local. Se você ainda vai montar a máquina, vale ler também se um mini PC para IA local vale a pena.
Qual versão escolher: 2 ou 3 bits?
Se a prioridade é velocidade, o 2 bits: média de 63 tokens por segundo no nosso PC. Se a prioridade é acertar de primeira, o 3 bits: foi o único que fechou os quatro jogos sem problemas na triagem, a 48 tokens por segundo de média.
Vale trocar o Qwen3.8 27B pelo Flash-Next?
Depende do que pesa mais para você. No mesmo PC e nos mesmos quatro jogos, o Qwen3.8 27B escreveu a 23–26 tokens por segundo, nas duas placas, e tirou nota estrutural 10 em todos. O Flash-Next de 2 bits no Strata foi cerca de 2,5 vezes mais rápido, com uma placa só, mas pede de 48 a 64 GB de RAM. Os dois estão lado a lado no AiTester do Laboratório de IA.
Veja os testes completos no Laboratório de IA
Todos os jogos, as notas, o comparador lado a lado e os links de download das três versões estão no nosso Laboratório de IA. O cadastro é gratuito e leva um minuto, e libera o comparador completo e os resultados de todos os testes.
E você? Qual PC você tem hoje e qual versão tentaria rodar? Conta aqui nos comentários.
Para receber guias como este, inscreva-se na newsletter do TechDescomplicado. É grátis, e chega uma vez por semana no seu e-mail.
Resumo
- O Strata é um programa gratuito que roda o Qwen3.8-Flash-Next (125 bilhões de parâmetros) num PC de casa, com uma placa de 12 GB ou mais e 32 GB de RAM ou mais.
- No nosso PC, o 1 bit no llama.cpp escreveu a 19 tokens por segundo; o 2 bits no Strata, a 63; o 3 bits, a 48, com uma placa a menos.
- Jogos sem problemas na triagem automática: 1 de 4 no 1 bit, 2 de 4 no 2 bits e 4 de 4 no 3 bits. A nota funcional, de quem joga, ainda vem.
- O modelo pago que usamos como régua ainda faz melhor, mas a distância encolheu e o modelo local é gratuito.
- O Strata roda só o Qwen3.8-Flash-Next e variantes, não outros modelos.
Fontes
- Strata no GitHub (README e documentação, licença MIT)
- Strata: tamanhos, velocidades e requisitos de cada versão (docs/MODELS.md)
- Qwen/Qwen3.8-Flash-Next (Hugging Face)
- ISTA-DASLab: versões comprimidas GSQ-RCO (Hugging Face)
- Unsloth: Qwen3.8-Flash-Next GGUF, versão de 1 bit (Hugging Face)
- Medições próprias do Laboratório de IA do TechDescomplicado, 06/10/2026.