O Nanbeige 4.3 (nome completo: Nanbeige4.3-33B) é um modelo de IA aberto de 33 bilhões de parâmetros, lançado em 25/10/2026 pelo laboratório de pesquisa do BOSS Zhipin, um aplicativo chinês de vagas de emprego. Os gráficos do fabricante o colocam à frente do Qwen3.8 27B e da Gemma 4 31B em tarefas de agente e programação. Nós rodamos o modelo inteiro em duas placas de vídeo de PC doméstico, por cerca de 14 horas. Ele resolveu bem o teste de agente, mas pensou tanto que não entregou nenhum dos jogos que pedimos. Abaixo estão os números e o porquê.
O que é o Nanbeige 4.3
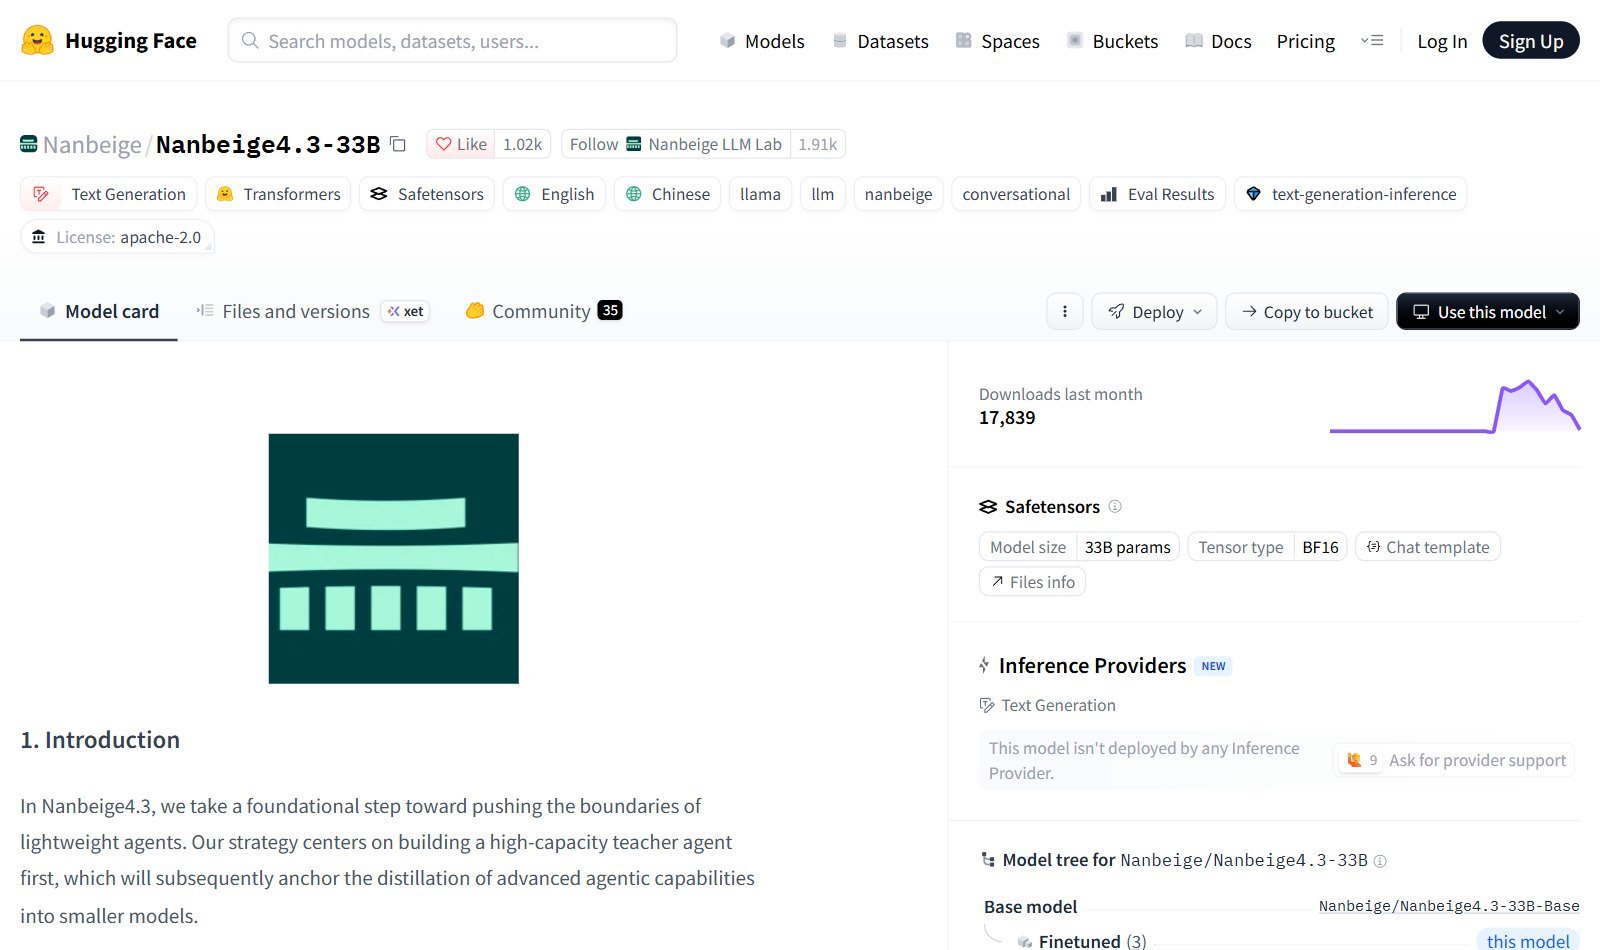
É um modelo de linguagem, da mesma família de tecnologia do ChatGPT, com os pesos liberados para qualquer pessoa baixar e rodar no próprio computador. Quem fez foi o Nanbeige LLM Lab, a equipe de IA do BOSS Zhipin. A licença é a Apache 2.0, que permite até uso comercial. O laboratório chama o 33B de modelo “professor”: a ideia é usá-lo para ensinar uma versão de 3 bilhões de parâmetros, que ainda não saiu.
| Quem fez | Nanbeige LLM Lab (BOSS Zhipin, China) |
| Lançamento | 25/10/2026 |
| Tamanho | 33 bilhões de parâmetros, denso (todos trabalham em cada palavra) |
| Arquitetura | Llama clássica, 52 camadas |
| Contexto máximo declarado | 524.288 tokens (512 mil) |
| Recursos | raciocínio ligado por padrão e uso de ferramentas |
| Licença | Apache 2.0 |
| Arquivo que usamos | Q4_K_M de 20,8 GB (versão GGUF do bartowski) |
Os números do fabricante impressionam: 80,9 no Terminal-Bench 2.1, contra 73,0 do Qwen3.8 27B, e 65,5 no DeepSWE, contra 42,5. Em outras provas ele empata ou perde, como no SWE-Bench Pro (60,3 contra 61,7 do Qwen) e no GPQA Diamond (89,5 contra 91,3 da Gemma 4 31B). Esses resultados são do próprio laboratório e ainda não têm confirmação independente.
A medição independente que existe aponta o mesmo traço que vimos aqui. No índice da Artificial Analysis, ele marca 20 pontos de inteligência, acima da mediana de 13 dos modelos comparáveis, mas gastou 160 milhões de tokens para fazer a avaliação inteira. É o mais “falante” de 8 modelos do mesmo porte, com o dobro da mediana, que é de 78 milhões.
Testamos o Nanbeige 4.3 na nossa bancada
A bancada é um PC de casa com duas placas de vídeo, uma RX 9070 XT de 16 GB e uma Arc B580 de 12 GB, rodando o llama.cpp. O arquivo de 20,8 GB não cabe numa placa só, então ele foi dividido entre as duas. O modelo rodou de 02/11 às 19h49 até 03/11 às 09h40, e cada teste teve o mesmo pedido e o mesmo prazo que todos os outros modelos do Laboratório de IA.
| Teste | Resultado |
|---|---|
| Agente: criar um leitor de planilha CSV, com testes | 4 de 5 critérios cumpridos; usou os 30 minutos inteiros do teste |
| 4 jogos com harness (Voo Livre, Hexágono, Bomberman e Corredor 3D) | nenhum jogo entregue: o raciocínio gastou o limite de 32.768 tokens antes do código |
| Os mesmos 4 jogos sem harness, direto na API | passaram de 2 horas cada, com cerca de 40 mil tokens de raciocínio, e foram cancelados |
| Painel (Pulse), Nexus e Ferramentas | não rodaram: a janela de 14 horas da bancada acabou antes |
O teste de agente mostra que ele sabe trabalhar: fez dez chamadas de ferramenta, editou o código, rodou os testes e não errou nenhuma vez o formato dos comandos. O problema aparece quando a tarefa pede um arquivo grande, como um jogo inteiro. No Voo Livre, ele fez seis chamadas de ferramenta e rodou o código duas vezes, mas a conta de tokens acabou no meio. Nos outros três jogos, passou os 80 minutos só pensando, sem fazer uma única chamada.
Não é um caso só nosso. Num teste publicado pela MindStudio, o modelo ficou mais de uma hora atrás de um erro de cálculo e apontou 14 a 15 “problemas” diferentes, nenhum deles o verdadeiro. Num pedido simples de animação em HTML, pensou por 45 minutos e bateu o limite de tokens sem terminar o arquivo.
Por que o Nanbeige 4.3 fica lento no PC
A lentidão tem três causas, e nenhuma é configuração errada. A primeira: ele é denso, então cada palavra gerada passa pelos 33 bilhões de parâmetros. Um modelo MoE como a Gemma 4 26B usa só 4 bilhões por palavra, por isso chega a mais de 100 tokens por segundo na mesma máquina. A segunda: com o modelo dividido, uma placa espera a outra, e a Arc B580, que tem menos banda de memória, segura o conjunto.
A terceira é a memória da conversa, que os técnicos chamam de cache KV. A arquitetura Llama clássica guarda essa memória nas 52 camadas, cerca de 0,2 MB por token em precisão cheia. Com 96 mil tokens de contexto, isso daria uns 20 GB só de memória da conversa. Foi preciso comprimir essa memória em 4 bits (KV q4) para tudo caber nos 28 GB das duas placas. Na compressão padrão da bancada, de 8 bits, o modelo vazava para a memória RAM até com 64 mil tokens e caía para 8,8 tokens por segundo. E, quanto mais o raciocínio cresce, mais memória cada palavra nova precisa consultar:
| Situação | Velocidade de escrita |
|---|---|
| Resposta curta, sem raciocínio | 22 tokens/s |
| Teste de agente (30 minutos) | 11,3 tokens/s |
| Jogos com harness (80 minutos) | 6,8 a 7,1 tokens/s |
| Jogos sem harness, depois de 40 mil tokens de raciocínio | 4,4 a 5,6 tokens/s |
Para comparar, dois modelos densos do mesmo porte que rodam nas mesmas duas placas: o Qwen3.8 27B escreve por volta de 24 tokens por segundo, e a Gemma 4 31B, de 25 a 30. Os dois têm MTP, um recurso que adianta várias palavras de uma vez. O Nanbeige 4.3 não tem MTP, e o irmão pequeno que poderia acelerar a escrita, a versão de 3B da mesma geração, ainda não saiu. Se você está escolhendo placa para esse tipo de modelo, o nosso guia de quanta VRAM é preciso para IA local ajuda na conta.
Foi o modelo ou foi a nossa configuração?
Uma parte pode ser nossa, e é justo dizer. O cartão do fabricante recomenda, para tarefas de agente, temperatura 1.0 e até 65.536 tokens de resposta. A nossa bancada usa temperatura 0.6 e um limite de 32.768 tokens para todos os modelos, para a comparação ser igual. Com o dobro de tokens, talvez algum jogo saísse; nesse ritmo, porém, cada um levaria umas 3 horas. A compressão da memória em 4 bits também pode tirar um pouco de precisão, mas sem ela o modelo não roda com contexto longo em 28 GB.
O que não muda com configuração é o volume de raciocínio. A Artificial Analysis, com outro equipamento e outro método, chegou à mesma conclusão: é o modelo que mais gasta tokens no grupo dele.
Como rodar o Nanbeige 4.3 no seu PC
O arquivo em GGUF roda em qualquer programa que leia esse formato, como o llama.cpp, o LM Studio e o Ollama. A versão de 4 bits tem 20,8 GB, então o mínimo realista é ter uns 24 GB de VRAM para conversas curtas, ou 28 GB ou mais para contexto longo com a memória comprimida. Com menos que isso, parte do modelo vai para a RAM e a velocidade cai muito. Para ver o que cabe na sua placa, a lista de modelos que medimos está no comparador do Laboratório.
Minha opinião
Benchmark é prova com gabarito publicado. O modelo pode ir muito bem nela e ainda assim travar no primeiro pedido que não se parece com a prova. Com o Nanbeige 4.3, a distância entre os gráficos e o uso real foi das maiores que já medimos: quatro pedidos de jogo e nenhum jogo.
Pensar antes de responder é bom até virar custo. Na nuvem, cada token de raciocínio é cobrado. No PC de casa, ele vira horas de placa ligada e conta de luz. Um modelo que precisa de 40 mil tokens para começar a escrever um jogo simples não está pensando melhor, está pensando mais.
Para quem tem 32 GB ou mais de VRAM e gosta de testar, vale baixar e usar a configuração de agente do fabricante. Para o uso do dia a dia nessas mesmas placas, eu ficaria com o Qwen3.8 27B ou a Gemma 4 31B, que entregam mais rápido. Vou ficar de olho na versão de 3B, que pode herdar o que o 33B faz bem sem o peso dele.
Todos os números que medi com o Nanbeige 4.3 na bancada, teste por teste e jogo por jogo, estão na página do Nanbeige 4.3 no Laboratório.
Perguntas frequentes
O que é o Nanbeige 4.3?
É um modelo de IA aberto de 33 bilhões de parâmetros, do laboratório de pesquisa do BOSS Zhipin, lançado em 25/10/2026 com licença Apache 2.0. Foi feito para tarefas de agente e programação.
O Nanbeige 4.3 roda no meu PC?
Roda se você tiver bastante memória de vídeo. A versão de 4 bits tem 20,8 GB; na nossa bancada, com duas placas somando 28 GB, ele escreveu de 5 a 22 tokens por segundo, conforme o tamanho da resposta.
O Nanbeige 4.3 é gratuito?
Sim. Os pesos estão no Hugging Face sob a licença Apache 2.0, que permite uso pessoal e comercial.
O Nanbeige 4.3 é melhor que o Qwen3.8 27B?
Nos gráficos do fabricante, sim, na maioria das provas de agente. Na nossa bancada, o Qwen3.8 27B foi bem mais rápido nas mesmas placas, e o Nanbeige não entregou nenhum jogo.
Existe uma versão menor do Nanbeige?
O laboratório tem modelos de 3B das gerações anteriores, como o Nanbeige4.1-3B. A versão 4.3 de 3B foi anunciada como próximo passo, mas ainda não foi lançada.
Você prefere um modelo que pensa muito ou um que responde rápido? Conta aqui nos comentários.
Resumo
- Nanbeige 4.3: modelo aberto de 33B do laboratório do BOSS Zhipin, lançado em 25/10/2026, licença Apache 2.0.
- Nos gráficos do fabricante, à frente do Qwen3.8 27B na maioria das provas de agente.
- Na nossa bancada: 4 de 5 no teste de agente, nenhum jogo entregue e de 5 a 22 tokens por segundo em duas placas.
- O motivo principal é o volume de raciocínio, confirmado pela Artificial Analysis e por um teste da MindStudio.
Fontes
- Hugging Face: Nanbeige/Nanbeige4.3-33B (cartão oficial e configuração)
- Artificial Analysis: Nanbeige4.3-33B (índice de inteligência e verbosidade)
- MarkTechPost: Nanbeige Releases Nanbeige4.3-33B (25/10/2026)
- MindStudio: Nanbeige 4.3 33B, Benchmark Charts vs. a Real Debugging Test (27/10/2026)
- Medições próprias: bancada do Laboratório de IA, 02 e 03/11/2026 (llama.cpp b11938, Vulkan, RX 9070 XT 16 GB + Arc B580 12 GB, Q4_K_M, KV q4, 96 mil tokens de contexto, temperatura 0.6).