O que é GGUF? É o formato de arquivo que guarda um modelo de IA inteiro, pronto para rodar no seu computador: os “pesos” do modelo, o dicionário de palavras (tokenizador) e as informações de como ele funciona, tudo num arquivo só. Ele foi criado pela comunidade do llama.cpp, e é o que o LM Studio, o Ollama e o próprio llama.cpp abrem por baixo dos panos. Quando você vai baixar um modelo e aparece uma lista de arquivos com nomes como Q4_K_M, Q8_0 e IQ3_XXS, todos são GGUF; o que muda entre eles é a quantização, ou seja, quanto o modelo foi comprimido.
A dúvida que trava quase todo mundo na primeira vez é justamente essa: qual dos arquivos baixar. Neste guia eu explico o que é um arquivo GGUF, o que significa cada sigla, quanto cada nível de compressão ocupa e o que perde, e como escolher o certo para a sua placa de vídeo. Tudo com números que já medimos na bancada do Laboratório de IA, onde já passaram 22 modelos, e com um teste novo: o mesmo modelo medido em 5 quantizações diferentes.
O que é GGUF, em poucas palavras
GGUF é um formato binário feito para carregar e rodar modelos de linguagem de forma rápida em computador comum. Quem criou foi Georgi Gerganov, o desenvolvedor do llama.cpp, e ele substituiu em 2023 o formato anterior, o GGML. A grande diferença para formatos como o safetensors, que guardam só os números do modelo, é que o GGUF leva junto os metadados: arquitetura, tamanho de contexto, tokenizador e o modelo de conversa. Por isso basta um arquivo para o programa saber como usar o modelo.
| Formato | Para que serve | Onde você encontra |
|---|---|---|
| GGUF | Rodar o modelo em casa (inferência), com quantização embutida, em placa de vídeo, CPU ou as duas juntas | llama.cpp, LM Studio, Ollama, GPT4All |
| Safetensors | Guardar os pesos originais, treinar e ajustar o modelo | Repositório oficial do modelo no Hugging Face, PyTorch |
| GPTQ e AWQ | Modelos comprimidos para rodar em placa de vídeo, principalmente NVIDIA | vLLM e outros servidores |
O que é quantização (e por que ela decide o que cabe no seu PC)
Quantização é guardar cada peso do modelo com menos bits. Pense numa música: o arquivo do estúdio é enorme, um MP3 de 320 kbps já é bem menor e quase ninguém percebe diferença, e um de 64 kbps cabe em qualquer lugar, mas o som fica abafado. Com o modelo é igual: a versão original usa 16 bits por peso; a de 4 bits ocupa quase um quarto e perde muito pouco; a de 2 bits cabe numa placa pequena, mas começa a errar mais.
Isso importa porque, para rodar rápido, o modelo inteiro precisa caber na memória da placa de vídeo (a VRAM). O Qwen3.8 27B completo tem 54 GB e não cabe em nenhuma placa de casa; em 4 bits ele cai para 17,6 GB e roda nas nossas duas placas somadas; em 3 bits, 10,9 GB, cabe numa só.
Como ler o nome do arquivo GGUF: Q4_K_M, Q8_0, IQ3_XXS
O nome parece código, mas segue uma lógica simples. O número depois do Q é quantos bits sobram, em média, para cada peso. O resto diz qual método foi usado.
| Pedaço do nome | O que significa | Exemplo |
|---|---|---|
| Q + número | Quantizado, com aquele número de bits por peso (aproximado) | Q4 = cerca de 4 bits |
| _K | “K-quants”: o modelo é comprimido em blocos, cada um com a sua escala; é o método mais usado hoje | Q4_K, Q6_K |
| _S, _M, _L, _XL | Pequeno, médio, grande: quanto das partes mais sensíveis do modelo fica com mais bits | Q4_K_M é o meio-termo |
| IQ | Usa uma “matriz de importância” para decidir onde perder; costuma render mais por GB em 2 e 3 bits | IQ3_XXS, IQ2_XS |
| _0 e _1 | Métodos antigos (legado), ainda comuns no Q8_0 | Q8_0, Q4_0 |
| UD | “Unsloth Dynamic”: mistura níveis diferentes camada a camada (nome usado pela Unsloth) | UD-Q4_K_XL |
| F16 / BF16 | Sem compressão (16 bits) | Arquivo do tamanho do original |
Tamanho de cada quantização: a conta que bate com os arquivos reais
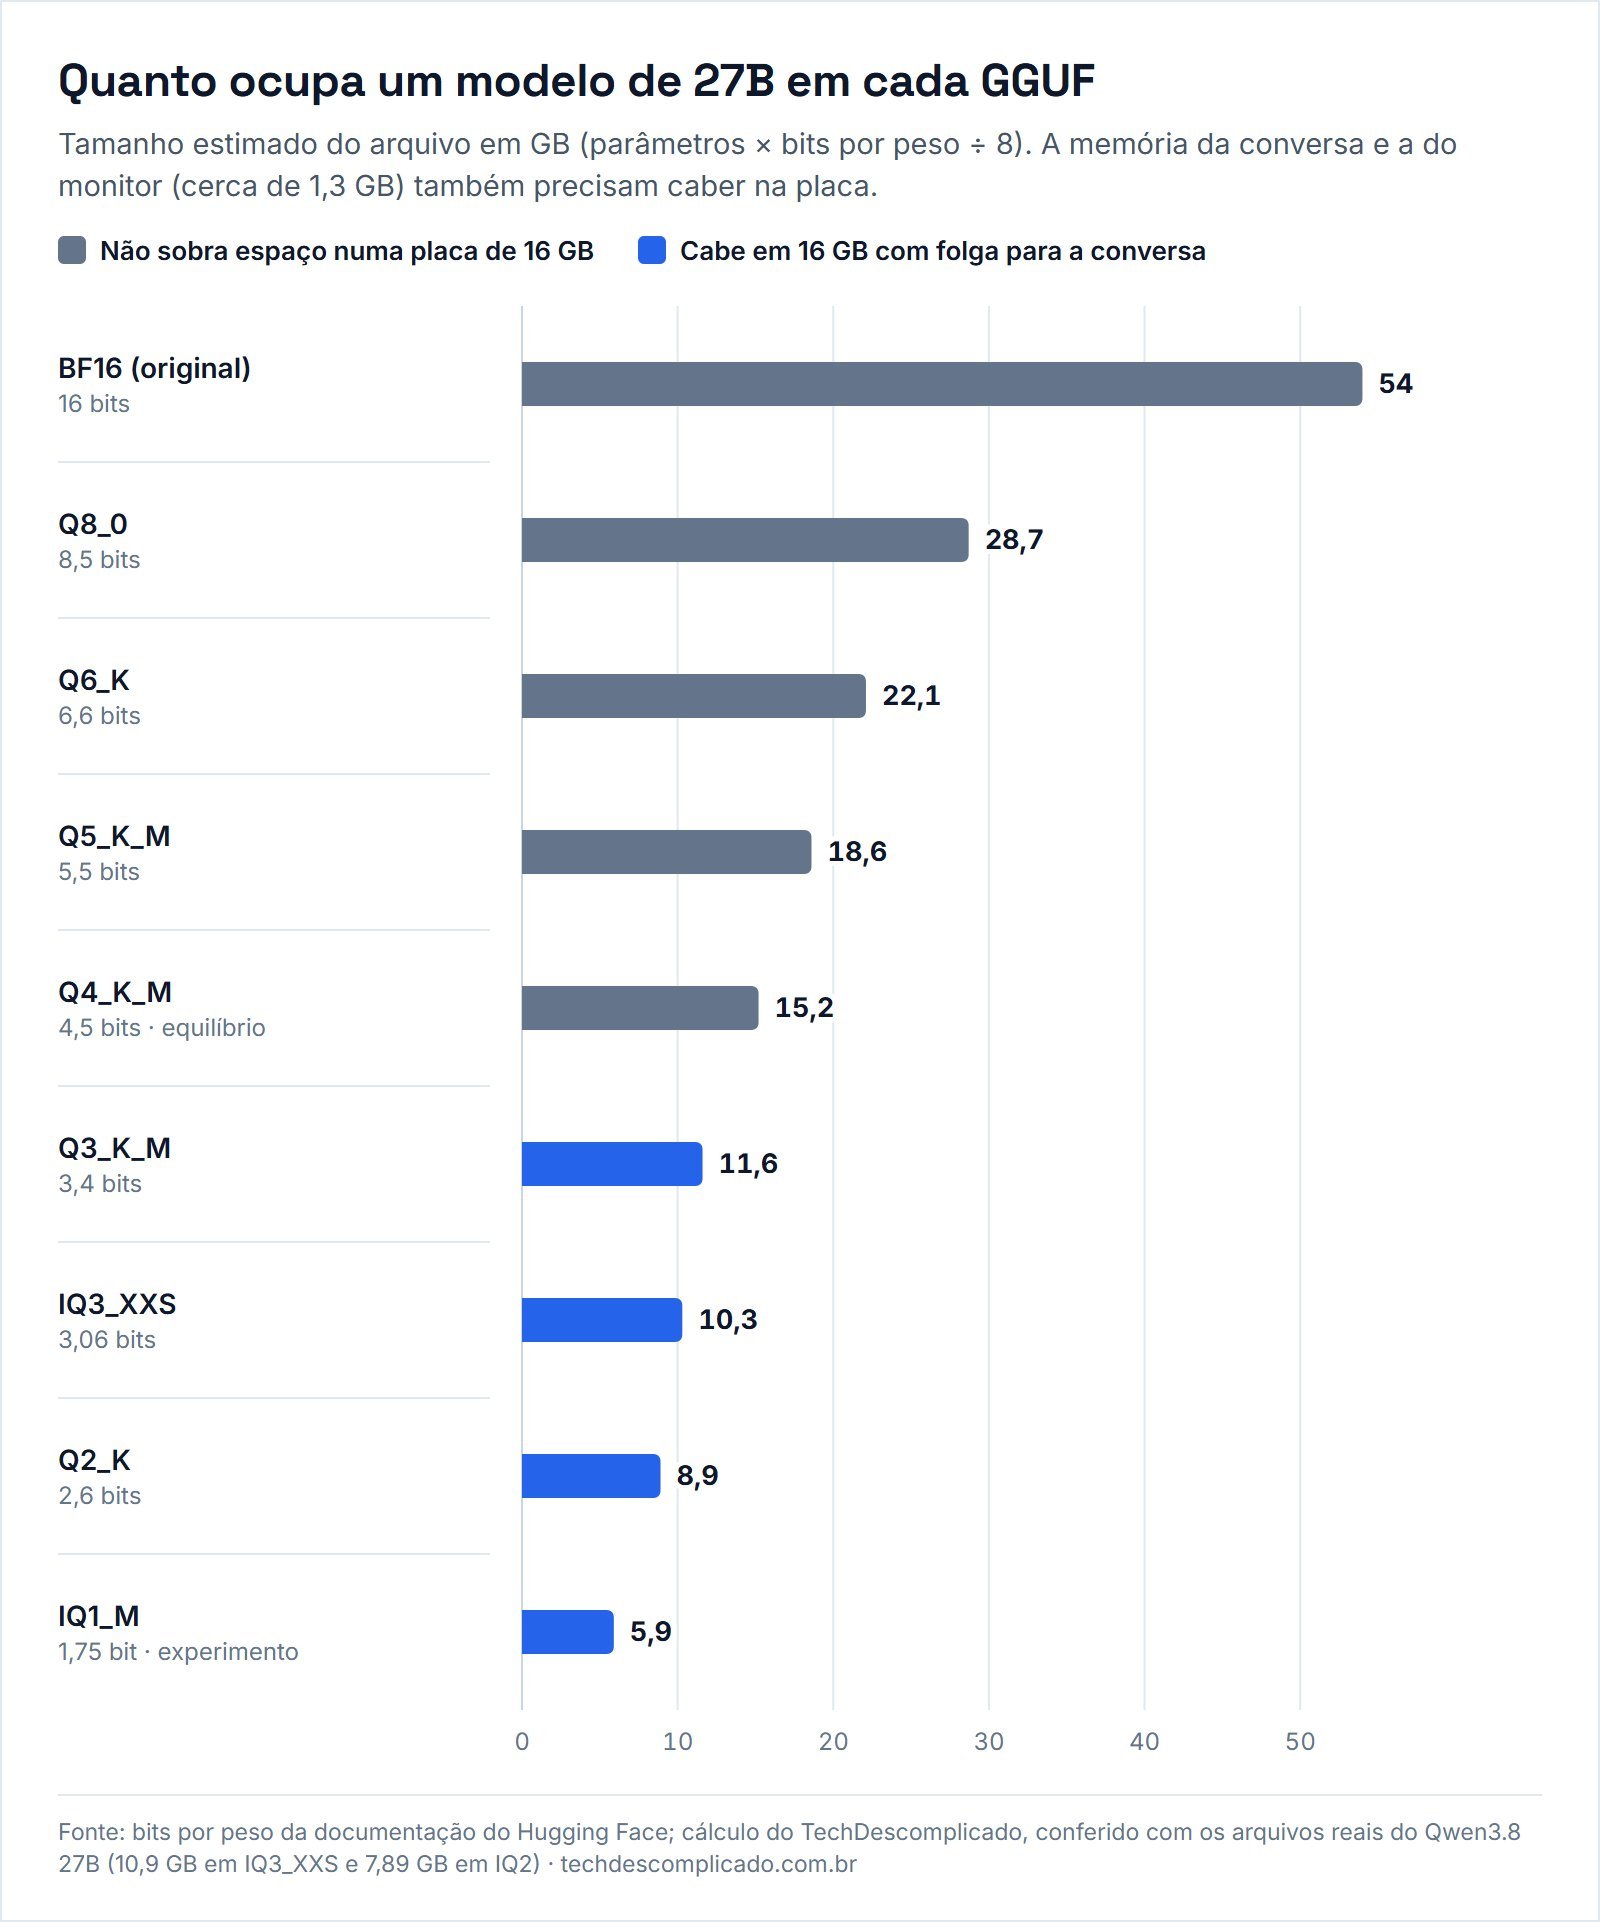
Dá para estimar o tamanho de qualquer GGUF antes de baixar: número de parâmetros vezes bits por peso, dividido por 8. A tabela abaixo usa os bits por peso publicados pelo Hugging Face para três tamanhos comuns de modelo. Na nossa bancada, a conta bateu com os arquivos de verdade: o Qwen3.8 27B em IQ3_XXS tem 10,9 GB (a conta dá 10,3) e o Saluki, um 27B de 2 bits do tipo IQ2, tem 7,89 GB (a conta dá 7,8). A diferença é a parte do modelo que fica sempre com mais bits.
| Quantização | Bits por peso | Modelo de 8B | Modelo de 14B | Modelo de 27B | Qualidade, na prática |
|---|---|---|---|---|---|
| BF16 (original) | 16 | 16 GB | 28 GB | 54 GB | Referência |
| Q8_0 | 8,5 | 8,5 GB | 14,9 GB | 28,7 GB | Praticamente igual ao original |
| Q6_K | 6,6 | 6,6 GB | 11,5 GB | 22,1 GB | Diferença difícil de notar |
| Q5_K_M | 5,5 | 5,5 GB | 9,6 GB | 18,6 GB | Muito boa |
| Q4_K_M | 4,5 | 4,5 GB | 7,9 GB | 15,2 GB | O ponto de equilíbrio |
| IQ4_XS | 4,25 | 4,2 GB | 7,4 GB | 14,3 GB | Perto do Q4_K_M, um pouco menor |
| Q3_K_M | 3,4 | 3,4 GB | 6,0 GB | 11,6 GB | Começa a perder em tarefa difícil |
| IQ3_XXS | 3,06 | 3,1 GB | 5,4 GB | 10,3 GB | Perde mais; útil para caber numa placa |
| Q2_K / IQ2_XS | 2,3 a 2,6 | 2,3 a 2,6 GB | 4,0 a 4,6 GB | 7,8 a 8,9 GB | Erra bem mais em raciocínio longo |
| IQ1_M | 1,75 | 1,8 GB | 3,1 GB | 5,9 GB | Só experimento |
O que perde ao comprimir: o que a nossa bancada já mediu
Comprimir é trocar qualidade por espaço e, muitas vezes, por velocidade. Nos nossos testes, o padrão se repetiu: em 4 bits a perda é pequena; abaixo de 3 bits o modelo continua funcionando, mas erra mais, principalmente quando precisa de raciocínio longo ou de escrever um programa inteiro.
| O que medimos | Resultado |
|---|---|
| Qwen3.8-Flash-Next 125B, 4 programas completos em 1, 2 e 3 bits | Programas sem problema: 1 em 4 (1 bit), 2 em 4 (2 bits) e 4 em 4 (3 bits) |
| Mesmo teste, velocidade | 18 a 20 tokens por segundo (1 bit, llama.cpp), 63 em média (2 bits) e 47 a 51 (3 bits), no programa Strata |
| Qwen3.8 27B em 4 bits (UD-Q4_K_XL, 17,6 GB) | Precisa das duas placas: 21,7 tokens por segundo (33,8 com o “palpite” MTP) |
| Qwen3.8 27B em 3 bits (IQ3_XXS, 10,9 GB) | Cabe numa placa só: de 47 a 54 tokens por segundo com MTP, cerca de 1,5 vez o 4 bits nas duas placas |
Testes de fora apontam na mesma direção. Um estudo da Quesma com o Qwen3.8 27B mostrou que a versão de 4 bits empata com o modelo completo num teste de agente de programação, a de 2 bits funciona “até certo ponto” e a de 1 bit desaba. E no teste independente do Saluki, um 27B de 2 bits ajustado para agentes, ele resolveu 76,7% dos problemas de código, contra 91,7% da versão de 2 bits de onde saiu. Os detalhes estão no nosso artigo do Qwen3.8 27B em Q2 e no teste do Qwen3.8-Flash-Next com o Strata.
Medimos: o mesmo modelo em 5 quantizações
Atualização de 20/10/2026. Faltava uma resposta direta para a pergunta “comprimir deixa o modelo pior?”, com o resto todo igual. Então pegamos o Qwen3.5 4B, do mesmo repositório da Unsloth, em cinco versões: o original sem compressão (BF16, 8,4 GB), Q8_0, Q6_K, Q4_K_M e Q3_K_M. Todas rodaram na mesma placa (só a RX 9070 XT), com o mesmo programa (llama.cpp b10615), a mesma memória de conversa (160 mil tokens) e os mesmos 11 testes do Laboratório. Só o arquivo mudou.
Medimos de dois jeitos. O primeiro é uma régua objetiva: cada versão leu o mesmo texto de cerca de 51 mil palavras, e conferimos em quantas delas ela escolheu uma palavra diferente da que o original escolheria (a chamada divergência KL, a medida que a própria comunidade do llama.cpp usa para comparar quantizações). O segundo é o uso de verdade: a tarefa de agente (escrever e testar um leitor de planilhas CSV sozinho), os 4 jogos feitos com ferramentas, os 4 jogos sem ferramentas e as duas páginas, PULSE e NEXUS.
| Versão | Arquivo | Memória na placa (160k) | Velocidade | Palavras diferentes do original | Agente: casos difíceis certos (de 5) | Nota média sem ferramentas (6 testes) |
|---|---|---|---|---|---|---|
| BF16 (original) | 8,4 GB | 10,9 GB | 61 t/s | referência | 4 | 8,5 |
| Q8_0 | 4,5 GB | 7,2 GB | 100 t/s | 2,6% | 3 | 8,7 |
| Q6_K | 3,5 GB | 7,4 GB | 117 t/s | 3,6% | 2 | 8,2 |
| Q4_K_M | 2,7 GB | 5,6 GB | 137 t/s | 7,5% | 1 | 8,2 |
| Q3_K_M | 2,3 GB | 5,2 GB | 148 t/s | 13,4% | 0 | 7,2 |
A régua objetiva mostra onde está a quebra. O Q8_0 e o Q6_K ficam praticamente colados no original: menos de 4 palavras diferentes em cada 100. No Q4_K_M a diferença dobra, e no Q3_K_M ela chega a 13 em cada 100. A perplexidade (o quanto o modelo “estranha” um texto real) conta a mesma história: sobe 0,1% no Q8_0, 0,6% no Q6_K, 1,4% no Q4_K_M e 5,4% no Q3_K_M.
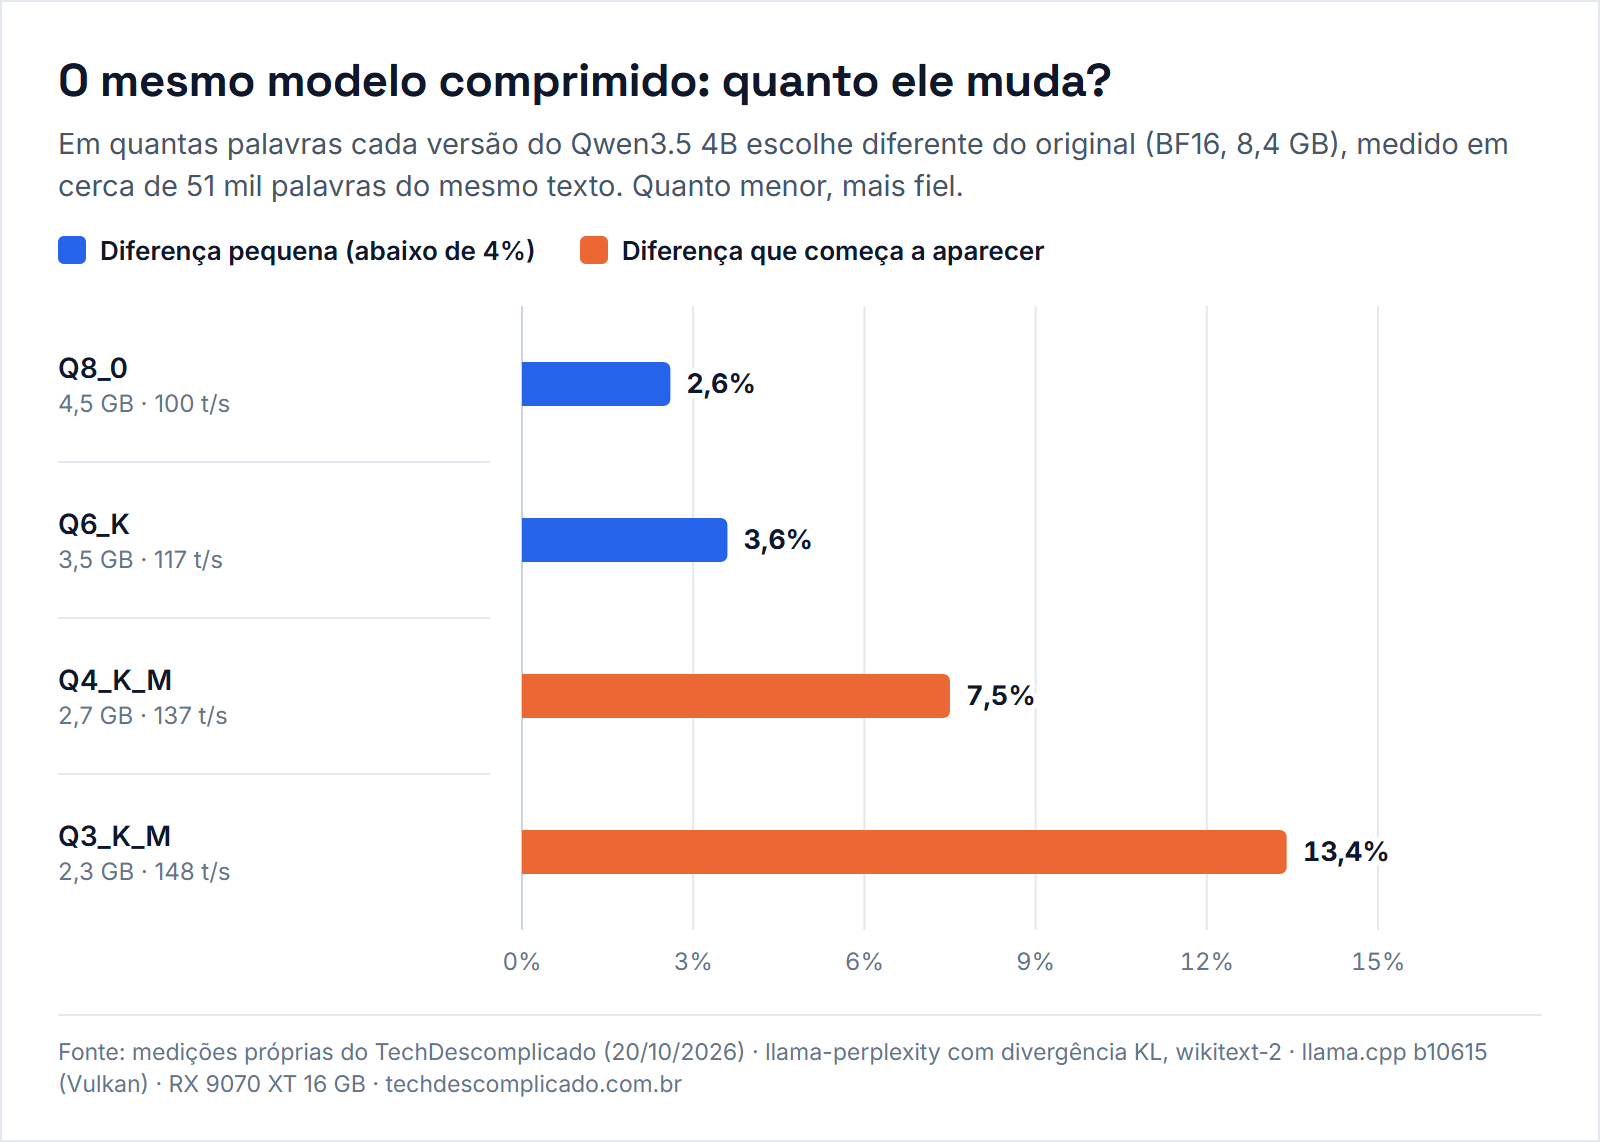
Nas tarefas, a perda apareceu onde o trabalho é mais exigente. Na tarefa de agente, os casos difíceis certos caíram junto com os bits: 4 no original, 3 no Q8_0, 2 no Q6_K, 1 no Q4_K_M e nenhum no Q3_K_M. Sem ferramentas, o Q3_K_M foi o único que quebrou um teste: no CORREDOR 3D ele escreveu até bater no limite de texto e entregou um jogo que não funciona (nota 2). Já nos 4 jogos feitos com ferramentas, todas as versões ficaram na mesma faixa de problemas graves (de 13 a 16 somando os quatro), e com uma execução só essa diferença está dentro da variação normal.
Resumindo o que medimos: neste modelo de 4B, até 6 bits a compressão é quase invisível; em 4 bits ela já aparece na régua e na tarefa de agente; em 3 bits aparece em quase tudo. Modelos pequenos costumam sentir a compressão mais que os grandes, por isso o mesmo Q4_K_M num 27B tende a perder menos, como o estudo da Quesma mostrou. E como o Q8_0 do 4B ocupa só 4,5 GB e foi a versão com melhor resultado geral, ele passou a ser o Qwen3.5 4B do nosso Laboratório, no lugar do Q6_K.
Qual quantização escolher para a sua placa de vídeo
A regra que usamos na bancada é simples: o arquivo, mais o contexto (a “memória da conversa”), mais a parte da VRAM que o Windows e o monitor já usam (aqui, cerca de 1,3 GB) precisam caber na placa. Se cabe, roda rápido. Se não cabe, parte vai para a RAM e a velocidade despenca.
| VRAM da placa | O que costuma caber com folga para conversar | Sugestão de arquivo |
|---|---|---|
| 6 a 8 GB | Modelos de 4B a 8B | 8B em Q4_K_M (~4,5 GB) ou 4B em Q8_0 |
| 12 GB | Modelos de até 14B; 27B só em 2 a 3 bits | 14B em Q4_K_M ou Q5_K_M |
| 16 GB | Modelos de até ~24B em 4 bits; 27B em 3 bits | 24B em Q4_K_M ou 27B em IQ3_XXS |
| 24 GB ou mais (ou duas placas) | Modelos de 27B a 35B em 4 bits | 27B em Q4_K_M ou Q5_K_M |
Na dúvida, comece pelo Q4_K_M: é o padrão da maioria dos repositórios e o que o Ollama baixa por padrão em muitos modelos. Se sobrar memória, suba para Q5_K_M ou Q6_K. Em modelo grande, o Q8_0 raramente compensa o dobro de espaço; em modelo pequeno, que cabe com sobra, vale: no nosso teste com o Qwen3.5 4B, o Q8_0 ocupou 4,5 GB e foi a versão mais forte. E se o modelo que você quer não cabe nem em 3 bits, quase sempre vale mais um modelo menor em 4 bits do que um maior espremido em 2. Para escolher a placa em si, o nosso guia de quanta VRAM você precisa para IA local vai mais fundo.
Onde baixar GGUF e como usar no LM Studio e no Ollama
No Hugging Face, dá para filtrar só modelos com arquivos GGUF (filtro “GGUF” na busca de modelos). Os repositórios das equipes oficiais e de quantizadores conhecidos, como Unsloth e bartowski, listam todas as versões lado a lado, com o tamanho de cada arquivo. O Hugging Face ainda mostra, na página do arquivo, os metadados e o tipo de cada camada.
- LM Studio: ao buscar um modelo, ele mostra as quantizações disponíveis e avisa quais cabem na sua placa. Escolha e baixe pela própria interface.
- Ollama: a quantização vem no “tag” do modelo; quando há opção, ela aparece no nome (por exemplo, terminando em q4_K_M ou q8_0). Também dá para importar um GGUF baixado do Hugging Face.
- llama.cpp: é só apontar para o arquivo, com
llama-server -m modelo-Q4_K_M.gguf.
Se você ainda não instalou nada, o nosso passo a passo de como rodar IA localmente no PC leva 15 minutos e já baixa o primeiro GGUF certo para a sua máquina.
Minha opinião
Quem nunca baixou o arquivo maior “porque deve ser melhor” e depois ficou olhando o modelo escrever uma palavra por segundo? A quantização é a configuração mais importante da IA local e a que menos gente explica, e o motivo é que a resposta honesta é “depende”. Depois de 20 modelos na bancada, a minha regra ficou curta: primeiro garanta que cabe inteiro na placa, depois escolha o maior número de bits que ainda cabe. Velocidade que some porque o modelo transbordou para a RAM é um defeito que você não vê na lista de arquivos, só sente na hora de usar. E desconfie de quem promete “2 bits sem perda”: nos nossos testes, perda sempre houve; o que muda é se ela importa para a tarefa que você tem.
Perguntas frequentes
O que é um arquivo GGUF?
É um arquivo único que guarda um modelo de IA com os pesos, o tokenizador e os metadados, pronto para rodar no computador com llama.cpp, LM Studio ou Ollama. Ele foi criado pelo desenvolvedor do llama.cpp e substituiu o formato GGML em 2023.
Qual a melhor quantização GGUF?
Para a maioria das pessoas, Q4_K_M: perde pouco e ocupa cerca de um quarto do modelo original. Se sobrar memória na placa, Q5_K_M ou Q6_K. Abaixo de 3 bits, só para fazer caber um modelo que não caberia de outro jeito.
Q4_K_M ou Q8_0: qual baixar?
O Q8_0 é quase idêntico ao original, mas ocupa quase o dobro do Q4_K_M. Se o Q8_0 cabe na sua placa com folga para o contexto, pode usar; se não cabe, o Q4_K_M entrega quase a mesma qualidade e roda inteiro na VRAM, o que costuma ser muito mais rápido. No nosso teste com um modelo de 4B, o Q4_K_M escolheu palavra diferente do original em 7,5% dos casos, contra 2,6% do Q8_0, e acertou menos na tarefa de agente.
O Ollama usa GGUF?
Sim. O Ollama roda modelos no formato GGUF, e a quantização aparece no nome (tag) do modelo. Também é possível importar um arquivo GGUF baixado do Hugging Face.
Qual a diferença entre GGUF e safetensors?
O safetensors guarda só os pesos do modelo e é usado para treinar e ajustar. O GGUF guarda os pesos já quantizados junto com os metadados e o tokenizador, pensado para rodar o modelo em casa.
Qual quantização você usa no dia a dia? Já se arrependeu de baixar o arquivo errado? Conta aqui nos comentários.
Resumo
- GGUF é o formato de arquivo único usado para rodar modelos de IA em casa (llama.cpp, LM Studio, Ollama).
- O nome do arquivo (Q4_K_M, Q8_0, IQ3_XXS) diz quantos bits sobram por peso e qual método de compressão foi usado.
- Tamanho estimado = parâmetros × bits por peso ÷ 8; um 27B vai de 54 GB (original) a 15 GB (Q4_K_M).
- Na nossa bancada, 3 bits fizeram 4 de 4 programas sem problema; 1 bit, só 1 de 4.
- O mesmo Qwen3.5 4B em 5 versões: Q8_0 e Q6_K quase iguais ao original; a perda aparece no Q4_K_M e cresce no Q3_K_M.
- Regra prática: o arquivo e o contexto precisam caber na VRAM; na dúvida, Q4_K_M.
Fontes
- Hugging Face: GGUF (documentação e tabela de tipos de quantização)
- GitHub ggml: especificação do formato GGUF
- GitHub llama.cpp: pull request que criou os k-quants
- Quesma: Qwen3.8 27B quantizations benchmarked
- IBM Think: GGUF versus GGML
- GitHub llama.cpp: llama-perplexity e divergência KL (como comparar quantizações)