O Lumi, modelo de inteligência artificial criado pelo CEIA, o Centro de Excelência em Inteligência Artificial da UFG (Universidade Federal de Goiás), é uma IA brasileira aberta, com 4 bilhões de parâmetros, feita para o português e pequena o bastante para rodar num PC comum. Foi apresentado nesta quarta-feira (28/10) no AI Brasil Experience 2026, em São Paulo, e os pesos já estão no Hugging Face. Nós baixamos, convertemos e rodamos o Lumi na nossa bancada no dia seguinte ao lançamento: ele é rápido e leve, vai razoavelmente como assistente, mas ainda não programa. Os números estão abaixo, lado a lado com os modelos que ele enfrenta.
O que é o Lumi, a IA brasileira da UFG
O Lumi é um modelo de linguagem, a mesma família de tecnologia do ChatGPT, só que bem menor e aberto: qualquer pessoa pode baixar o arquivo e rodar no próprio computador, sem mandar os dados para fora. O CEIA o apresenta como o seu primeiro modelo de código aberto e diz que ele foi pensado para empresas, desenvolvedores e pesquisadores criarem soluções próprias, inclusive treinando o modelo com dados internos (o chamado ajuste fino), sem exportar informação sensível.
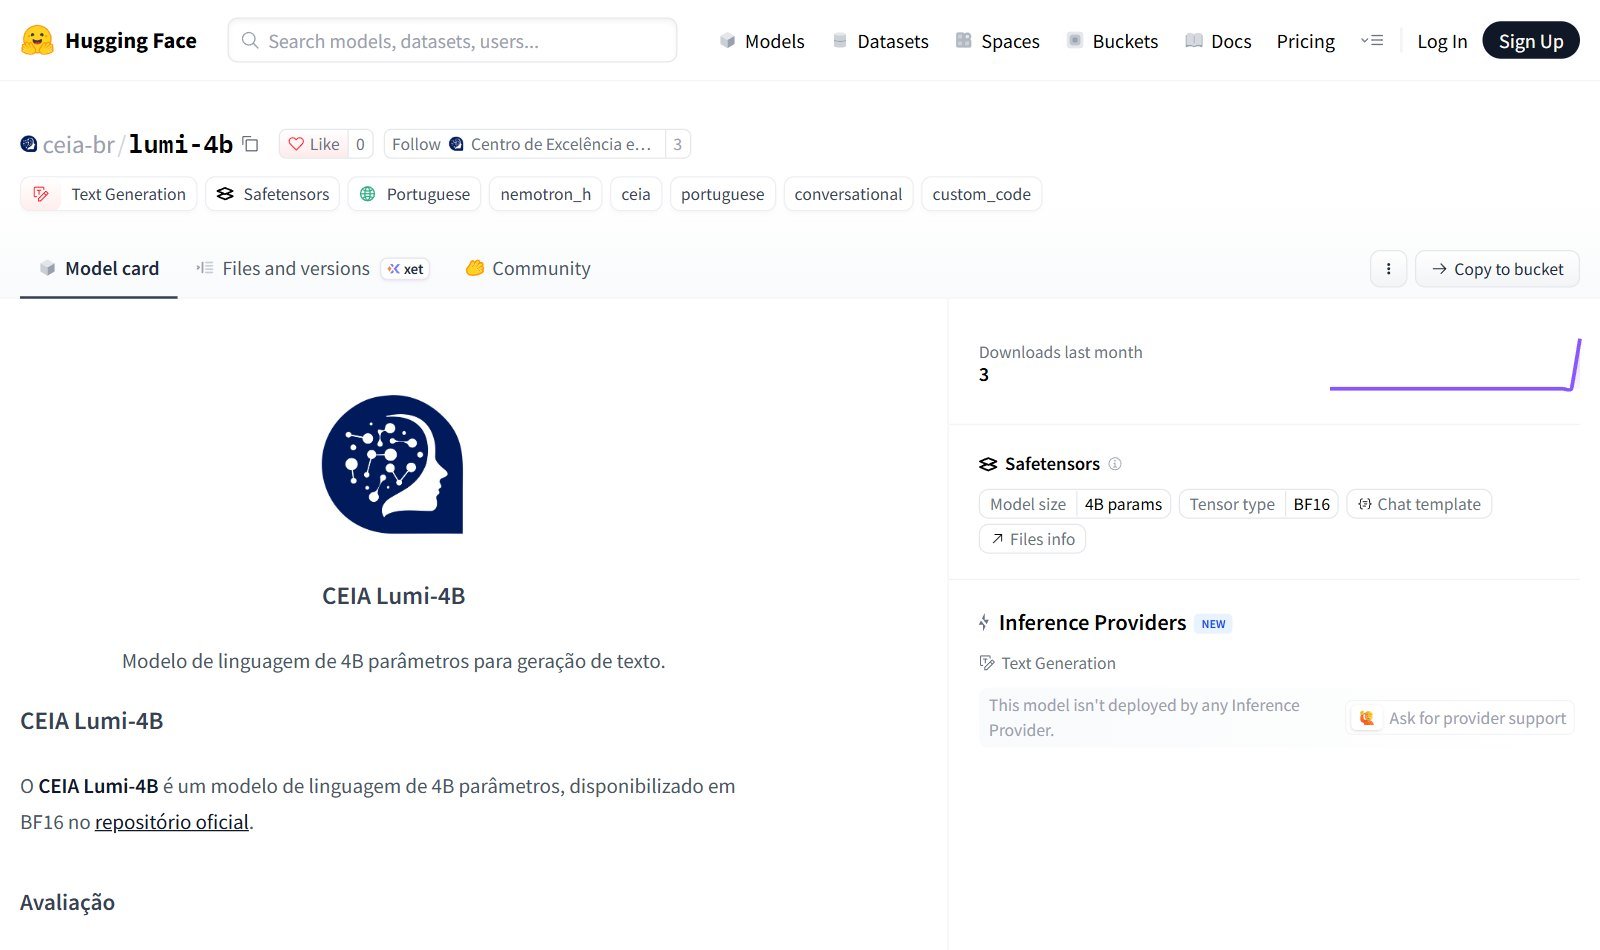
A ficha técnica que dá para conferir no próprio repositório:
| Quem fez | CEIA, Universidade Federal de Goiás |
| Tamanho | 4 bilhões de parâmetros (arquivo de 7,95 GB em BF16) |
| Arquitetura | Nemotron-H, híbrida (camadas Mamba e de atenção), a mesma do NVIDIA Nemotron-3-Nano-4B |
| Contexto máximo declarado | 262.144 tokens |
| Recursos no modelo de conversa | modo de raciocínio (ligado por padrão) e chamada de ferramentas |
| Onde baixar | huggingface.co/ceia-br/lumi-4b |
| Licença | ainda não informada na página do modelo |
Os números do CEIA: Lumi contra outros modelos pequenos
O CEIA comparou o Lumi com oito modelos do mesmo porte em cinco testes em português (conhecimento de ensino médio e de graduação, raciocínio e capacidade de seguir instruções). Na média, ele ficou em segundo lugar, atrás apenas do Qwen3.5-4B, da Alibaba, e à frente do NVIDIA Nemotron-3-Nano-4B, que tem a mesma arquitetura.
| Modelo | Média nos 5 testes em português |
|---|---|
| Qwen3.5-4B (Alibaba) | 49,5 |
| Lumi-4B (CEIA/UFG) | 44,8 |
| Qwen3-4B-Instruct-2507 (Alibaba) | 43,9 |
| NVIDIA Nemotron-3-Nano-4B | 43,4 |
| Gemma-3-4B-IT (Google) | 39,4 |
| Llama-3.2-3B (Meta) | 36,3 |
| Tucano2-Qwen-3.7B | 35,6 |
| Gemma-3-Gaia-PT-BR-4B (CEIA/UFG) | 33,0 |
| Tucano-2B4 | 5,8 |
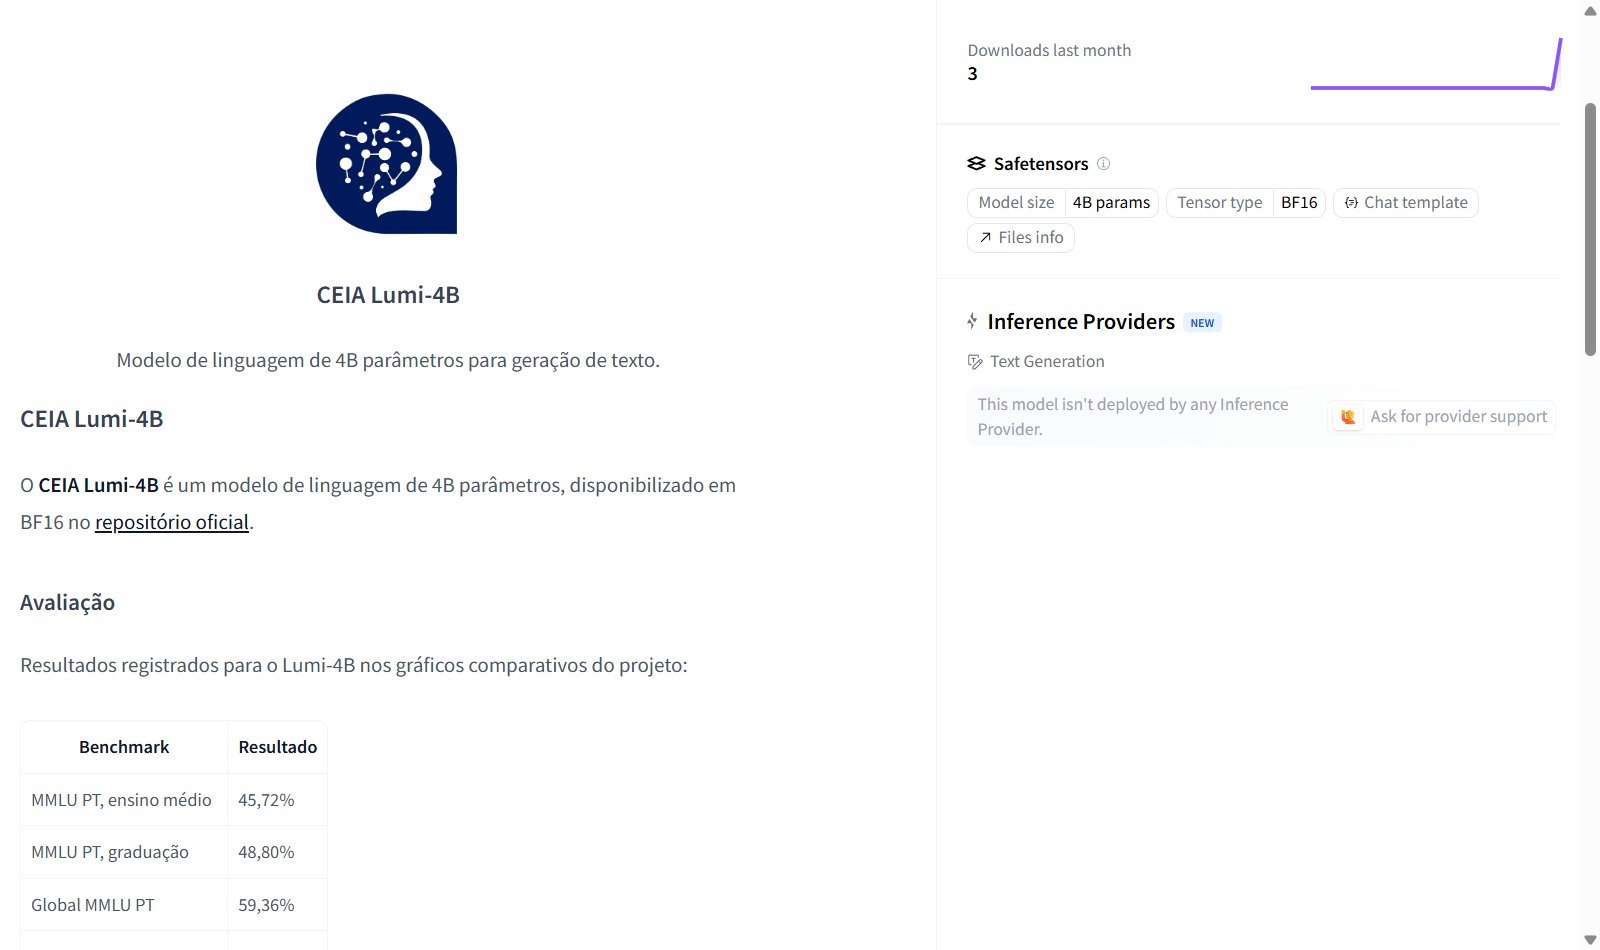
Por teste, o Lumi fez 45,72% no MMLU em português de ensino médio, 48,80% no de graduação, 59,36% no Global MMLU, 36,28% no MMLU-ProX e 33,83% no IFEval, que mede se o modelo segue instruções à risca. Esse último é o mais fraco, e é justamente o que mais pesa no uso do dia a dia.
Testamos o Lumi na nossa bancada
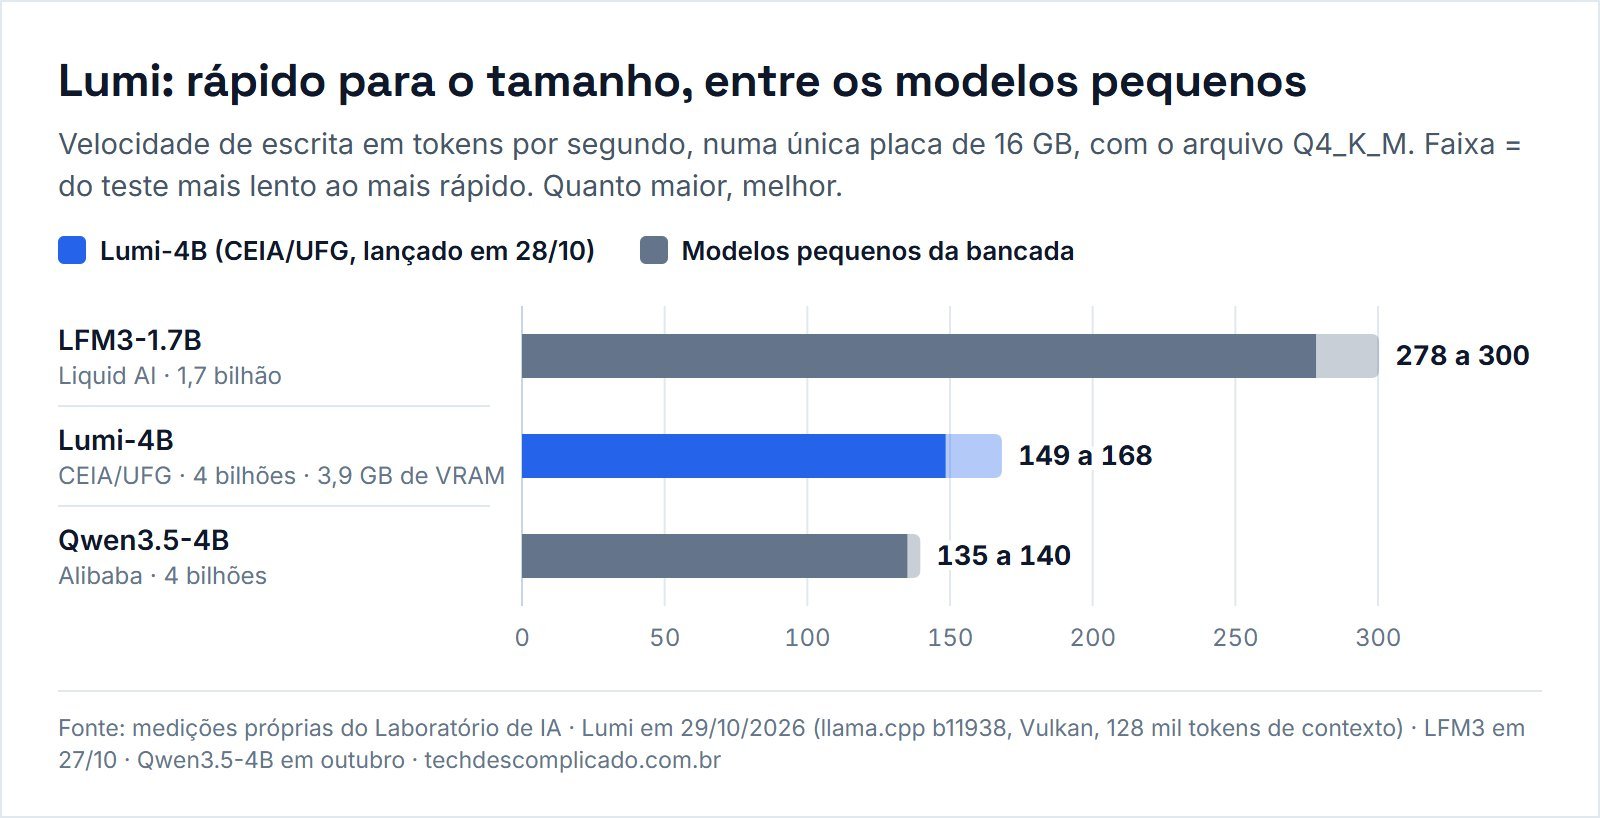
Convertemos o arquivo oficial (BF16) para GGUF com o llama.cpp b11938, comprimimos para Q4_K_M (2,8 GB) e rodamos os 8 testes da bancada numa única Radeon RX 9070 XT de 16 GB, com 128 mil tokens de contexto e o modo de raciocínio ligado, que é o padrão do modelo. O Lumi carregou em 10 segundos e ocupou 3,9 GB de memória de vídeo: cabe com folga numa placa de 6 ou 8 GB.
| Teste | Lumi-4B | Qwen3.5-4B | LFM3-1.7B |
|---|---|---|---|
| Velocidade (tokens/s) | 149 a 168 | 135 a 140 | 278 a 300 |
| Memória de vídeo com 128 mil tokens | 3,9 GB | — | 2,1 GB |
| AGENTE (programar e testar sozinho, 5 casos) | 1 de 5, nenhum caso passou | 3 de 5 | 1 e 2 de 5 |
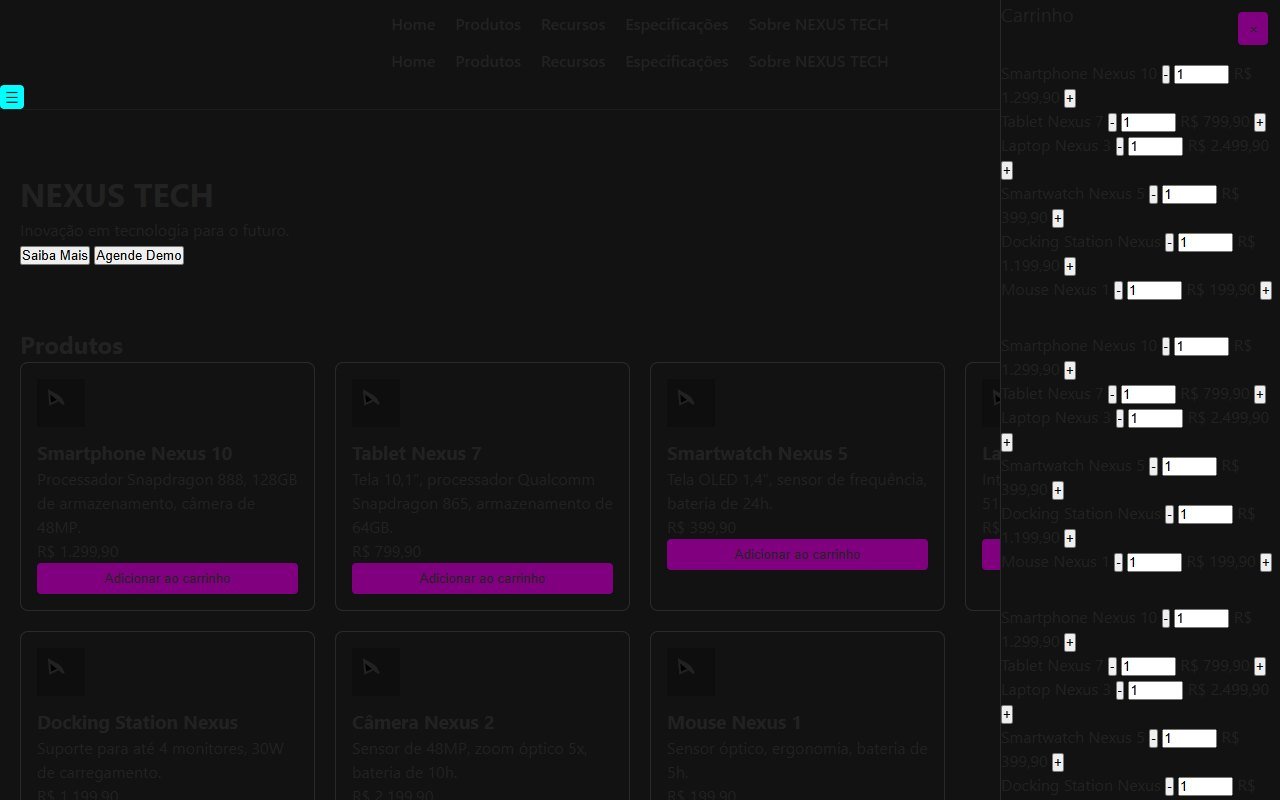
| PULSE e NEXUS (estrutura das páginas) | 10 e 8, abriram com erros | 9 e 10 | 9 e 9 |
| 4 jogos sem ferramentas (estrutura) | 3, 6, 3 e 3; nenhum funcionou | 8, 8, 8 e 6 | 8, 4, 6 e 7; tela vazia |
| FERRAMENTAS (10 tarefas de assistente) | 5 de 10 | ainda não rodou | 7 de 10 |
Onde o Lumi foi bem
O português é correto e natural nas respostas curtas, e ele é rápido para o tamanho: escreve mais depressa que o Qwen3.5-4B, o primeiro colocado no ranking do próprio CEIA, usando pouca memória. Nas tarefas de assistente, acertou a extração de dados em JSON, a conta que não precisava de ferramenta, a tabela ordenada por preço, o resumo e a busca de um dado escondido num texto longo. A loja NEXUS ficou com cara de site de verdade: menu, produtos em cartões e carrinho.
Onde o Lumi errou
Programar ainda não é o forte dele. No teste de agente, em que o modelo precisa escrever um programa, rodar os testes e corrigir, o Lumi não chamou nenhuma ferramenta e terminou sem nenhum caso aprovado, tanto no OMP quanto no OpenCode. Nos jogos, três dos quatro entraram em laço, repetindo código até bater o limite de 81.920 tokens, e o quarto abriu com erro. No PULSE, o painel apareceu com cabeçalho, números e filtros, mas o gráfico e a tabela ficaram vazios.
Nas tarefas de assistente, as falhas foram justamente as que envolvem agir: não chamou a ferramenta do clima, escolheu a ferramenta errada, não juntou dois passos (moeda e frete), errou a classificação de sentimentos e não pediu confirmação antes de excluir uma conta. Em algumas respostas, devolveu só a marcação de raciocínio vazia, sem texto.
Foi o modelo ou a configuração? Refizemos os testes para saber
O CEIA não publicou recomendações de uso. Na primeira rodada, seguimos o arquivo de configuração do repositório (temperatura 1.0, sem filtro de palavras), mas ele traz só os valores automáticos do Hugging Face, não uma indicação do CEIA. Com esses valores, todas as páginas saíram quebradas, algumas em branco e com o “pensamento” do modelo vazando para dentro do código. Por isso refizemos tudo com a configuração que a bancada usa em modelos pequenos sem recomendação (temperatura 0.6, top-p 0.95, top-k 20), a mesma do Qwen3.5-4B.
A troca ajudou nas páginas, que passaram a abrir, mas não mudou o resto: o agente continuou sem chamar ferramentas, e os jogos não funcionaram em nenhuma das rodadas. Desligar o raciocínio piorou tudo. Nas quatro medições do FERRAMENTAS, o Lumi acertou entre 5 e 7 das 10 tarefas de assistente, o que também mostra que as respostas variam bastante de uma execução para outra. Também precisamos contornar um detalhe na conversão: o conversor do llama.cpp confundia o Lumi com a versão MoE do Nemotron-H, e o arquivo não abria. A tabela acima é da rodada oficial, com a configuração padrão da bancada.
Os resultados completos, com as páginas e os jogos que ele gerou, estão no Laboratório de IA.
Como rodar o Lumi no seu PC
O CEIA publicou o Lumi no formato original (BF16, para a biblioteca Transformers, em Python). Ainda não há uma versão pronta para o LM Studio ou o Ollama, que usam o formato GGUF. Fizemos a conversão aqui com as ferramentas do próprio llama.cpp, e o caminho é este:
- Baixe o modelo:
hf download ceia-br/lumi-4b --local-dir CEIA-Lumi-4B(cerca de 8 GB). - Converta para GGUF com o script
convert_hf_to_gguf.pydo llama.cpp. Atenção: com a biblioteca transformers 5.x instalada, o conversor grava o Lumi como Nemotron-H MoE e o arquivo não abre; é preciso fazer o script ler oconfig.jsondo modelo direto. - Comprima para Q4_K_M com o
llama-quantize, o que reduz o arquivo para 2,8 GB. - Rode com o
llama-servere converse pelo navegador. Use temperatura 0.6, top-p 0.95 e top-k 20; com os valores padrão do arquivo de configuração, o código sai quebrado.
Se esses termos são novos para você, comece pelo nosso guia de como rodar IA localmente no PC e pela explicação de o que é GGUF e qual quantização baixar.
O que ainda falta o CEIA informar
A página do modelo é honesta sobre os próprios limites e lista o que ainda não documentou: o modelo-base, os dados e o procedimento completo de treinamento, as recomendações de uso, a licença e as instruções de inferência. Para uma pessoa testando em casa, nada disso impede o uso. Para uma empresa, a licença é o ponto principal: as reportagens do lançamento falam em uso gratuito por empresas, mas, até 29/10, nenhuma licença aparece no repositório, e é ela que define o que pode ou não ser feito com o modelo num produto.
Por que a IA brasileira importa
Um modelo treinado com cuidado para o português entende melhor as nossas expressões, os nossos documentos e o nosso jeito de escrever. Mas o motivo mais forte é outro: quem depende só de IA estrangeira manda os seus dados para fora e paga em dólar por cada pergunta. Um modelo aberto, que roda dentro da empresa ou da prefeitura, resolve as duas coisas de uma vez.
O Lumi não é um caso isolado. O próprio quadro do CEIA traz outros dois modelos brasileiros, o Tucano2 e o Gaia (este também da UFG, lançado em 2025). E há dinheiro público na mesa: o Plano Brasileiro de Inteligência Artificial, apresentado em 2024, prevê cerca de R$ 23 bilhões até 2028, com reforço do supercomputador Santos Dumont para treinar modelos em português.
O que esses projetos mais precisam agora é de uso e de teste independente. Modelo que ninguém roda não melhora. Por isso a nossa bancada existe: medir, com o mesmo critério para todos, o que cada modelo entrega de verdade no computador de quem vai usar.
Tem um modelo de IA? A nossa bancada está aberta
Se você faz parte de uma universidade, de uma startup ou de uma empresa que treina modelos de IA, brasileiros ou não, e quer ver o seu modelo testado de forma independente, fale com a gente pela página de contato. Rodamos os mesmos testes da bancada, inclusive os da especialidade para a qual o modelo foi treinado, e publicamos os resultados no Laboratório de IA, com o que deu certo e o que deu errado. O objetivo é um só: ajudar as pessoas a entender e a se preparar para a inteligência artificial que já está chegando ao dia a dia.
Minha opinião
Quem treina a IA que conversa com você? Até ontem, para quase todo brasileiro, a resposta era uma empresa dos Estados Unidos ou da China. O Lumi não muda isso sozinho, e nem precisa: o que ele mostra é que uma universidade pública consegue colocar no ar um modelo pequeno, aberto e competitivo, nos testes de conhecimento em português, com os de empresas gigantes do mesmo tamanho.
Eu gostaria de ver duas coisas nas próximas semanas: a licença publicada e uma versão em GGUF oficial, para o modelo chegar a quem usa LM Studio e Ollama. São detalhes que parecem burocracia, mas decidem se um projeto vira ferramenta ou fica como notícia.
Perguntas frequentes
O que é o Lumi da UFG?
Um modelo de linguagem aberto, com 4 bilhões de parâmetros, criado pelo CEIA da Universidade Federal de Goiás para o português e o contexto brasileiro. Foi lançado em 28/10/2026.
O Lumi é gratuito?
O download é gratuito no Hugging Face. As reportagens do lançamento falam em uso gratuito por empresas, mas a licença ainda não foi publicada no repositório.
O Lumi roda no meu computador?
Roda. Convertido para GGUF e comprimido em Q4_K_M (2,8 GB), usou 3,9 GB de memória de vídeo na nossa bancada com 128 mil tokens de contexto, então cabe em placas de 6 ou 8 GB.
O Lumi é melhor que o ChatGPT?
Não é a comparação certa. O Lumi é um modelo pequeno, para rodar localmente e ser adaptado; o ChatGPT usa modelos centenas de vezes maiores, na nuvem. Entre os modelos pequenos, o CEIA o coloca em segundo lugar nos testes em português.
Existem outras IAs brasileiras?
Sim. Entre os modelos abertos citados no próprio comparativo do CEIA estão o Tucano2 e o Gaia, também da UFG.
Você usaria uma IA brasileira no trabalho ou em casa? Conta aqui nos comentários.
Resumo
- Lumi: IA brasileira aberta de 4B, do CEIA/UFG, lançada em 28/10/2026.
- Nos testes do CEIA em português, segundo lugar entre 9 modelos pequenos (44,8), atrás do Qwen3.5-4B.
- Na nossa bancada: rápido (149 a 168 tokens/s) e leve (3,9 GB), 5 de 10 tarefas de assistente, páginas com erros e nenhum jogo funcionando.
- Ainda faltam a licença e o modelo-base na página oficial.
Veja também o nosso teste do LFM3, o modelo de 1 GB da Liquid AI, rodado no dia do lançamento.
Fontes
- Hugging Face: ceia-br/lumi-4b (repositório oficial, ficha e avaliação)
- Brasil em Folhas: UFG desenvolve primeira IA open source adaptada ao Brasil (28/10/2026)
- Jornal Opção: UFG lança modelo gratuito de inteligência artificial para empresas
- Teletime: Plano de Inteligência Artificial prevê R$ 23 bi para a tecnologia no Brasil (30/07/2024)
- Medições próprias: bancada do Laboratório de IA, 29/10/2026 (llama.cpp b11938, Vulkan, RX 9070 XT 16 GB, Q4_K_M, 128 mil tokens de contexto, temperatura 0.6).