Uma ou duas placas de vídeo para IA? Quem roda modelos no próprio PC costuma achar que a segunda placa deixa tudo mais rápido, já que soma memória. Na nossa bancada, medimos o contrário: quando o modelo cabe inteiro numa placa só, uma placa escreveu de 41% a 2,5 vezes mais rápido que duas, com o mesmo arquivo e a mesma configuração. A segunda placa continua útil, mas para outra coisa: fazer caber o que não cabe.
Testamos dois modelos bem diferentes, um do tipo MoE (a Gemma 4 26B) e um denso (o Qwen3.8 27B), na RX 9070 XT sozinha e na dupla RX 9070 XT + Intel Arc B580. Abaixo, os números, o porquê, a armadilha que derruba a velocidade sem avisar e como decidir se vale a pena comprar a segunda placa.
Duas placas de vídeo deixam a IA mais rápida?
Na maioria dos casos de uso em casa, não. Duas placas deixam rodar modelos maiores, porque somam memória de vídeo (VRAM). Mas elas não trabalham ao mesmo tempo no mesmo pedaço de texto: o modelo é dividido em camadas, uma parte fica em cada placa, e cada palavra gerada passa pela primeira placa, depois pela segunda, em fila. O tempo final é a soma das duas etapas, mais a troca de dados entre elas.
É como uma linha de montagem com dois funcionários, em que um deles é mais lento: o produto sai no ritmo do conjunto, e não do mais rápido. Na nossa bancada, o funcionário mais lento é a Arc B580, que tem memória mais lenta que a da RX 9070 XT. Para IA, velocidade de memória é quase tudo, porque o modelo precisa ler os próprios pesos a cada palavra.
Como testamos: o mesmo modelo em uma e em duas placas
A regra foi mudar só uma coisa: o número de placas. Mesmo arquivo do modelo, mesmo tamanho de conversa (contexto), mesmo tipo de compressão da memória da conversa, mesmo programa (llama.cpp com Vulkan) e os mesmos testes do Laboratório de IA: a página PULSE, o jogo VOO LIVRE e uma rodada de correção do jogo, com a mesma conversa nos dois casos. O monitor ficou ligado na RX 9070 XT, como no dia a dia.
| Gemma 4 26B | Qwen3.8 27B | |
|---|---|---|
| Tipo | MoE: 26 bilhões de parâmetros, 4 bilhões ativos por palavra | Denso: os 27 bilhões trabalham a cada palavra |
| Arquivo | UD-Q4_K_XL (QAT), 14,25 GB | UD-IQ3_XXS, 10,93 GB |
| Contexto | 42 mil tokens nas duas configurações | 64 mil tokens nas duas configurações |
| Aceleração | Sem MTP (neste modelo, deixava mais lento) | MTP ligado (prevê até 4 palavras por vez) |
| Divisão nas 2 placas | 3:2 (60% na RX) | 4:3 (57% na RX) |
Os dois modelos têm configurações diferentes entre si, porque cada um foi ajustado para render o máximo. Por isso, a comparação que vale é de cada modelo com ele mesmo, e não um contra o outro.
Resultado na Gemma 4 26B (MoE): de 41% a 90% mais rápida numa placa
| Medida (tokens por segundo) | 1 placa | 2 placas | Ganho de 1 placa |
|---|---|---|---|
| Escrita, conversa vazia (llama-bench) | 156 | 111 | +41% |
| Escrita com 8 mil tokens na conversa | 140 | 89 | +56% |
| Escrita com 16 mil tokens na conversa | 132 | 80 | +66% |
| Escrita com 32 mil tokens na conversa | 119 | 63 | +90% |
| Leitura do pedido, conversa vazia | 4.155 | 2.770 | +50% |
| Leitura do pedido com 32 mil na conversa | 766 | 279 | 2,7 vezes |
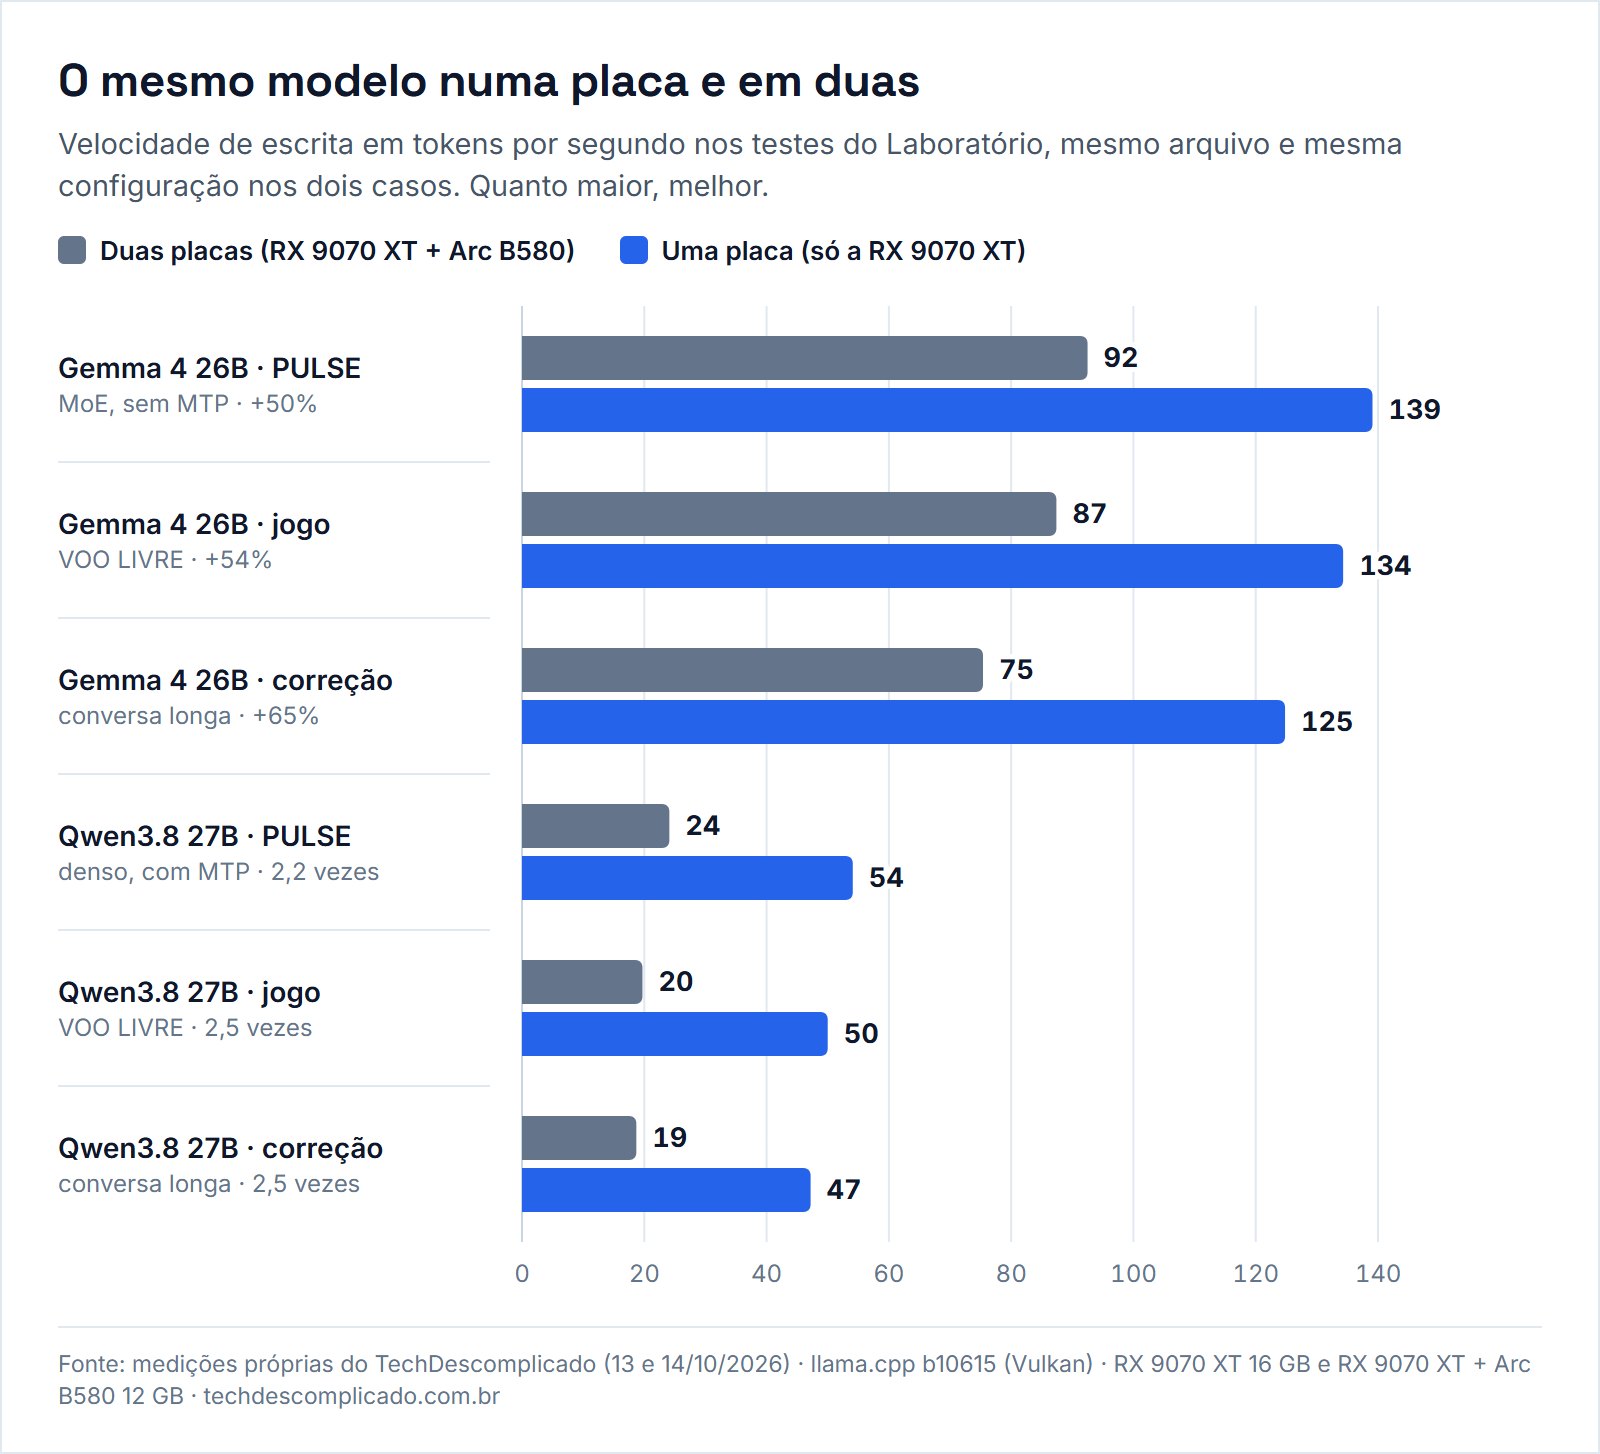
| Página PULSE | 139 | 92 | +50% |
| Jogo VOO LIVRE | 134 | 87 | +54% |
| Rodada de correção do jogo | 125 | 75 | +65% |
O detalhe mais importante está nas linhas do meio: a vantagem da placa única cresce conforme a conversa aumenta. Com a conversa vazia, ela é 41% mais rápida; com 32 mil tokens de histórico, quase o dobro. Quanto mais a IA precisa consultar a memória da conversa, mais pesa a placa lenta na fila.
Resultado no Qwen3.8 27B (denso): até 2,5 vezes mais rápido numa placa
| Teste (tokens por segundo, com MTP) | 1 placa | 2 placas | Ganho de 1 placa |
|---|---|---|---|
| Página PULSE | 54,1 | 24,1 | 2,2 vezes |
| Jogo VOO LIVRE | 50,0 | 19,7 | 2,5 vezes |
| Rodada de correção do jogo | 47,2 | 18,7 | 2,5 vezes |
| Sem MTP (llama-bench, tokens por segundo) | 1 placa | 2 placas | Ganho de 1 placa |
|---|---|---|---|
| Escrita, conversa vazia | 36,7 | 22,2 | +65% |
| Escrita com 32 mil tokens na conversa | 33,2 | 17,3 | +92% |
| Leitura do pedido, conversa vazia | 762,9 | 681,8 | +12% |
| Leitura do pedido com 32 mil na conversa | 581,6 | 250,7 | 2,3 vezes |
Sem o MTP, a placa única do Qwen já escreve de 65% (conversa vazia) a 92% (32 mil tokens de conversa) mais rápido, um padrão parecido com o da Gemma. Com o MTP ligado, a vantagem sobe para 2,2 a 2,5 vezes. Na leitura do pedido com a conversa vazia, a diferença é pequena (12%), mas com 32 mil tokens de histórico a placa única lê 2,3 vezes mais rápido.
No modelo denso, a diferença é ainda maior. Faz sentido: um modelo denso lê todos os seus pesos a cada palavra, então a parte que fica na placa mais lenta pesa em todos os passos. O MTP, a técnica que prevê várias palavras de uma vez e depois confere, também precisa atravessar as duas placas a cada conferência. Essa é a nossa leitura dos números; o fato medido é que a mesma configuração rodou bem mais rápido numa placa só.
Um cuidado honesto: para caber numa placa de 16 GB com folga para a conversa, usamos a versão mais comprimida do Qwen (IQ3_XXS, 10,93 GB). No Laboratório, o Qwen3.8 27B está publicado na versão Q4, de 17,56 GB, que não cabe numa placa só e tem mais qualidade. Comprimir mais é trocar um pouco de qualidade por velocidade, e essa troca nós não medimos neste teste.
A armadilha: o modelo “quase” cabe e a velocidade despenca
Se o modelo passa só um pouco do tamanho da placa, o Windows coloca o excesso na memória RAM do PC sem avisar, e a velocidade cai muito. Na Gemma 4 26B, com uma conversa de 64 mil tokens, tudo coube na RX 9070 XT e o jogo rodou a 134 tokens por segundo. Com 80 mil tokens, sobraram só 0,27 GB para fora, e o mesmo jogo caiu para 34 tokens por segundo, quatro vezes mais lento.
| Gemma 4 26B em 1 placa | Na placa | Na RAM do PC | Velocidade no jogo |
|---|---|---|---|
| Conversa de 64 mil tokens | 14,41 GB | 0,08 GB | 134 tokens/s |
| Conversa de 80 mil tokens | 14,42 GB | 0,27 GB (0,34 durante o jogo) | 34 tokens/s |
Para conferir no seu PC: abra o Gerenciador de Tarefas, vá em Desempenho, clique na placa de vídeo e olhe a linha “Memória compartilhada da GPU” com o modelo carregado. Se ela subir mais do que alguns centésimos de GB, parte do modelo foi para a RAM. Diminua o tamanho da conversa (contexto) no LM Studio, no Ollama ou no llama.cpp até o número voltar perto de zero. E lembre que o monitor ligado na placa também ocupa memória: na nossa RX, cerca de 1,3 GB.
Quando duas placas de vídeo para IA valem a pena
A segunda placa compensa quando o modelo, ou a conversa que você precisa, não cabe numa placa só. Foi o que vimos nos mesmos dois modelos:
- Conversa longa: a Gemma 4 26B cabe numa placa com 64 mil tokens de contexto; nas duas, roda com 144 mil, a cerca de 81 tokens por segundo. Para agente e documento grande, essa é a escolha.
- Modelo maior ou menos comprimido: o Qwen3.8 27B na versão Q4 (17,56 GB) só roda nas duas placas, com mais qualidade e menos velocidade.
- Modelos gigantes do tipo MoE: dividem bem entre placas e RAM, como mostramos no artigo do llama.cpp com duas placas de vídeo.
Antes de comprar a segunda placa, faça a conta do tamanho: arquivo do modelo + memória da conversa + uma folga de 1 a 2 GB. Se couber numa placa, ela será mais rápida. Se você ainda vai escolher a primeira placa, o guia de quanta VRAM a placa precisa para IA local e o de placa de vídeo para IA custo-benefício ajudam mais do que a soma de memórias.
O olhar de QA
A Arc B580 não é a vilã desta história. Ela é uma boa placa de entrada e continua essencial na bancada para rodar o que não cabe na RX. O que este teste mostrou foi uma suposição errada que provavelmente a maioria das pessoas faz! E eu tinha as minhas dúvidas também: “mais placas = mais velocidade, ou a mesma velocidade com mais VRAM?” Em teste de software, chamamos isso de hipótese não verificada, e a correção é sempre a mesma: mudar uma variável por vez e medir. Também me chamou atenção a armadilha dos 0,27 GB. Nossa regra antiga aceitava até 0,3 GB na RAM como “cabe”, e foi justamente essa margem que escondeu uma queda de quatro vezes. Hoje a regra da bancada é no máximo 0,2 GB, e eu recomendaria a mesma desconfiança a quem roda IA em casa: olhe a memória compartilhada antes de culpar o modelo pela lentidão.
Perguntas frequentes sobre uma ou duas placas de vídeo para IA
Duas placas de vídeo deixam a IA mais rápida?
Normalmente não. Elas somam memória para rodar modelos maiores, mas o modelo é dividido em fila entre as placas. Na nossa bancada, com o modelo cabendo numa placa só, ela escreveu de 41% a 2,5 vezes mais rápido que as duas juntas.
Vale a pena comprar uma segunda placa de vídeo para IA?
Vale quando o modelo ou a conversa que você precisa não cabe numa placa. Se cabe, uma placa só é mais rápida. Antes de comprar, some o arquivo do modelo, a memória da conversa e 1 a 2 GB de folga.
Posso usar duas placas de vídeo diferentes para IA, AMD e Intel?
Pode, com o llama.cpp usando Vulkan, que trata as duas como iguais. A nossa bancada usa uma RX 9070 XT e uma Arc B580 juntas. O ritmo do conjunto fica limitado pela placa de memória mais lenta.
Como saber se o modelo cabe na VRAM?
Carregue o modelo e olhe no Gerenciador de Tarefas a “Memória compartilhada da GPU”. Se subir mais do que alguns centésimos de GB, parte foi para a RAM e a velocidade cai. Reduza o contexto até voltar perto de zero.
Por que o modelo fica lento quando passa um pouco da VRAM?
Porque o excesso vai para a memória RAM do PC, que é muito mais lenta para a placa acessar. Na Gemma 4 26B, só 0,27 GB fora da placa derrubaram o jogo de 134 para 34 tokens por segundo.
O que é MTP?
É uma técnica em que o modelo prevê várias palavras de uma vez e depois confere se acertou. Em modelos densos, como o Qwen3.8 27B, ela acelera bastante; na Gemma 4 26B, um modelo MoE, deixou mais lento na nossa bancada.
Você tem duas placas no PC? Já conferiu se o seu modelo cabe numa só? Conta aqui nos comentários.
Resumo
- Testamos a Gemma 4 26B (MoE) e o Qwen3.8 27B (denso) com o mesmo arquivo em 1 e 2 placas (RX 9070 XT e RX 9070 XT + Arc B580).
- Na Gemma, uma placa foi de 41% (conversa vazia) a 90% (32 mil tokens de conversa) mais rápida.
- No Qwen com MTP, a placa única fez 54,1 contra 24,1 tokens/s na PULSE e 50,0 contra 19,7 no jogo.
- Passar só 0,27 GB do tamanho da placa derrubou a Gemma de 134 para 34 tokens/s: confira a “Memória compartilhada da GPU”.
- A segunda placa vale para conversa longa (144 mil tokens) e modelos maiores, não para ganhar velocidade.