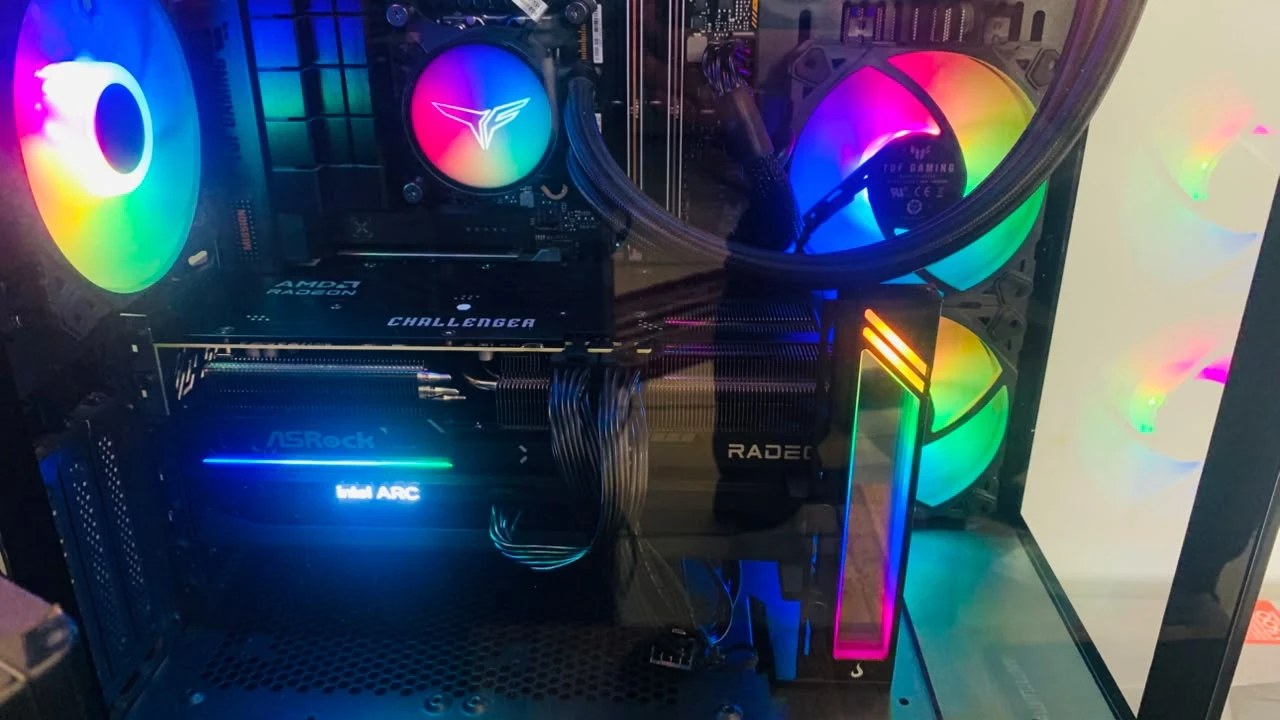
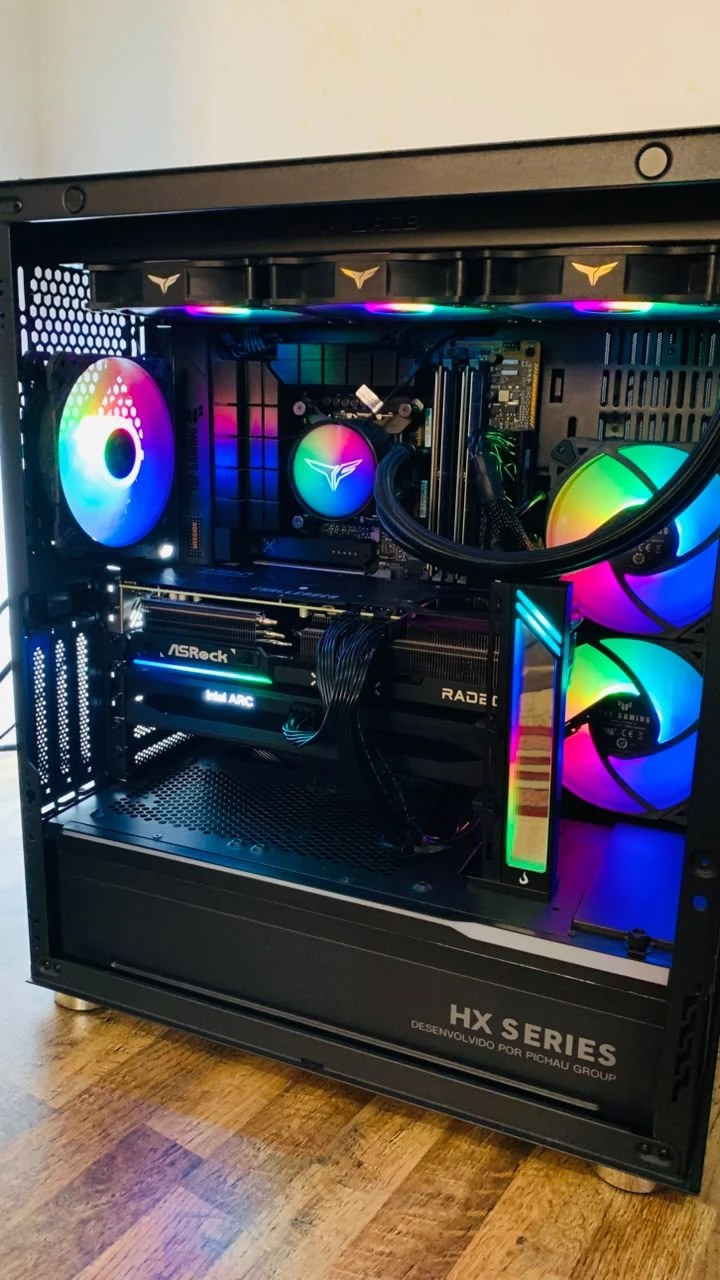
Dá para rodar o llama.cpp com duas placas de vídeo, inclusive de marcas diferentes. A nossa bancada usa uma AMD Radeon RX 9070 XT (16 GB) junto com uma Intel Arc B580 (12 GB), somando cerca de 28 GB de VRAM para os modelos de IA. O segredo é usar o backend Vulkan e dizer ao llama.cpp quanto do modelo vai para cada placa.
Este é um tutorial para quem já roda modelos locais e quer ir além de uma placa. Vou mostrar os comandos que usamos todo dia, os números que medimos e as armadilhas que custaram horas para descobrir. Se você quer ver primeiro os resultados de desempenho do hardware, eles estão no texto da RX 9070 XT com a Arc B580 de reforço.
Por que o llama.cpp precisa do Vulkan para usar duas placas de vídeo de marcas diferentes
O llama.cpp tem vários “backends”, que são as pontes entre o programa e a placa de vídeo. O CUDA só fala com NVIDIA, o ROCm só com AMD e o SYCL só com Intel. O Vulkan é o único que enxerga as duas marcas ao mesmo tempo, porque é um padrão aberto que os drivers da AMD e da Intel implementam. Então, para misturar marcas, baixe a versão do llama.cpp com Vulkan (no Windows, o pacote bin-win-vulkan-x64 das releases oficiais).
Passo 1: descubra como o llama.cpp vê as suas placas
Antes de tudo, liste os dispositivos. Esse comando mostra o nome de cada placa e quanta memória ela tem:
llama-server --list-devicesNa nossa bancada, a resposta é Vulkan0 para a RX 9070 XT e Vulkan1 para a Arc B580. A ordem importa: é nela que você vai distribuir o modelo no próximo passo.
Passo 2: divida o modelo com o –tensor-split
O modo padrão do llama.cpp com várias placas se chama layer (camadas): cada placa guarda uma fatia contínua das camadas do modelo, e a memória de contexto (o KV cache) de cada camada fica na mesma placa. O --tensor-split diz a proporção. Com 4,3, a primeira placa recebe 4 partes e a segunda, 3.
llama-server --model modelo.gguf --gpu-layers all --tensor-split 4,3 --flash-attn on --ctx-size 65536A regra que funcionou para nós: siga a proporção real da memória das placas. 16 GB contra 12 GB é praticamente 4 para 3. Nos primeiros testes com o Qwen3.6-35B-A3B (com outra configuração, antes da padronização dos nossos launchers), a diferença foi grande:
| –tensor-split | O que aconteceu |
|---|---|
| 3,2 | começou em 42 tokens por segundo e foi caindo até 27 (desbalanceado) |
| 4,1 | 35 tokens por segundo estáveis, mas com 5 GB transbordando da placa |
| 4,3 | 53 a 58 tokens por segundo, estável, sem transbordar |
Hoje, com os launchers ajustados, o mesmo modelo passa de 95 tokens por segundo nas duas placas. O 4,3 continua sendo o nosso padrão para quase todos os modelos.
Passo 3: deixe folga na VRAM (a armadilha mais cara)
No Windows, quando a placa enche, o driver não dá erro: ele empurra o excedente para a memória RAM, que é muito mais lenta. O modelo carrega normalmente e só fica devagar, o que é difícil de perceber. Aconteceu com a gente várias vezes. Com o Qwen3-Coder-Next 80B, por exemplo, mandar menos partes do modelo para a RAM (para “caber mais”) deixou tudo mais lento: 21,6 tokens por segundo, contra 31,5 com mais folga na placa.
Como conferir: abra o Gerenciador de Tarefas › Desempenho › GPU e olhe a “Memória compartilhada da GPU” depois de carregar o modelo. Se ela cresce quando você aumenta o contexto, a placa já está cheia. Nesta madrugada mesmo, na bateria de testes do Laboratório, o Qwen3.6 com 160 mil tokens de contexto deixou a RX 9070 XT sem espaço e a nossa automação baixou sozinha para 128 mil.
Passo 4: modelos maiores que as duas placas (MoE)
Nos modelos do tipo MoE (mistura de especialistas), só uma parte pequena dos pesos trabalha em cada palavra. O llama.cpp deixa mandar os especialistas de algumas camadas para a RAM com o --n-cpu-moe, e o resto fica nas placas:
llama-server --model coder-next.gguf --gpu-layers all --tensor-split 38,10 --n-cpu-moe 30 --threads 6Foi assim que rodamos o Qwen3-Coder-Next, de 46 GB, nos nossos 28 GB de VRAM. Procure o menor número de --n-cpu-moe que ainda cabe com folga: daí para cima, cada camada a mais na RAM deixa o modelo mais lento. Em modelos densos (que usam todos os pesos em toda palavra) essa opção não ajuda.
E o PCIe x4 da segunda placa?
Na maioria das placas-mãe comuns, o segundo slot de vídeo tem tamanho de x16, mas só 4 linhas ligadas (x4). Na nossa, a Arc B580 está num slot assim. Parece um gargalo, mas no modo layer só passam entre as placas os resultados intermediários de uma camada para a outra, não o modelo inteiro. A documentação do llama.cpp diz que esse modo “tolera conexões lentas entre as GPUs”. O modo tensor, experimental, divide cada camada entre as placas e aí sim depende muito da velocidade da conexão; a própria documentação avisa que o bom desempenho dele é garantido só em várias placas NVIDIA com CUDA.
Armadilhas que custaram horas
- MTP e visão não andam juntos: a previsão de vários tokens (MTP) acelera alguns modelos, mas não funciona junto com o módulo de imagens (
--mmproj). E o servidor carrega o módulo de imagem sozinho se achar o arquivo na pasta: no launcher com MTP, coloque--no-mmproj. - Visão gasta VRAM que você talvez não use: o módulo de imagem ocupa perto de 1 GB. Se o seu uso é só texto e código, desligar libera espaço para contexto.
- –flash-attn precisa de valor: nas versões novas, escreva
--flash-attn on. Sem o “on”, ele engole o argumento seguinte. - Arquivo .bat com acento: um único caractere acentuado, até num comentário, bagunça o arquivo inteiro no Prompt de Comando. Escreva os .bat só com letras sem acento.
- Controle Inteligente de Aplicativos do Windows 11: ele bloqueou o
llama-server.exe, que não tem assinatura digital. Se o servidor não abre sem motivo, confira essa proteção.
Vale a pena juntar duas placas de marcas diferentes?
Para mim valeu, e o motivo vai além da bancada. Trabalhando com tecnologia, como desenvolvedor e QA, eu vejo os planos pagos de IA ficando mais caros e com limites menores, as próprias empresas de IA ainda longe do lucro (falei disso no texto sobre a bolha da IA) e o preço de placa de vídeo e memória subindo. Ter hardware próprio e modelos gratuitos rodando em casa é o meu seguro: se usar IA paga ficar caro demais, o meu trabalho continua andando.
Por isso, sim, eu colocaria uma segunda placa, ou até uma terceira, para somar VRAM e rodar modelos cada vez maiores dependendo menos de assinatura. Vejo como investimento: a IA já entrou no dia a dia de todo mundo e não tem volta.
Só que a marca é o que menos pesa nessa escolha. Na nossa bancada, AMD e Intel juntas rodaram bem num PC doméstico, então o que eu comparo é o custo-benefício: preço por GB de VRAM, largura de banda da memória e poder de processamento, seja NVIDIA, AMD ou Intel. Antes de comprar, confira se a placa-mãe e a fonte aguentam mais uma placa e se o ganho vai fazer diferença no seu trabalho. Para essa conta, o texto sobre quanta VRAM você precisa para IA local ajuda a decidir, e o comparativo com o mini PC Strix Halo mostra outro caminho.
Perguntas frequentes
É possível usar duas placas de vídeo ao mesmo tempo para IA?
Sim. O llama.cpp divide o modelo entre as placas automaticamente no modo padrão (layer). Com marcas diferentes, como AMD e Intel, use a versão com Vulkan e ajuste a proporção com --tensor-split.
O que é o llama.cpp?
É um programa gratuito e de código aberto que roda modelos de inteligência artificial no seu próprio computador, usando a placa de vídeo, o processador ou os dois. Ele usa arquivos no formato GGUF, os mais comuns para IA local.
Qual placa-mãe suporta duas placas de vídeo?
Qualquer uma com dois slots PCIe de tamanho x16 e espaço físico para as duas placas, além de uma fonte que aguente o consumo somado. O segundo slot costuma ser x4 elétrico, o que no modo layer do llama.cpp faz pouca diferença.
Preciso de placas iguais?
Não. Placas de tamanhos e marcas diferentes funcionam; você só ajusta a proporção do --tensor-split para a memória de cada uma.
Fontes
- llama.cpp: Using multiple GPUs with llama.cpp (documentação oficial)
- llama.cpp: releases oficiais (pacotes com Vulkan para Windows)
- llama.cpp: como compilar e o backend Vulkan (documentação oficial)
- Medições próprias da bancada do Laboratório de IA do TechDescomplicado (setembro e outubro de 2026)